ライフスタイル
旅とは別の話題:AIツールとチュートリアル、ソフト、ガジェット、日々の記録。
テーマから探す
すべての記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
検索拡張生成(RAG)とは:回答に検証できる根拠を添える
検索拡張生成は、まず外部データから関連する内容を探し、それを言語モデルに渡して回答を組み立てます。この記事ではイベントの申込規約に関する質問応答を例に、インデックス作成、検索、生成、出典確認を分解し、検索やファインチューニングとの違い、引用があっても誤答する理由を説明します。読めば、原因がデータの更新漏れ、文書の検索漏れ、モデルによる根拠の過剰解釈のどこにあるかを判断でき、どのような場合に「わからない」という回答を保つべきかもわかります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
再ランキング(Reranking):見つける段階から、良い回答を上位に並べる段階へ
再ランキングは、初回検索で得た候補の関連性を改めて評価し、検索結果の一覧や RAG のコンテキストの品質を改善するためによく使われます。本記事では図書館の貸出規則を例に、検索器とクロスエンコーダーの役割分担を示し、候補の漏れ、入力の切り詰め、関連性スコアと真偽の判定の違いを説明します。検索範囲の拡大、チャンクの修正、再ランキングの追加のどれが必要かを見極め、適切なテストで順位改善のための不要な待ち時間を避けられるようになります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
セマンティック検索(Semantic Search):異なる言い方で関連する内容を見つける
セマンティック検索は、同じ語句の一致だけでなく、クエリと内容の意味に基づいて情報を探す手法です。この記事では、よくある問い合わせを例に、クエリの符号化、文書の表現、候補の順位付けを説明し、意味の類似と実際にニーズを満たすことの違いを示します。否定文、固有のコード、言語をまたぐ検索、答えのない質問への限界も紹介します。読み終えると、検索の問題を埋め込みモデル、データ整理、ハイブリッド検索、リランキングのどこから改善すべきか判断でき、自然言語の回答を検索そのものと取り違えずに済みます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
埋め込みベクトル(Embedding)とは:内容を比較可能な空間に配置する
埋め込みベクトルは、モデルがテキストなどの内容を数値の組に変換して表す方法で、意味検索、分類、クラスタリングによく使われます。本記事では「雨の日はどこに行ける」というクエリを使い、エンコード、類似度、候補の取得を解説します。ベクトル間の距離は真偽を示さず、各次元にも直接名前を付けられるとは限らないことを説明し、モデルのバージョン、言語能力、長文の切り捨てによる影響も紹介します。埋め込みベクトル、ベクトルデータベース、回答生成がそれぞれ何を担うのかを理解できます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
ゼロショットプロンプティング(Zero-shot Prompting)とは:まずタスクを明確に伝える
ゼロショットプロンプティングとは、解答例を示さず、ルールと新しいデータを使ってモデルに直接作業を依頼する方法です。ゼロショットは、モデルが未訓練であることや、プロンプトに資料を添えられないことを意味しません。本記事では家電の説明書を整理する例を通じて、出力項目、情報の欠落、判断範囲を明確にする書き方を説明し、フューショットプロンプティングと検索資料の用途の違いを比較します。比較表とテスト手順も掲載し、直接質問するだけで十分な場合と、例を追加すべき場合を解説します。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
マルチモーダル AI(Multimodal AI)とは:画像・音声・テキストを一緒に理解する
マルチモーダル AI は、テキスト、画像、音声、動画など、複数の情報形式を扱えます。ただし、複数の入力に対応していても、あらゆる形式で出力できるとは限りません。本記事では収納ラックの組み立てを例に、画像とテキストの補完関係、ネイティブな統合と処理を連携させる方式の違い、画像を見ても細部を読み落とす理由を説明します。入力の工夫と相互照合の方法も紹介し、モデルが画像を根拠に答えているのか、もっともらしい推測を見えた事実として扱っているのかを判断する手助けをします。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
フューショットプロンプティング(Few-shot Prompting)とは:例で形式を明確に伝える
フューショットプロンプティングは、同じ入力内に少数の例を入れ、モデルに例に沿って新しいデータを処理させる方法です。モデルの再学習とは異なります。この記事では落とし物情報の分類を題材に、モデルが表面的な言い回しだけをまねしないよう、通常例、境界例、情報不足の例を選ぶ方法を解説します。テスト方法、比較表、オリジナル図解を交え、例を増やすべき場合、先に分類ルールを直すべき場合、例示用データと検証用データを分ける必要がある理由を説明します。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
ファインチューニング(Fine-tuning):既存のモデルを自分のタスクに合わせる
ファインチューニングは、既存のモデルに追加学習を行い、特定のタスクや分野に適するようにする手法です。本記事では、カスタマーサポートのメール分類を例に、データ整理、パラメータ更新、テストセットの確保、バージョンのデプロイを解説します。フルファインチューニング、LoRA、教師ありファインチューニング、RAG の違いと、学習成績が良くなっても実際の性能が下がる理由も説明します。読み終えると、ファインチューニングを行う価値がある問題かどうかを判断し、形式の一貫性、未知の種類、データリーク、既存の能力の低下を確認する方法がわかります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
トークン化(Tokenization)とは:テキストをモデルに渡す前の分割
トークン化は、生のテキストをトークンと ID に変換する処理であり、中国語の文を文法上の単語に分けることとは異なります。朝食店の商品名を整理する例から、語彙表、サブワード、空白、正規化が結果に与える影響を説明し、BPE、Unigram とトークン化ツールの役割を区別します。繁体字中国語、複数言語の混在、珍しい記号の確認方法も紹介。問題がテキストの分割、モデルの理解、ファイルの読み込みのどの段階にあるかを判断できるようになります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
基盤モデル(Foundation Model)とは
基盤モデルとは、幅広いデータで訓練され、さまざまな下流タスクに適応できるモデルです。単にパラメータが多いことを指すわけではなく、完成されたチャット製品とも異なります。本記事では Stanford CRFM の用法を出発点に、地域のサービス窓口に届く問い合わせの分類・要約・検索を例として、共通モデルが異なるアプリケーションの出発点になる仕組みを説明し、大規模言語モデル、生成 AI、オープンウェイトとの違いを整理します。モデルの能力、用途への適応、実際の導入の境界を見分けられるようになります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
教師ありファインチューニング(SFT):良い例でモデルにタスクの実行を教える
教師ありファインチューニングは、入力と期待する出力を訓練例として使い、既存のモデルにより安定したタスクの振る舞いを学習させます。本記事では、会議のタスク整理を例に、データの対応付け、会話のロール、損失計算、テスト用データの確保を説明し、SFT、フューショットプロンプティング、LoRA、選好最適化を区別します。また、例に含まれる推測や形式の誤りまで学習される仕組みも解説します。読後には、訓練データがモデルに不明な情報を不明のまま残すことを教えているのか、単に見た目を整えることだけを教えているのかを確認できます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
過学習(過適合、Overfitting)とは:過去問は全問正解、新しい問題では誤答
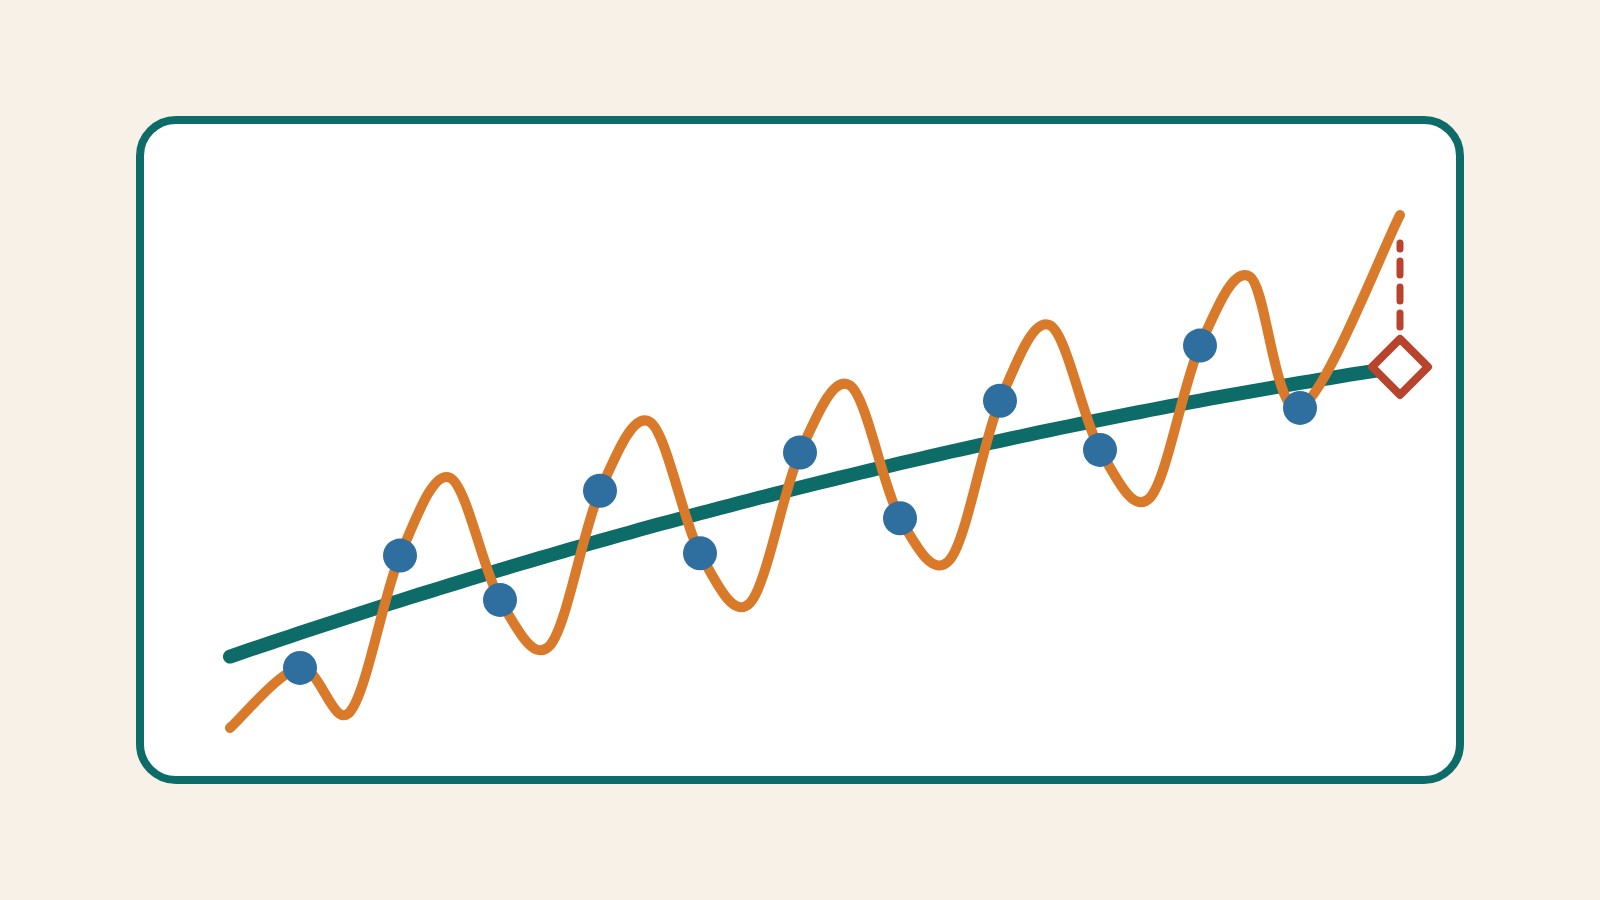
過学習とは、モデルが訓練データのノイズや例外まで学んでしまうことです。訓練ではほぼ全問正解でも、未知のデータでは精度が落ちます。誤差曲線の例で訓練・検証・テストセットの役割を説明し、学習不足との違いや、データの追加、正則化、dropout、早期終了などの対策を整理します。深層ネットワークがランダムなラベルを暗記できるという研究や、ベンチマークの問題流出によって「できるように見える」現象も解説します。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
モデルパラメータ(Model Parameters)とは
モデルパラメータは、入力を出力に変換するために学習時に調整される数値で、重みやバイアスなどがあります。この記事では簡単な式を使って、パラメータが予測にどう影響するかを説明し、モデルパラメータ、学習のハイパーパラメータ、プロンプト、生成設定を区別します。また、パラメータ数、数値精度、アクティブパラメータ数が異なる指標である理由も解説します。モデルの仕様をより正確に読み取り、パラメータが増えても知識が一件ずつ増えるわけではなく、チャットのたびにモデルを学習し直すわけでもないことを理解できます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
推論(Inference)とは:モデルの学習後、回答するたびに行われる計算
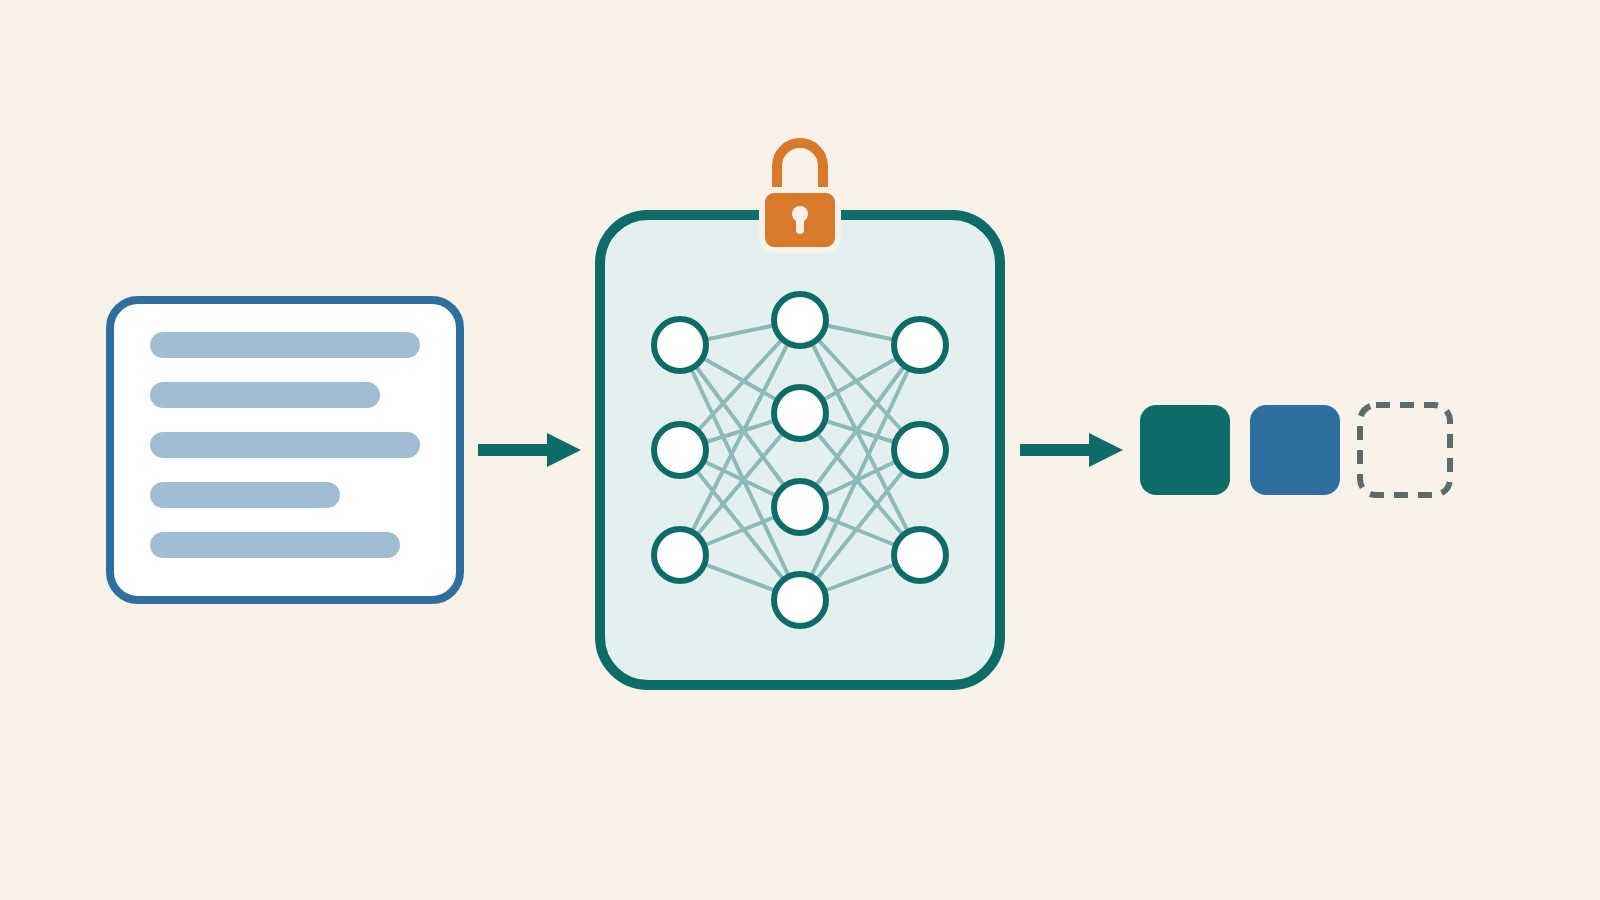
推論は、学習済みのモデルで新しい入力を処理し、出力を生成する過程で、この段階では重みは固定されています。言語モデルの推論をプロンプトの読み込み(prefill)と逐次生成(decode)の二段階に分け、最初の token までの時間、回答完了までの時間、スループットの違いを説明します。推論(inference)と推理(reasoning)、クラウドとローカルを区別し、バッチ処理、量子化、キャッシュがそれぞれ何を節約するのかを解説します。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
事前学習(Pretraining):モデルの基礎能力はどこから来るのか
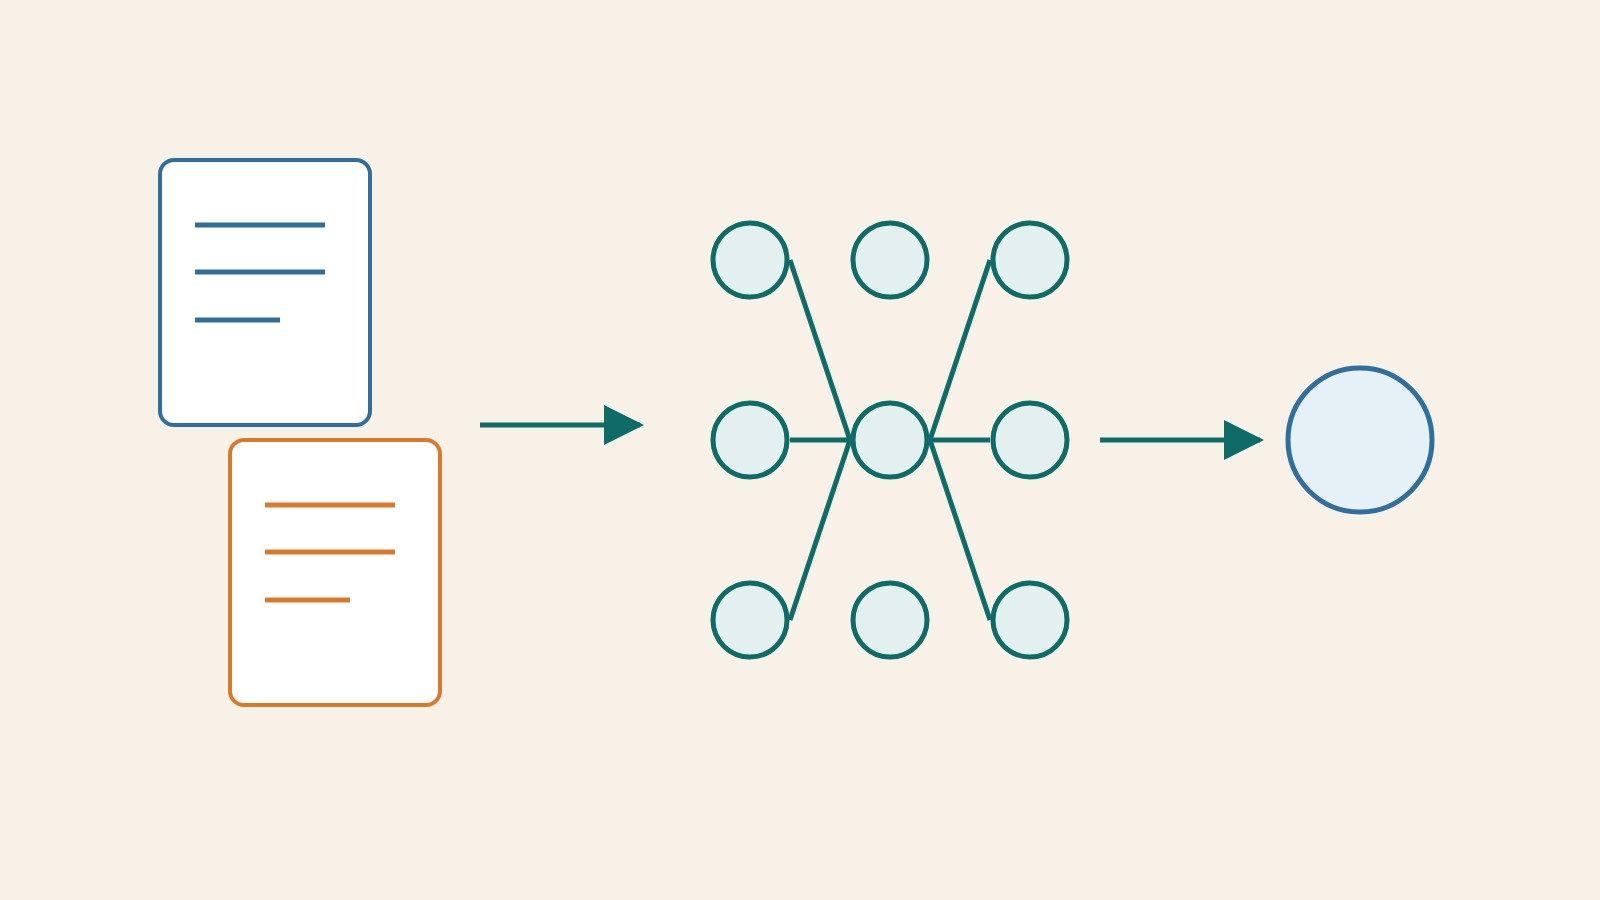
事前学習は、特定のタスク向けに調整する前に、大量のデータから再利用できる表現や規則性をモデルに学ばせる段階です。本稿では、次の token の予測と、隠された内容の復元を例に、データ、目標、パラメータ更新を説明します。事前学習、ファインチューニング、利用時のコンテキスト提供の違いを示し、テキストを学習しても出典の記憶や事実の正確さが保証されない理由も解説します。基盤モデルの能力の源と、学習データの品質や評価データの混入による影響を理解できます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
アテンション機構(Attention)とは:モデルは参照する token をどう決めるのか
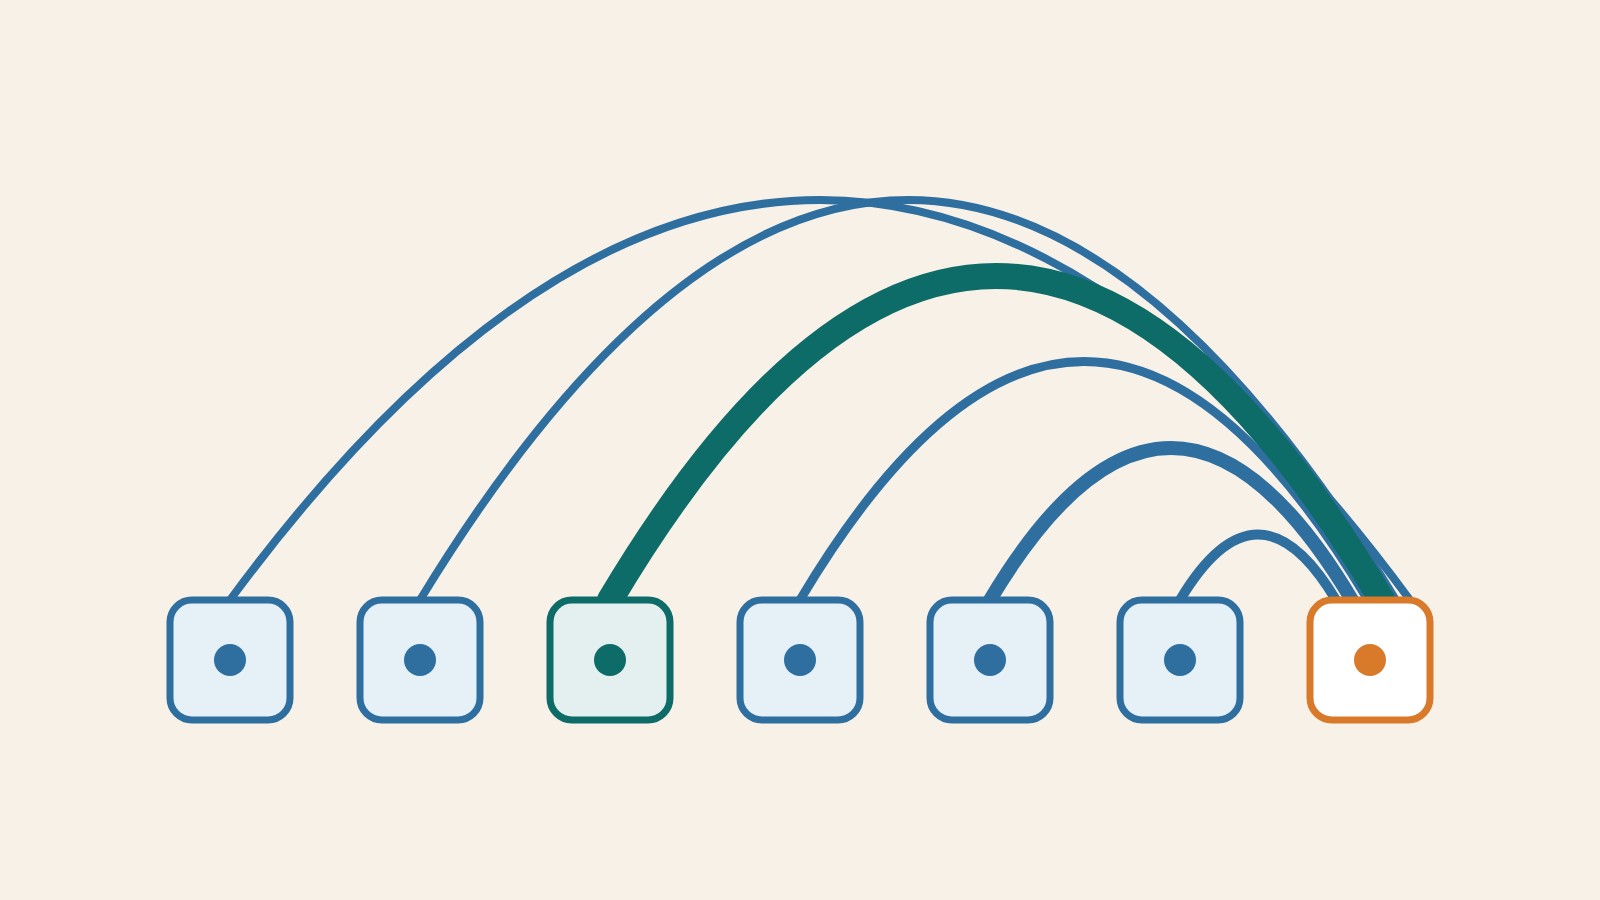
アテンション機構は、系列内の各位置について query と key を照合して重みを求め、各位置の value を加重平均して新しい表現を作ります。2014 年の翻訳におけるアライメントから 2017 年の Transformer までをたどり、Q、K、V、自己注意、クロスアテンション、マルチヘッドアテンションを例で説明します。また、標準的な手法では計算量が長さの二乗に比例して増えることや、アテンションの重みをモデルの判断理由と直接みなせない点も取り上げます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
Transformer アーキテクチャ(Transformer)とは
Transformer は、アテンション機構で系列内の関係を処理するニューラルネットワークのアーキテクチャで、多くの言語モデルやマルチモーダルモデルの重要な基盤です。本記事では、活動のお知らせに含まれる代名詞や語順を例に、自己アテンション、位置情報、フィードフォワードネットワーク、マスクがどう連携するかを説明し、当初のエンコーダー・デコーダー設計と後の派生形を区別します。モデルが文脈をどう利用するかを理解するとともに、アテンションの重みは人間の注意や意思決定の完全な説明ではなく、長い系列には計算と検証のコストが伴うことも学べます。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
生成AI(Generative AI)とは
生成AIはデータからパターンを学び、入力条件に応じて文章、画像、音声などのコンテンツを生み出します。本記事では地域のフリーマーケットの宣伝素材を例に、生成と分類・検索の違いを説明し、言語モデル、拡散、敵対的生成などの異なる手法を紹介します。また、もっともらしい内容でも事実に忠実とは限らない理由を解説します。読後には、創作上の要望、保持すべき情報、人による検収を分けて計画し、どの成果物がまだ確認待ちの草稿なのかを判断できるようになります。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
ニューラルネットワーク(Neural Network)とは:層と重みから成り、データから学習する関数
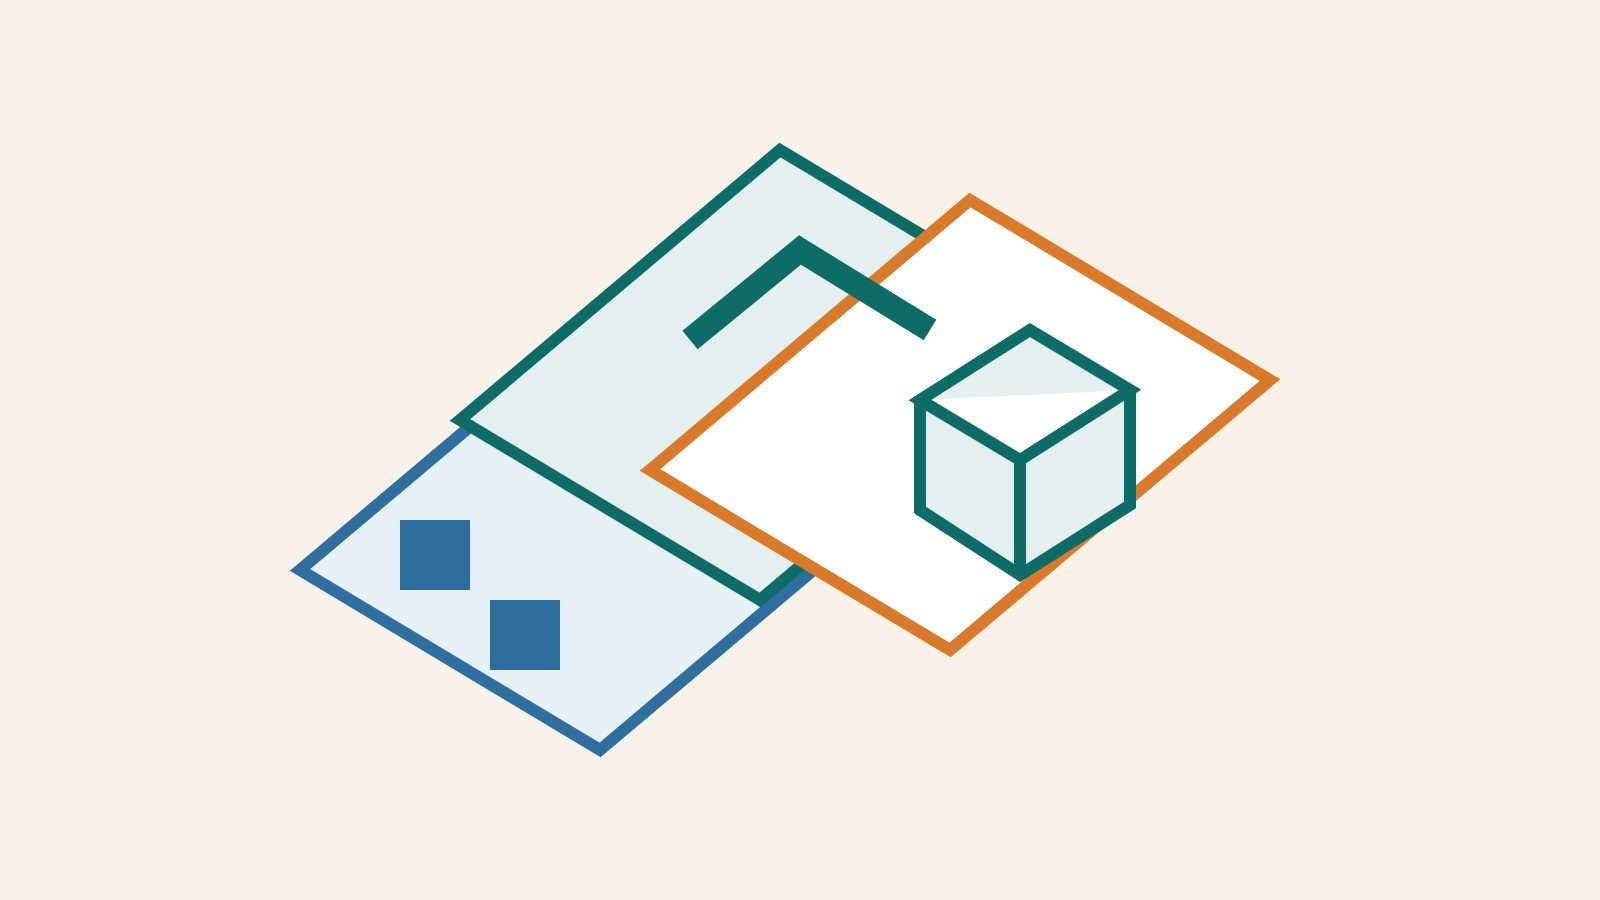
ニューラルネットワークは、単純なユニットを多層に組み合わせた関数です。各ユニットは重み付き和を計算し、多くの場合は非線形変換を加え、重みはデータから調整します。二つのスイッチで廊下の照明を操作する手計算の例で、順伝播、損失、逆伝播、勾配降下法を説明し、学習と推論を区別します。さらに、パラメータ数、ニューロン数、能力の違いと、深層学習や Transformer との関係を整理します。
- AIツール
- チュートリアル
- AI用語解説
ライフスタイル
深層学習(Deep Learning)とは
深層学習は多層のニューラルネットワークを使い、データからさまざまな階層の表現を学習する手法で、画像・音声・テキストのタスクによく使われます。本記事では資源ごみの写真分類を例に、隠れ層、非線形性、訓練、推論の役割を説明し、モデルが物品ではなく背景を覚える可能性や、データ・計算資源・解釈可能性のトレードオフを解説します。深層学習と機械学習全般の関係を理解し、撮影条件を変えてモデルが本当に有用なパターンを学んだか確認できるようになります。
- AIツール
- チュートリアル
- AI用語解説