ライフスタイル
ファインチューニング(Fine-tuning):既存のモデルを自分のタスクに合わせる
ファインチューニングは、既存のモデルに追加学習を行い、特定のタスクや分野に適するようにする手法です。本記事では、カスタマーサポートのメール分類を例に、データ整理、パラメータ更新、テストセットの確保、バージョンのデプロイを解説します。フルファインチューニング、LoRA、教師ありファインチューニング、RAG の違いと、学習成績が良くなっても実際の性能が下がる理由も説明します。読み終えると、ファインチューニングを行う価値がある問題かどうかを判断し、形式の一貫性、未知の種類、データリーク、既存の能力の低下を確認する方法がわかります。
読了目安 11 分
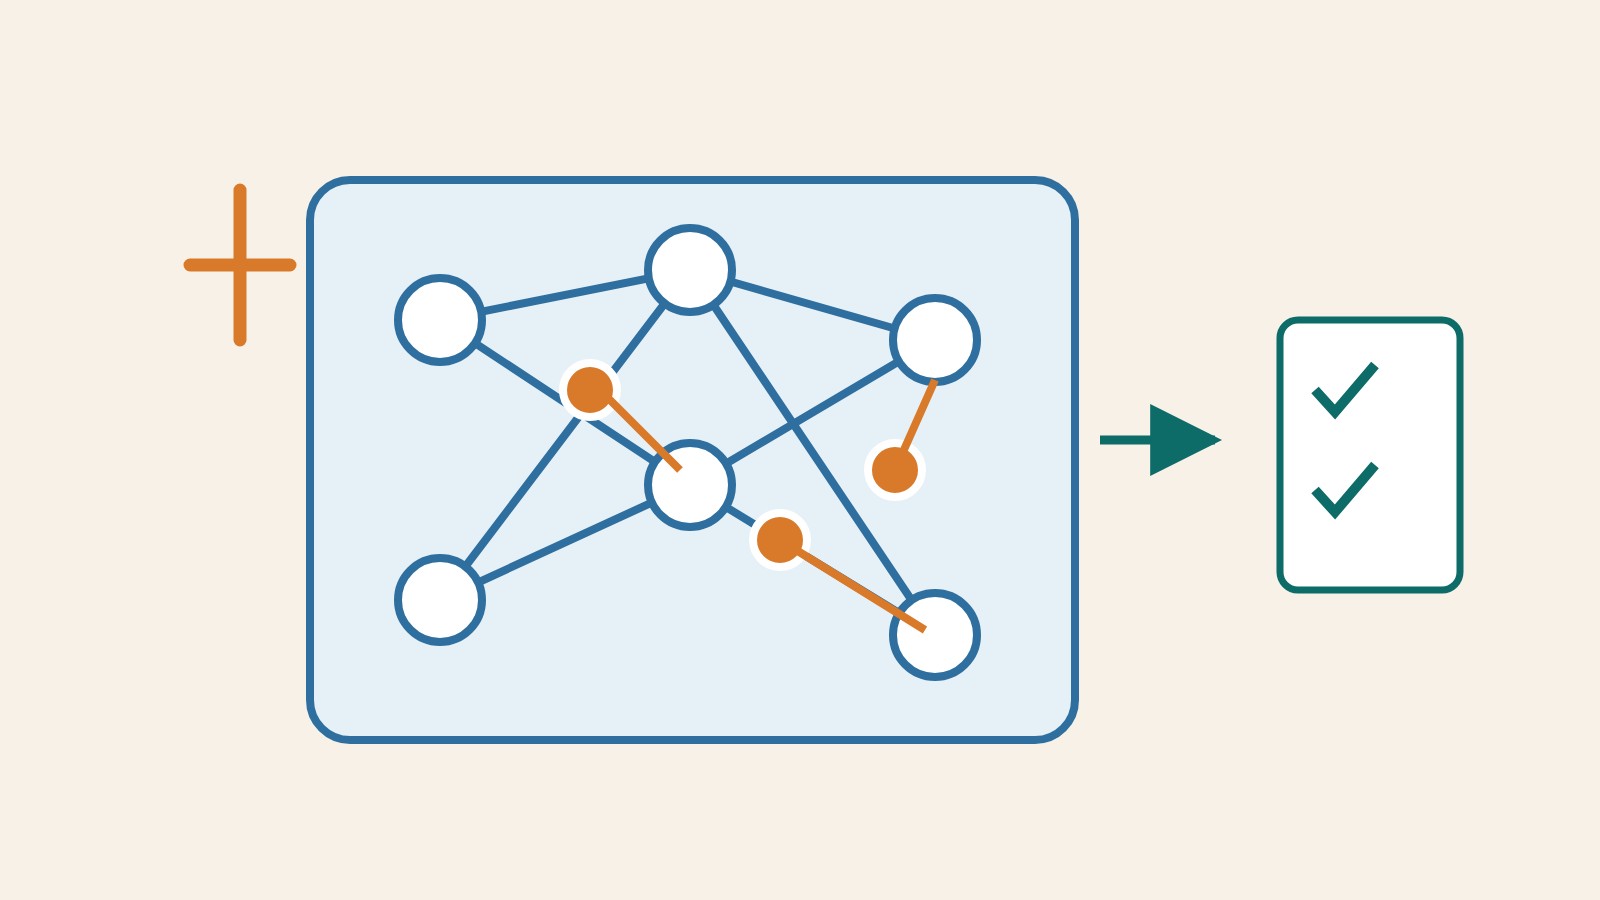
ファインチューニングは、英語で Fine-tuning といい、学習済みのモデルを出発点に、対象を絞ったデータで追加学習を行い、特定のタスクや分野に適するようにする手法です。既存の能力を引き継ぐもので、ランダムなパラメータモデルパラメータ(Model Parameters)とはモデルパラメータは、入力を出力に変換するために学習時に調整される数値で、重みやバイアスなどがあります。この記事では簡単な式を使って、パラメータが予測にどう影響するかを説明し、モデルパラメータ、学習のハイパーパラメータ、プロンプト、生成設定を区別します。また、パラメータ数、数値精度、アクティブパラメータ数が異なる指標である理由も解説します。モデルの仕様をより正確に読み取り、パラメータが増えても知識が一件ずつ増えるわけではなく、チャットのたびにモデルを学習し直すわけでもないことを理解できます。記事全文を読むからやり直すわけではありません。言語モデルでは、分類、出力形式の固定、専門分野の文書処理などの改善に使われます。具体的に何を改善できるかは学習目標とデータに依存し、「カスタムモデル」という名前だけでは判断できません。
ファインチューニングは、モデル内の学習可能なパラメータの一部を更新するため、プロンプトに例を入れる方法とは異なります。本記事では、架空のカスタマーサポートのメール分類を例に設計と受け入れ評価の方法を説明し、ファインチューニングの方式、学習目標、外部検索の違いを整理します。Hugging Face の実装ドキュメントと ULMFiT の原著論文は、既存のモデルに追加学習を行うための基礎を示しています。以下では、特定の設定が実測で成功したとは主張せず、どの場面にも通用する必要データ件数も保証しません。
まず何を変えたいのかを明確にする
カスタマーサポートでメールをアカウント、支払い、その他に分類する必要があるとします。汎用モデルは大意を理解していても、長い説明を出力したり、分類名が一定しなかったりすることがあります。この場合、ファインチューニングの目標は、指定した形式で安定して分類できるようにすることです。一方、データベースで更新されたばかりの注文状況を扱う場合、ファインチューニングはリアルタイム更新の適切な手段ではありません。アクセス権限のあるシステムに問い合わせ、その結果をモデルに処理させるべきです。
ファインチューニングは、口調をまねるためだけのものでもありません。分類、系列ラベリング、生成などのタスクに合わせて調整できますが、それぞれに対応するデータと評価が必要です。学習データが実際の利用場面に近いほど、目標を達成できたかを検証しやすくなります。整った定型的な例ばかりを集めると、誤字、複数の要望が混在するメール、曖昧なメールに対して性能が不安定になる可能性があります。まず成功と失敗の条件を明文化してこそ、学習を行う価値があるかを判断できます。
目標と更新方法は別々に選ぶ
教師ありファインチューニングは、入力と期待する出力を使って学習します。一方、選好最適化では、同じ質問に対する、より良い回答とより悪い回答を使う場合があります。これは学習信号の選択です。フルファインチューニングは、モデルのパラメータの大部分またはすべてを更新します。LoRA などのパラメータ効率の高い手法は、追加した小さな部分を更新します。こちらはモデルをどう調整するかの選択です。両方の軸は組み合わせられるため、SFT と LoRA を互いに排他的な製品の選択肢として扱うことはできません。
学習では、データ形式、トークン化、損失計算、学習率、評価も扱う必要があります。モデル名を変えたり、何らかの画面にデータをアップロードしたりするだけでは、すべての手順を正しく完了したことにはなりません。データの切り詰めによって期待する回答が失われたり、フィールドのずれによって誤った目標を学習したり、重複内容によって特定の事例が過度に強化されたりする可能性があります。本格的な長時間の学習を始める前に、少量のサンプルでこうした問題を確認すべきです。
詳しい説明を読む
既存のモデルを学習用の例でファインチューニングし、別に確保したメール群は評価だけに使う。合格して初めてデプロイ可能なバージョンになる
例:サポートメール分類の受け入れ評価
「パスワードを忘れました。支払い通知も古いメールアドレスに届いています」という入力を設計する場合、勝手に単一のカテゴリを指定してはいけません。まず、複数カテゴリを認めるのか、アカウントを優先するのか、人の対応に回すのかという業務ルールを決めるべきです。そのうえで、一貫した基準で例を作成し、学習に使わないメールを一部テスト用に確保します。期待する出力はルールと形式に従うべきであり、単に学習用メールを暗記させ、模範解答に近づければよいわけではありません。
比較対象として、まず元のモデルに明確なプロンプトと少数の例を与え、ファインチューニング版と同じ未学習のメール群を処理させる方法があります。カテゴリが正しいか、形式が有効か、曖昧なケースを人の対応に回せるか、カテゴリごとの誤りの分布を記録します。形式だけが改善して重要な分類の性能が下がった場合、全体の平均だけでファインチューニングが成功したとはいえません。これは評価の設計であり、実際にどの程度改善するかはテストが必要です。
対象範囲外のメールも確保しておく必要があります。たとえば、自分の注文の進捗をリアルタイムで照会したいという依頼です。分類モデルは適切な窓口に振り分けられますが、学習時の記憶だけで注文状況を作り上げてはいけません。回答が次第にサポート担当者らしくなっても、対応結果を捏造し始めたなら、出力の振る舞いがタスクの範囲を超えています。流暢さを良い成果と見なすのではなく、例と受け入れ評価を調整する必要があります。
学習スコアが良くても失敗する理由
過学習とは、モデルが学習データに適合しすぎて、新しい事例では不安定になることです。もう一つの問題はデータリークです。同じメールの異なる版が学習用とテスト用に分かれると、成績が汎化能力を示しているように見えても、実際には繰り返し練習に近い状態です。出所、時期、同一案件などでグループ分けして分割し、ほぼ重複している内容も確認するとよいでしょう。データの分け方は、製品が実際に受け取る新しい入力を反映している必要があります。
対象を絞った学習の後に、既存の能力が低下することもあります。たとえば、サポート用のカテゴリしか出力しなくなり、以前は対応できていた質問への回答が不自然になる場合です。それが許容できるトレードオフかどうかは、デプロイ後の用途によります。専用の分類器と汎用アシスタントでは基準が異なります。一群のタスクでの改善から、すべての能力が向上したと判断することはできません。維持すべき能力のテストを残し、ファインチューニング前後の差を記録することが重要です。
学習完了から使えるモデルになるまで
学習プログラムの終了が意味するのは、モデルの状態が一つ生成されたということだけです。その後も、読み込み、推論時の形式、遅延、デプロイするバージョン、ロールバック方法を検証する必要があります。追加パラメータを使う場合は、指定したベースモデルとの互換性も確認しなければなりません。プロンプト、tokenizer、出力パーサーも結果に影響する可能性があるため、重みファイルの名前だけを保存するのではなく、推論に使う構成全体をまとめて記録すべきです。
始める前に、プロンプトの改善、明確な例の提示、データの修正を試すことができます。学習可能で安定した振る舞いについて誤りが続くなら、ファインチューニングを検討します。データが頻繁に更新され、出典の提示も必要な知識に関する質問応答では、まず RAG を検討するとよいでしょう。両者は併用できます。ファインチューニングで回答形式を守らせ、検索でその時点の根拠を提供するという使い方です。選択は失敗の原因に基づいて行い、カスタマイズ自体を目的に不要な保守作業を増やさないようにします。
実際の運用開始後は、新しい種類のメールを抜き取り確認する必要があります。特に業務ルールが変わったときは重要です。古いモデルが従来どおりに分類し続ける場合、単にプロンプトが不明確なのではなく、学習目標そのものが古くなっている可能性があります。データとモデルのバージョン、アノテーションのルール、評価結果を残しておけば、再学習が必要なのか、前処理を修正すべきなのか、外部の業務フローだけを更新すればよいのかを判断できます。例示データに含まれる個人情報も、あらかじめ目的に沿って整理し、不要な連絡先情報を回答パターンとして学習させないようにすべきです。データを学習に利用できる条件と、そのデータがサポートシステムに存在したことがあるかどうかは、別の問題です。
| 方法 | 主に扱うこと | 注意点 |
|---|---|---|
| プロンプトと例 | その回の入力を変える | 通常はパラメータを変えない |
| ファインチューニング | 目標に合わせて追加学習する | データとバージョンの管理が必要 |
| RAG | 外部の根拠を提供する | 知識の更新をモデルから切り離せる |
教師ありファインチューニング(SFT):良い例でモデルにタスクの遂行を教える教師ありファインチューニング(SFT):良い例でモデルにタスクの実行を教える教師ありファインチューニングは、入力と期待する出力を訓練例として使い、既存のモデルにより安定したタスクの振る舞いを学習させます。本記事では、会議のタスク整理を例に、データの対応付け、会話のロール、損失計算、テスト用データの確保を説明し、SFT、フューショットプロンプティング、LoRA、選好最適化を区別します。また、例に含まれる推測や形式の誤りまで学習される仕組みも解説します。読後には、訓練データがモデルに不明な情報を不明のまま残すことを教えているのか、単に見た目を整えることだけを教えているのかを確認できます。記事全文を読む
低ランク適応(LoRA):少数の学習可能なパラメータでモデルを調整する仕組み
検索拡張生成(RAG)とは:回答に確認可能な根拠を添える検索拡張生成(RAG)とは:回答に検証できる根拠を添える検索拡張生成は、まず外部データから関連する内容を探し、それを言語モデルに渡して回答を組み立てます。この記事ではイベントの申込規約に関する質問応答を例に、インデックス作成、検索、生成、出典確認を分解し、検索やファインチューニングとの違い、引用があっても誤答する理由を説明します。読めば、原因がデータの更新漏れ、文書の検索漏れ、モデルによる根拠の過剰解釈のどこにあるかを判断でき、どのような場合に「わからない」という回答を保つべきかもわかります。記事全文を読む
AI 用語総索引:Loop Engineering から生成 AI まで
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
この記事を引用している記事
出典
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。