ライフスタイル
事前学習(Pretraining):モデルの基礎能力はどこから来るのか
事前学習は、特定のタスク向けに調整する前に、大量のデータから再利用できる表現や規則性をモデルに学ばせる段階です。本稿では、次の token の予測と、隠された内容の復元を例に、データ、目標、パラメータ更新を説明します。事前学習、ファインチューニング、利用時のコンテキスト提供の違いを示し、テキストを学習しても出典の記憶や事実の正確さが保証されない理由も解説します。基盤モデルの能力の源と、学習データの品質や評価データの混入による影響を理解できます。
読了目安 11 分
目次
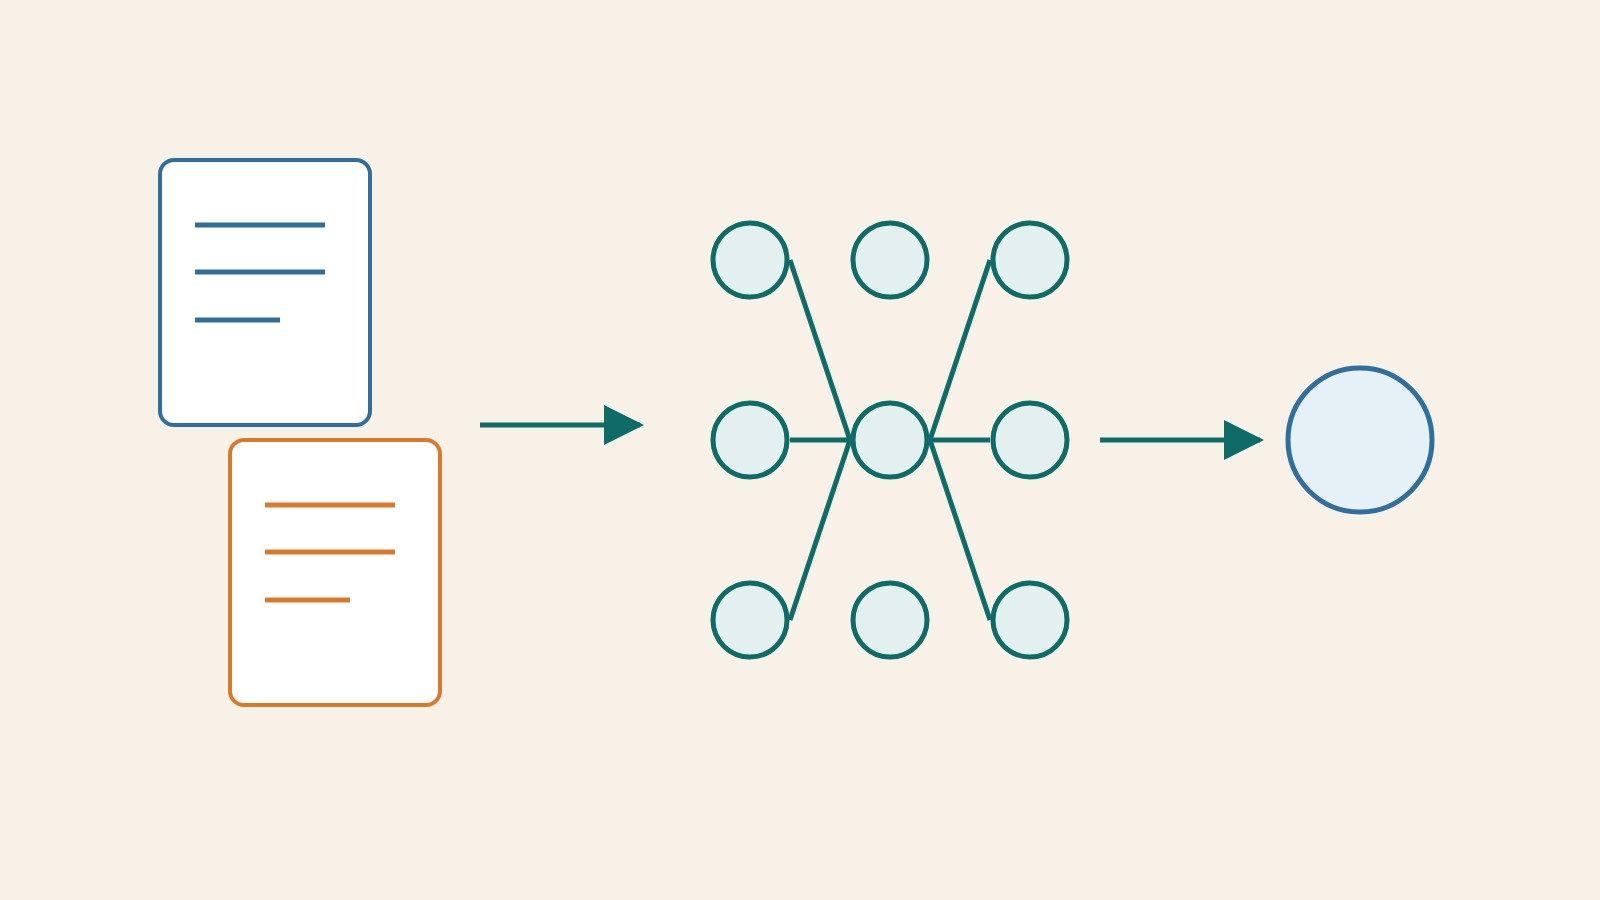
事前学習は、英語では Pretraining といい、特定のタスク向けに調整する前に、データから再利用できる規則性や表現をモデルに学ばせる学習段階です。言語モデルでは、次の token を予測したり、コンテキストから隠された内容を復元したりする方法がよく使われます。モデルは予測と目標を繰り返し比較してパラメータを更新し、さまざまなタスクに使える能力を徐々に形成します。人が最初にすべての言語規則を一つずつ書き込むわけではありません。
「事前」は後の用途を基準にした言い方であり、この段階が簡単だったり、単なる準備運動だったりするという意味ではありません。モデル構築の作業の大部分を占める場合もあり、データの整備と計算のどちらも重要です。本稿では BERT の原論文と Hugging Face の言語モデリングのドキュメントを基に、よく使われる学習目標を説明します。例はすべて簡略化した学習用のもので、あるモデルの手順を、すべてのAI人工知能(Artificial Intelligence)とは人工知能は、さまざまな技術や応用を含む総称で、チャットボットと同じではなく、必ず文章を生成するものでもありません。本記事ではOECDのシステム定義を出発点に、写真分類と地域資源の推薦を例として、入力、推論、出力、人の目標がどうつながるかを説明し、機械学習、深層学習、生成AIとの関係を整理します。具体的な問いからAI機能の働きを判断し、能力、自律性の程度、信頼性を区別できるようになります。記事全文を読むが必ずたどる唯一の道とみなすものではありません。
モデルは何を学習しているのか
因果言語モデリングでは通常、先行する文脈を使って次の token を予測します。例えば「イベントは大雨のため」と与えられた場合、目標となる内容は原文の続きから得られることがあります。モデルは人の意図を示す完全なラベルを最初に受け取るのではなく、テキストの系列自体から予測の練習課題を得ます。このようにデータから目標を作る方法は、一般に自己教師あり学習と呼ばれます。ただし、データに人の手を加える必要がまったくないという意味でも、どの文章が真実で、学ぶ価値があるかをモデルが自律的に判断できるという意味でもありません。
マスク言語モデリングでは、内容の一部を隠し、残りの文脈から隠された部分をモデルに予測させます。BERT の元の設計はこの種の目標を使い、双方向の文脈を組み合わせて表現を学習します。これは、前の文脈だけを見て後の内容を予測する方法とは異なります。どちらの例でも言語の規則性を学べますが、アーキテクチャ、目標、適した下流タスクが異なるため、どちらも事前学習と呼ばれるからといって、同じ能力が得られるとは限りません。
データとパラメータはどう影響し合うのか
学習時には、まずモデルが予測を出し、損失関数が目標との差を測り、最適化プログラムがパラメータを調整します。学習率、データの順序、バッチ、学習の長さは更新過程に影響しますが、一般の読者がすべての数式を覚える必要はありません。まず押さえるべきことは、事前学習によってモデル内部のパラメータが変わるという点です。その後、チャット欄に文書を貼り付けるだけなら、通常はそのやり取りのコンテキストを提供しているのであり、同じパラメータ更新を実行しているわけではありません。
データの内容も、モデルがどの言語、書き方、話題に多く触れるかに影響します。台湾で使われる特定の口語表現、珍しい専門用語、文書形式がデータに十分含まれていなければ、モデルの処理が不安定になる可能性があります。データが多ければ自動的に良質になるわけではなく、重複、ノイズ、誤った内容に学習能力が割かれる可能性もあります。モデルの能力の源を考える際には、パラメータ数の大きさだけを問うのではなく、データの分布と学習目標を併せて見る必要があります。
詳しい説明を読む
元のテキストは次の token の予測やマスク部分の復元という練習に変換でき、予測の誤差を使ってパラメータを更新することで基盤モデルが形成される
例:文による練習から新たな入力へ
説明用のモデルが、「イベントは大雨のため延期」や「申込締切後は受け付けません」といった告知文を数多く読むとします。次の token の予測を通じて、特定の文脈の後にどのような断片がよく現れるかを学びます。その後、新しい告知の書き出しを受け取ると、モデルはもっともらしい続きを生成できるかもしれません。しかし、その新しいイベントが実際には予定どおり開催される場合でも、「延期」と続けてしまうことがあります。もっともらしい続きを書けることは、そのイベントの実際の決定を知っていることとは違うからです。
代わりにマスクを使う練習として、「申込締切後は受け付けません」の一部を隠す場合、モデルは前後の文脈を使って内容を復元する必要があります。期待される学習成果は、文の関係をよりよく表現できるようになることであり、各告知の出典を暗唱できるようになることではありません。これら二つの例では、学習目標の違いが分かりやすいよう、あえて同じ種類のテキストを使っています。実際に学習を実行した例ではなく、実際のモデルの精度や必要なデータ量を推定するためには使えません。
改訂されたばかりの告知を既存のモデルに貼り付けると、モデルはコンテキストに基づいて回答できますが、それは推論段階で新しいデータを使っているということです。別途学習処理を開始しない限り、このやり取りによって事前学習を完了した、あるいはすべての内容を永続的に学んだとはいえません。製品が会話を収集して後の学習に使うかどうかは、別のデータ利用ポリシーの問題であり、その時点でのモデルの計算の仕組みとは分けて理解する必要があります。
学習済みでも信頼できる記憶庫とは限らない
モデルは学習内容の一部を記憶する場合もあれば、一般的な規則性だけを学ぶ場合もあり、すべての文章を正確に取り出せるとは限りません。質問に答えるときにも、生成した文に対応する学習文書が自動で添えられるわけではありません。最新情報や出典の特定が必要なタスクでは、外部検索が依然として重要です。事前学習による能力と検索能力は互いに補い合うことができ、モデルが大きいほど証拠が不要になるわけではありません。
評価では、テスト問題が学習データに混入することも避ける必要があります。モデルが問題や答えをすでに見ていた場合、新しい問題を処理する能力を成績が過大評価する可能性があります。一般の利用者は、自分で新たに整理し、答えを独立に確認できる事例で性能を観察できます。学習を行うチームには、データの重複排除、分割、バージョンの記録が必要です。評価に使った出典を明らかにせず、高得点だけを報告しても、その能力が実際の状況に応用できるかは判断しにくくなります。
事前学習の後には何ができるのか
事前学習済みのモデルには、分野別データで継続的に学習させることも、特定のタスクの実例を使ってファインチューニングすることも、選好最適化などの事後学習を行うこともできます。段階の名称や区切り方はチームによって完全には一致しない場合がありますが、重要なのは、実際にどのデータを使い、どの目標を最適化し、どのパラメータを更新するかです。その後の改善をすべて一括して事前学習と呼ぶと、モデルの能力がどこで形成されたのかが見えなくなります。
応用方法を選ぶ際には、汎用的な言語能力、特定の出力の振る舞い、最新の外部知識のうち、何が不足しているかをまず考えられます。前の二つには適切な基盤モデルやファインチューニングが必要な場合があり、最後の項目には通常データパイプラインが必要です。一般の組織が必ずしも最初から事前学習を行う必要はありません。適切な基盤モデルを直接使い、検索と評価を設計することで、要件をより早く検証できることがよくあります。学習に投資するかどうかは、実際の課題と利用できる資源に基づいて決めるべきです。
モデルの紹介を読む際にも、「事前学習データはある日までのもの」という記述を、その日以前のすべての出来事を知っているという意味に受け取らないようにしましょう。日付が示すのは、せいぜいデータの時間的な範囲についての手掛かりの一部であり、網羅性、出典の品質、モデルが実際に学べたかどうかは依然として不確かです。重要な主張については、モデルが当時何を読んだかを推測するより、照合できる外部の出典を求めるほうが実用的です。
| 方法 | 処理の重点 | 注意点 |
|---|---|---|
| 事前学習 | 再利用できる表現や規則性を学ぶ | モデルのパラメータを更新する |
| ファインチューニング | タスクや分野に合わせて調整する | 既存のパラメータから学習を続ける |
| コンテキストの提供 | そのやり取りで追加データを読み込む | 通常はパラメータを更新しない |
ファインチューニング(Fine-tuning):既存モデルを自分のタスクにより適したものにするファインチューニング(Fine-tuning):既存のモデルを自分のタスクに合わせるファインチューニングは、既存のモデルに追加学習を行い、特定のタスクや分野に適するようにする手法です。本記事では、カスタマーサポートのメール分類を例に、データ整理、パラメータ更新、テストセットの確保、バージョンのデプロイを解説します。フルファインチューニング、LoRA、教師ありファインチューニング、RAG の違いと、学習成績が良くなっても実際の性能が下がる理由も説明します。読み終えると、ファインチューニングを行う価値がある問題かどうかを判断し、形式の一貫性、未知の種類、データリーク、既存の能力の低下を確認する方法がわかります。記事全文を読む
モデルパラメータ(Model Parameters)とはモデルパラメータ(Model Parameters)とはモデルパラメータは、入力を出力に変換するために学習時に調整される数値で、重みやバイアスなどがあります。この記事では簡単な式を使って、パラメータが予測にどう影響するかを説明し、モデルパラメータ、学習のハイパーパラメータ、プロンプト、生成設定を区別します。また、パラメータ数、数値精度、アクティブパラメータ数が異なる指標である理由も解説します。モデルの仕様をより正確に読み取り、パラメータが増えても知識が一件ずつ増えるわけではなく、チャットのたびにモデルを学習し直すわけでもないことを理解できます。記事全文を読む
文脈内学習(In-context Learning)とは:その場で新しいルールに適応する
AI 用語総索引:Loop Engineering から生成 AI まで
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
この記事を引用している記事
出典
- Devlin ら:BERT確認日:
- Hugging Face:因果言語モデリング確認日:
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。