ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
読了目安 11 分
目次
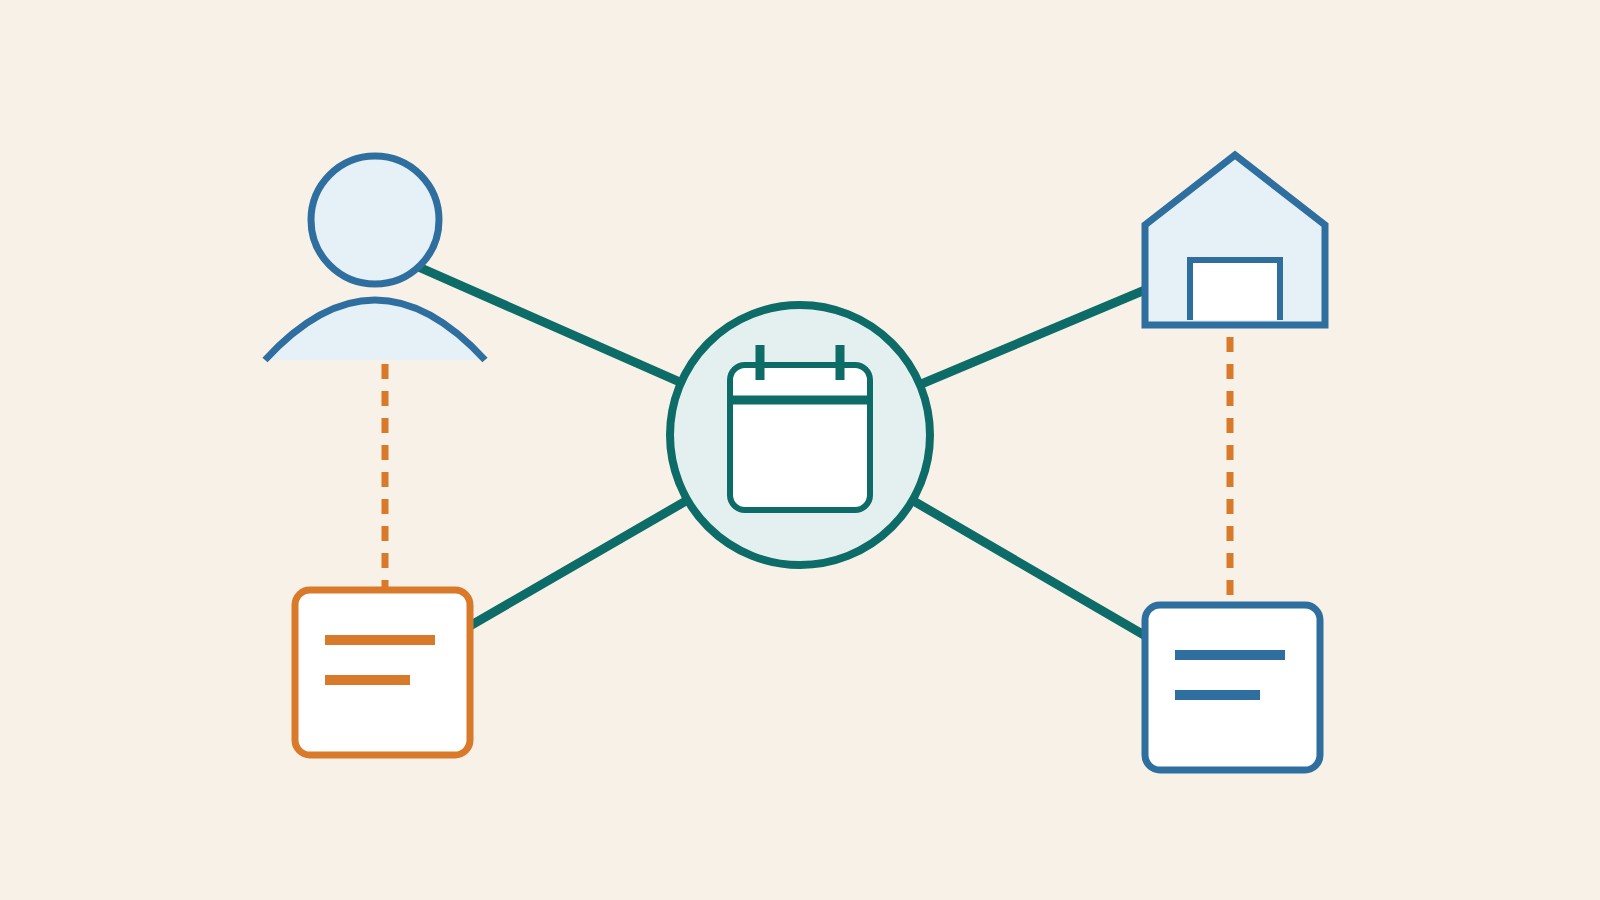
ナレッジグラフ(英語:Knowledge Graph)は、事物とその関係で知識を整理する方法です。事物には人物、組織、場所、文書、イベントなどがあり、関係は誰が何に参加したか、何がどこにあるか、データがどこから来たかを表します。重要なのは、リンクに明確な意味を持たせ、識別情報を追跡できるようにすることです。単にデータを丸い点と線の集まりとして描くことではありません。
この用語には、使用できる保存技術を特定のものに限定するような単一の定義はありません。本記事では、W3C のリソース記述フレームワーク(RDF)の概念仕様と Neo4j のプロパティグラフの説明を具体的な土台として、よく使われる表現方法を二つ紹介します。例には架空のコミュニティイベントのデータを使います。図の関係は解説用の設定であり、実在する人物や組織を調査したものではありません。読者は、どの関係がデータで裏付けられ、どれが図を見た後の推測にすぎないかを見分けられるようになります。
まず同一性を確認し、そのうえで関係を扱う
二つの文書に「山城書屋」が登場した場合、まず同じ書屋を指しているかを判断する必要があります。同じ名前でも別の支店かもしれず、名前が違っても同じ組織が改名しただけかもしれません。グラフには安定したエンティティ識別子が必要で、名称や別名は属性として保持します。この段階を処理しないと、その後に関係をたどって検索する際、異なる対象を混同し、形式上はつながっていても事実の対応を取り違えた回答を得るおそれがあります。
関係にも明確な種類と方向が必要です。「書屋がイベントを主催する」と「イベントの会場が書屋である」では、表す責任が異なります。同じ報告書に一緒に記載されているだけでは、共同主催とはいえません。グラフを作る際は、証拠に基づいて関係を定義し、確定できない部分は未確定のまま残すべきです。必要に応じて「ある文書が協力関係にあると主張している」と出典付きの主張として表し、無条件の事実へと直接格上げしないようにします。
RDF とプロパティグラフの表現方法
RDF の基本的な文は、主語、述語、目的語として理解できます。例えば「イベント甲、開催場所、会場乙」です。W3C の仕様は RDF グラフと関連する識別方法やデータ型を定義し、異なる出典に共通の表現基盤を提供します。ここで示したのは概念上の例にすぎず、中国語の語句を任意に使えばデータ交換仕様のすべてを満たせるという意味ではありません。実際のシステムでは、適切な語彙や識別方法も選ぶ必要があります。
一方、プロパティグラフでは、データをノード、種類を持つ関係、ノードや関係に付くプロパティとして表すことが一般的です。イベントのノードには日付を、主催関係には役割や有効期間を持たせられます。どちらの方法でも関連を整理できますが、データモデル、クエリ言語、相互運用の方法は異なります。新しい方が古い方を置き換えるという関係ではなく、既存のツール、データ交換の要件、チームのデータ管理方法に応じて選びます。
詳しい説明を読む
山城書屋が読書会を主催し、河畔協会が共催、青禾教室で開催する。会場を自動的に共同主催者とみなすことはできない
例:同じイベントに参加したのは誰か
データに、山城書屋が読書会を主催し、河畔協会が共催、会場は青禾教室と明記されているとします。「山城書屋と一緒にイベントを開催したことのある団体は?」と入力すると、システムはまず書屋を見つけ、主催したイベントのノードをたどって他の共催団体を探し、最後にイベントと出典を返せます。期待される結果には河畔協会が含まれますが、青禾教室の役割は会場だけなので、自動的に共同主催団体として扱うことはできません。
イベントの記録に別途「講師は河畔協会の所属」と書かれていても、それだけでは協会が共催者である証拠にはなりません。この場合は講師の所属関係を保持するか、情報が未確認であることを記録すべきです。この例はグラフの利点を示しています。関係の種類によって、同じようにつながっていても意味が異なる状況を検索時に区別できます。言及されたすべての対象を「関連」でつなぐだけでは、図が密になっても、このような正確さを要する質問には対応しにくくなります。
続いて「現在の長期的な協力パートナーは?」と質問を変えると、一度だけ一緒にイベントを開催したという事実では答えられません。データに協力期間や継続的な関係が明示されている必要があり、「共同主催したことがある」をそのまま「現在のパートナー」に変えることはできません。そのため、時間や関係の状態は証拠とともに保存し、回答でもデータの範囲を説明すべきです。これらはモデル化や検索の際に責任を持って判断する事柄であり、グラフ形式で保存するだけで自動的に処理されるものではありません。
グラフは出典の信頼性を保証できない
グラフは人手での整理、ルールによる抽出、言語モデルなどで作れますが、どの方法でも誤りは起こり得ます。元の文書が誤っていれば、どれほど正確に抽出しても、誤った主張を忠実に保存するだけです。モデルによる抽出では、代名詞などの指示先を誤って推測したり、否定を見落としたりすることもあります。原文の信頼性、抽出の忠実さ、同じエンティティとして正しく統合できているかを、分けて確認する必要があります。各段階で誤りの原因は異なるため、全体を一つの信頼度スコアだけで表すことはできません。
出典が撤回または改訂された場合、グラフも更新する必要があります。ある関係が複数の資料で裏付けられているなら、そのうち一つを削除したからといって、必ずしも関係全体を消すべきとは限りません。ただし、何も対応しなくてよいわけでもありません。出典へのリンクと有効期間を保持すると、どの結論が影響を受けるかを追跡しやすくなります。審査が必要なデータでは、候補の関係と確認済みの関係を区別し、未検証の抽出結果がそのまま外部向けの回答に使われないようにすべきです。
グラフが適する場面と、他の方法との組み合わせ方
よくある質問に答えるために、イベントへの参加、コンテンツの引用、組織間の協力など、複数のエンティティにまたがる関係をたどる必要がある場合、グラフ構造はこうした経路を表現しやすい方法です。ただし、データの用途が主に単一テーブルでの絞り込みや集計なら、リレーショナルデータベースの方が直接的かもしれません。グラフ形式での保存は、すべての結合(JOIN)クエリに必要な代替手段ではなく、データ量が多いからといってグラフ化に適するとも限りません。まず実際に答えたい質問を書き出し、その後で構造を決めるべきです。
ベクトル検索は意味の近い出発点を探すのが得意で、グラフは明確な関係をたどって探索を広げるのが得意なので、両者は組み合わせられます。例えば、まずテキストから該当しそうな書屋を見つけ、次に識別子を使って正式なイベント関係を検索します。GraphRAG はさらに、グラフと関連テキストを生成プロセスに渡して回答します。これらの段階でも原文を保持する必要があり、モデルが抽出した一本の線を、十分な引用根拠として扱うことはできません。
小規模な受け入れ検証では、まず一組のエンティティと関係を人手で確認し、同名の別人、名称変更、期限切れの関係、互いに矛盾する出典を加えるとよいでしょう。検索が正しい種類の関係をたどるか、各結果の根拠を示せるかを調べ、データがないときに無理に結び付けないことも確認します。グラフの評価では、どのような検証可能な質問に対応できるかを見るべきで、ノード数の増加や可視化の見た目の複雑さだけで判断してはいけません。可視化は、グラフを読み取るためのインターフェースの一つにすぎません。線が密集している、ノードが近い、色が同じといった特徴は、レイアウトアルゴリズムの選択による場合があり、必ずしもデータ自体の正式な意味を表してはいません。図を共有する際は、関係の凡例と対象範囲の説明を添え、どの視覚的特徴に意味があり、どれが見やすく配置するためだけのものかを読者に伝えるべきです。
| 方法 | 処理の重点 | 留意点 |
|---|---|---|
| テーブル | 行と列でレコードを整理 | 明確な条件での絞り込みや集計に適する |
| ナレッジグラフ | エンティティと意味のある関係 | 同一性と出典の管理が必要 |
| ベクトル表現 | コンテンツの類似性 | 明確な関係の種類を直接は示さない |
グラフ検索拡張生成(GraphRAG):関係から文書群全体を理解するグラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解くGraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。記事全文を読む
埋め込みベクトル(Embedding)とは:コンテンツを比較可能な空間に配置する埋め込みベクトル(Embedding)とは:内容を比較可能な空間に配置する埋め込みベクトルは、モデルがテキストなどの内容を数値の組に変換して表す方法で、意味検索、分類、クラスタリングによく使われます。本記事では「雨の日はどこに行ける」というクエリを使い、エンコード、類似度、候補の取得を解説します。ベクトル間の距離は真偽を示さず、各次元にも直接名前を付けられるとは限らないことを説明し、モデルのバージョン、言語能力、長文の切り捨てによる影響も紹介します。埋め込みベクトル、ベクトルデータベース、回答生成がそれぞれ何を担うのかを理解できます。記事全文を読む
検索拡張生成(RAG)とは:回答に確認できる根拠を添える検索拡張生成(RAG)とは:回答に検証できる根拠を添える検索拡張生成は、まず外部データから関連する内容を探し、それを言語モデルに渡して回答を組み立てます。この記事ではイベントの申込規約に関する質問応答を例に、インデックス作成、検索、生成、出典確認を分解し、検索やファインチューニングとの違い、引用があっても誤答する理由を説明します。読めば、原因がデータの更新漏れ、文書の検索漏れ、モデルによる根拠の過剰解釈のどこにあるかを判断でき、どのような場合に「わからない」という回答を保つべきかもわかります。記事全文を読む
AI 用語総索引:Loop Engineering から生成 AI まで
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
ライフスタイル
検索拡張生成(RAG)とは:回答に検証できる根拠を添える
検索拡張生成は、まず外部データから関連する内容を探し、それを言語モデルに渡して回答を組み立てます。この記事ではイベントの申込規約に関する質問応答を例に、インデックス作成、検索、生成、出典確認を分解し、検索やファインチューニングとの違い、引用があっても誤答する理由を説明します。読めば、原因がデータの更新漏れ、文書の検索漏れ、モデルによる根拠の過剰解釈のどこにあるかを判断でき、どのような場合に「わからない」という回答を保つべきかもわかります。
この記事を引用している記事
出典
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。