ライフスタイル
埋め込みベクトル(Embedding)とは:内容を比較可能な空間に配置する
埋め込みベクトルは、モデルがテキストなどの内容を数値の組に変換して表す方法で、意味検索、分類、クラスタリングによく使われます。本記事では「雨の日はどこに行ける」というクエリを使い、エンコード、類似度、候補の取得を解説します。ベクトル間の距離は真偽を示さず、各次元にも直接名前を付けられるとは限らないことを説明し、モデルのバージョン、言語能力、長文の切り捨てによる影響も紹介します。埋め込みベクトル、ベクトルデータベース、回答生成がそれぞれ何を担うのかを理解できます。
読了目安 10 分
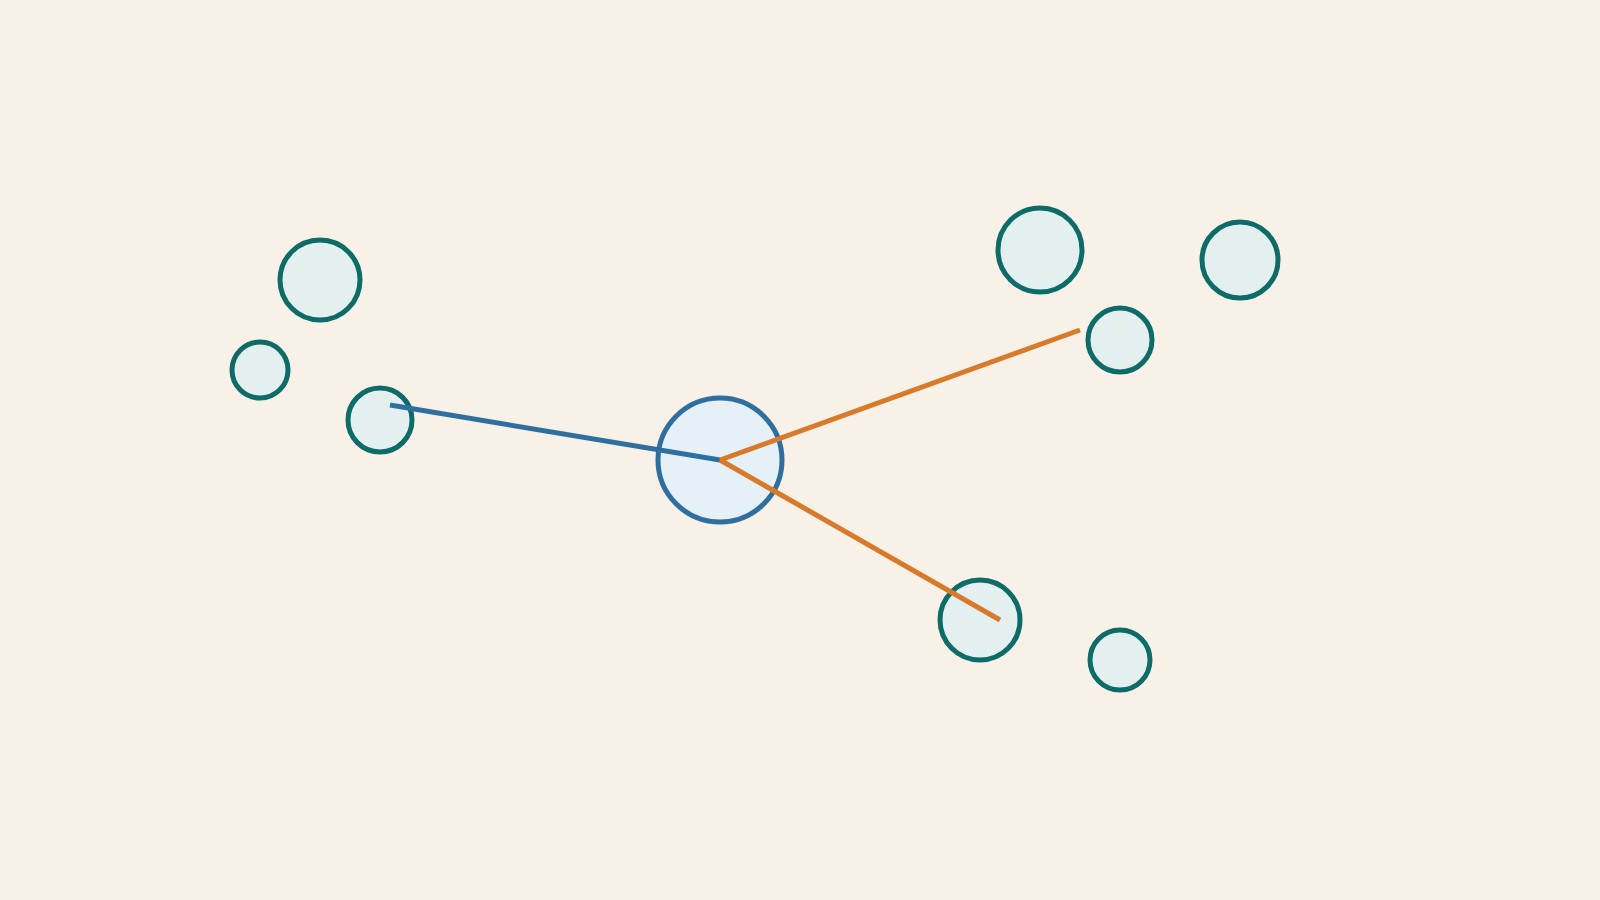
埋め込みベクトルは、英語で Embedding といい、テキスト、画像などの内容を数値の組に変換して表す方法です。この数値の組によって、コンピューターは文字列の完全一致だけでなく、距離や類似度で内容を比較できます。例えば「雨の日の屋内アクティビティ」と「雨の日はどこに行ける」は使う言葉が異なりますが、適切なテキスト埋め込みモデルなら、近い位置に配置する可能性があります。これは学習によって得られた表現であり、辞書が各文に割り当てた固定の座標ではありません。
本記事ではテキストを中心に、モデルがベクトルを生成する、プログラムがベクトルを比較する、アプリケーションが比較結果を使うという三つのステップを区別して説明します。ベクトル自体が話したり、データの事実確認をしたりすることはありません。記事中のアクティビティ名や順位は例示であり、特定のモデルで実測したスコアではありません。実際にモデルを選ぶ際は、自分が使う言語とタスクでテストする必要があり、例で期待される結果を性能の保証とみなしてはいけません。
数値の組で内容をどう表すのか
テキストモデルは、まず入力のトークンを処理し、その学習方法に応じて表現を形成します。文の埋め込みは通常、文全体やひとまとまりのテキストを固定長のベクトルに変換するもので、モデル内部の各トークンの表現とは異なります。Sentence-BERT の原著論文では、文を個別にエンコードしてから類似度で比較する設計が示され、文のペアごとに大型モデルへまとめて入力する必要がなくなりました。これは埋め込み手法の代表例の一つにすぎず、すべての埋め込みが同じ構造を採用しているわけではありません。
学習によって作られた内容の地図と考えることもできますが、この地図のたとえには限界があります。実際のベクトルは多くの次元を持つことが多く、個々の次元が「屋内らしさ」や「交通の便利さ」を表すとは限りません。こうした意味は表現全体で成り立つため、数値が大きくなっただけで、感情、品質、信頼度などと勝手に名付けてはいけません。モデルの得意分野を知るには、座標に中国語の意味を当てはめて推測するのではなく、学習目標とタスクの評価を見る必要があります。
類似度の計算はモデルに合わせる
ベクトルは、コサイン類似度、内積、距離などの方法で比較できます。Sentence Transformers の公式ドキュメントでは、さまざまな計算方法が紹介され、モデル設定に対応する類似度の選択肢があることも説明されています。これらの計算で得られるのは、特定の表現空間における近さであり、世界共通の関連性スコアではありません。モデル、正規化の方法、距離関数を変更した後は、以前のしきい値をそのまま使うべきではありません。
クエリとデータには、互換性のある表現方法を使う必要があります。一部の検索モデルは、短い質問を長めの回答段落と対応させるために、質問と文書で異なるプロンプトの接頭辞やエンコード用の入力口を使います。二つのモデルの出力次元数が同じでも、座標空間が同じとは限りません。古い文書ベクトルと新しいモデルのクエリを混用すると、数値は計算できても、信頼できる意味を失う可能性があります。モデルを更新する際は、インデックスとクエリの組み合わせを再検証する必要があります。
詳しい説明を読む
質問と文書をそれぞれ互換性のあるエンコードでベクトルに変換し、類似度の計算後に原文を取得して、実際の条件を確認する
実例:雨の日のアクティビティのメモを探す
「陶芸工房は屋内にある」「川沿いの遊歩道は見晴らしがよい」「美術館は雨の日でも見学できる」というメモがあるとします。「雨の日はどこに行ける」と入力したら、まず選んだモデルで質問をエンコードし、メモのベクトルと比較して候補の段落を取得します。屋内に関するメモが見つかりやすいと期待するのは妥当ですが、モデルが台湾の表現に詳しくなかったり、メモで背景情報が省略されすぎていたりすると、実際の順位は異なる可能性があります。
候補を取得した後は、原文に戻って制約を確認する必要があります。陶芸工房には予約が必要かもしれず、美術館には休館日があるかもしれません。ベクトルが近くても、今日行けるとは限りません。アプリケーションで旅程全体を回答するなら、営業情報も検索し、生成のステップで整理する必要があります。最も近い項目をそのままおすすめにすると、「関連する話題に触れている」ことと「すべての条件を満たしている」ことを混同してしまいます。
「この会場は雨天の利用には適していない」という紛らわしい文を加えてテストすることもできます。同じ語彙や話題を含むため、そのベクトルも雨の日についてのクエリに近くなる可能性があります。システムがこれを適切な候補として扱っても、距離の計算が壊れているとは限りません。埋め込みは話題の近さを捉えるのが得意でも、最後の条件判定は苦手なのかもしれません。この場合は再ランキングや明示的な条件チェックを追加でき、埋め込みを完全に捨てる必要があるとは限りません。
圧縮によって失われやすい内容
長い段落に多くの話題が含まれると、単一のベクトルでは細部をすべて保持するのが難しくなります。また、モデルの入力制限を超えたテキストは切り捨てられる可能性があります。文書を意味のある段落に分け、見出しと出典情報を保持するほうが、むやみにベクトルの次元数を増やすよりも、通常は問題に即した対応になります。ただし、細かく分割しすぎると主語や条件が失われる可能性があるため、ベクトルの品質は文書の処理方法と切り離して評価できません。
専門用語、珍しい地名、製品コード、否定条件も、特にテストする価値があります。意味を扱うモデルは類義語をうまく見つけられても、名前がよく似た別の商品を区別できないことがあります。正確な識別が必要な項目には、テキストや構造化データによるフィルタリングを併用できます。データの安全性については、ベクトルであることは匿名化や暗号化の保証にはなりません。原文のアクセス権限や機微なデータの取り扱いには、引き続き元の要件を守る必要があり、単なる数値に見えるからといって自由に共有してはいけません。
埋め込み関連機能の説明を読み解く
「埋め込みに対応」と書かれていたら、まず入力の種類、対応言語、許容される長さ、モデルのバージョン、類似度の計算方法を確認し、実際に使うデータに対応できるかを見ます。特に言語をまたぐ検索では、きれいに翻訳された文だけでなく、読者が実際に質問するときの表現でテストする必要があります。評価用の質問にも、同義、反義、固有名称、まったく無関係な内容を含めてこそ、その限界が見えてきます。
実用的な小さなテストとして、各質問で見つかるべきメモを先に人手で指定し、候補にそれらが含まれているかを比べる方法があります。関連するメモが候補にまったく入らないなら、分割とエンコードを確認します。候補には入るものの順位が低いなら、再ランキングを検討できます。順位が正しいのに回答が間違っているなら、問題は生成にあるかもしれません。埋め込みは比較可能な内容表現を提供しますが、最終的なサービスの品質は、その後どう使うかに左右されます。
検索結果を自動分類に使う場合は、どの時点で判定を採用し、どの時点で人に確認を委ねるかも別途決める必要があります。最も近いカテゴリでも、入力とはまったく無関係な可能性があります。既存の選択肢から首位を選ぶだけのシステムは、新しい種類の入力に対しても無理に選んでしまいます。「適切なカテゴリがない」事例を加えてこそ、アプリケーションが相対的な最高スコアを十分な根拠と取り違えていないか確認できます。
| 方法 | 主な処理 | 注意点 |
|---|---|---|
| 埋め込みモデル | 内容をベクトルに変換 | 表現は学習目標の影響を受ける |
| ベクトルデータベース | ベクトルの保存と検索 | 内容の真偽は判定しない |
| 生成モデル | テキストの回答を生成 | 信頼できる根拠の読み取りが必要 |
ベクトルデータベース(Vector Database):似た内容をどう保存し、どう探すか
意味検索(Semantic Search):異なる表現で関連する内容を見つけるセマンティック検索(Semantic Search):異なる言い方で関連する内容を見つけるセマンティック検索は、同じ語句の一致だけでなく、クエリと内容の意味に基づいて情報を探す手法です。この記事では、よくある問い合わせを例に、クエリの符号化、文書の表現、候補の順位付けを説明し、意味の類似と実際にニーズを満たすことの違いを示します。否定文、固有のコード、言語をまたぐ検索、答えのない質問への限界も紹介します。読み終えると、検索の問題を埋め込みモデル、データ整理、ハイブリッド検索、リランキングのどこから改善すべきか判断でき、自然言語の回答を検索そのものと取り違えずに済みます。記事全文を読む
文書の分割(Chunking):答えを分断しない長さとは
AI 用語総索引:Loop Engineering から生成 AI まで
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
この記事を引用している記事
出典
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。