ライフスタイル
フューショットプロンプティング(Few-shot Prompting)とは:例で形式を明確に伝える
フューショットプロンプティングは、同じ入力内に少数の例を入れ、モデルに例に沿って新しいデータを処理させる方法です。モデルの再学習とは異なります。この記事では落とし物情報の分類を題材に、モデルが表面的な言い回しだけをまねしないよう、通常例、境界例、情報不足の例を選ぶ方法を解説します。テスト方法、比較表、オリジナル図解を交え、例を増やすべき場合、先に分類ルールを直すべき場合、例示用データと検証用データを分ける必要がある理由を説明します。
読了目安 11 分
目次
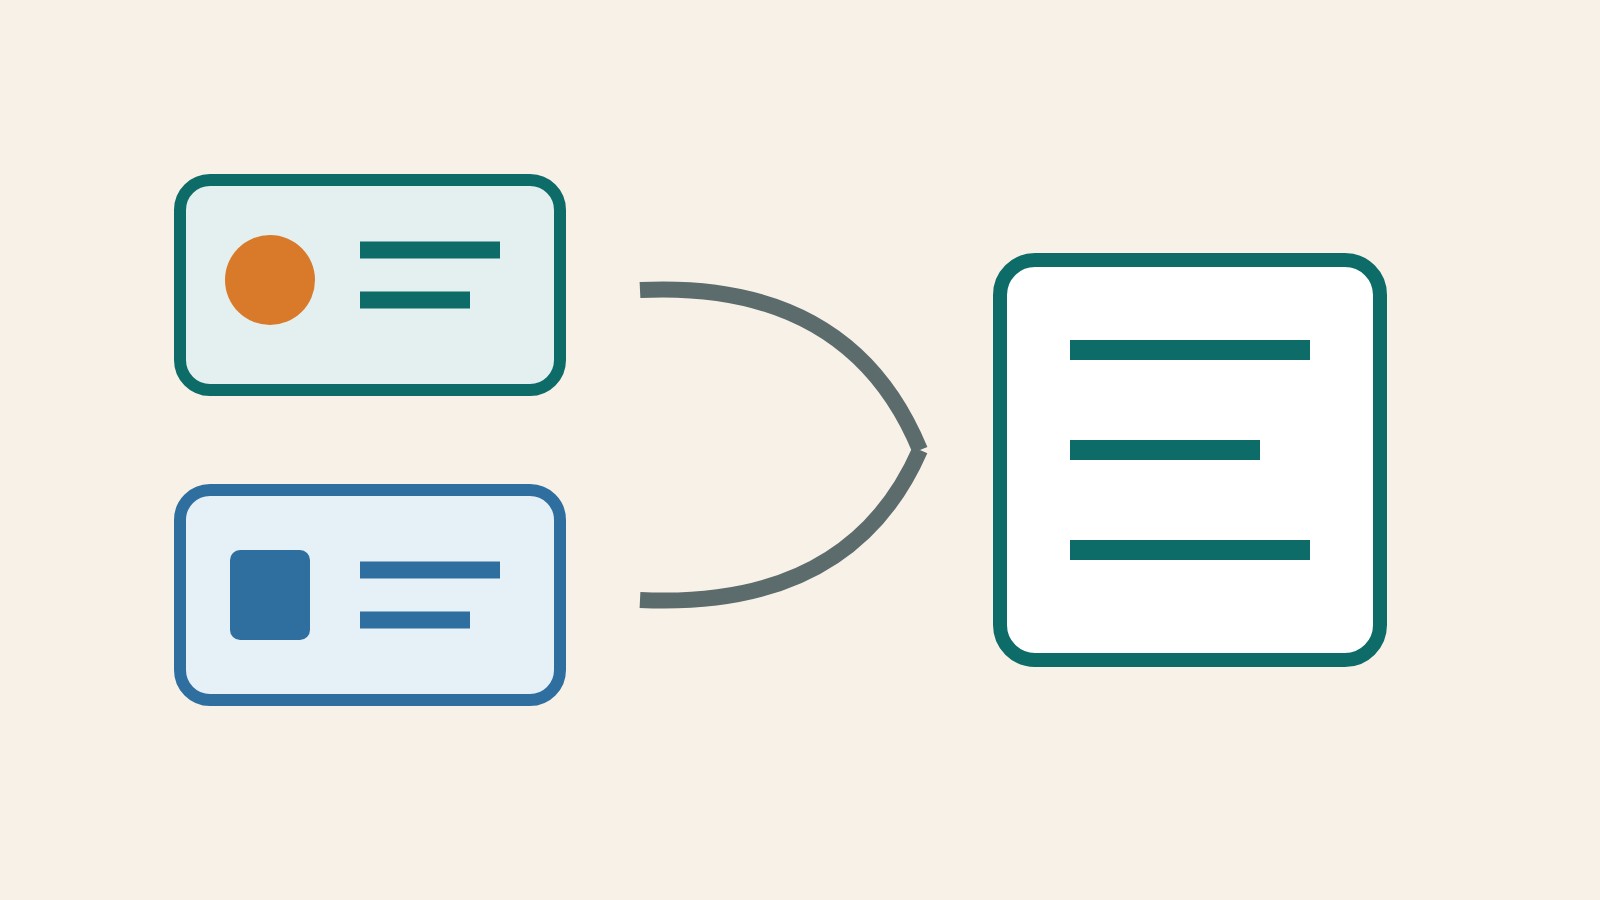
フューショットプロンプティング(Few-shot Prompting)は、入力と完成済みの出力の組を少数の例としてプロンプトに入れ、新しい入力の処理をモデルに依頼する方法です。単に「この形式に従って」と伝えるのではなく、形式の具体像、分類の境界の判断方法、情報が不完全なときの表し方を見せます。
この方法は、一般の人から寄せられた投稿を決まった項目に整理するなど、ルールを一文で説明するだけでは伝えにくい作業によく適しています。ただし、永続的な学習ではなく、例が多いほど精度が上がる保証もありません。以下では、落とし物情報を使ったオリジナルの学習用場面を通じて、例の選び方、新しい事例の確認方法、そのプロンプトを使い続ける価値があるかの判断方法を示します。
例はそのときのコンテキストに置かれ、モデルのパラメータは変更されない
Brown らの原著論文では、文章による指示と例を使い、勾配更新やファインチューニングファインチューニング(Fine-tuning):既存のモデルを自分のタスクに合わせるファインチューニングは、既存のモデルに追加学習を行い、特定のタスクや分野に適するようにする手法です。本記事では、カスタマーサポートのメール分類を例に、データ整理、パラメータ更新、テストセットの確保、バージョンのデプロイを解説します。フルファインチューニング、LoRA、教師ありファインチューニング、RAG の違いと、学習成績が良くなっても実際の性能が下がる理由も説明します。読み終えると、ファインチューニングを行う価値がある問題かどうかを判断し、形式の一貫性、未知の種類、データリーク、既存の能力の低下を確認する方法がわかります。記事全文を読むを行わずにモデルにタスクを処理させました。フューショットプロンプティングも、この実践上の要点を引き継いでいます。例をそのときの入力の一部として与え、モデルがタスクと期待される出力を理解できるようにします。これは、データを集めてからモデルのパラメータモデルパラメータ(Model Parameters)とはモデルパラメータは、入力を出力に変換するために学習時に調整される数値で、重みやバイアスなどがあります。この記事では簡単な式を使って、パラメータが予測にどう影響するかを説明し、モデルパラメータ、学習のハイパーパラメータ、プロンプト、生成設定を区別します。また、パラメータ数、数値精度、アクティブパラメータ数が異なる指標である理由も解説します。モデルの仕様をより正確に読み取り、パラメータが増えても知識が一件ずつ増えるわけではなく、チャットのたびにモデルを学習し直すわけでもないことを理解できます。記事全文を読むを再調整するファインチューニングとは異なります。
例えば、「図書館入口で黒い傘を拾いました」に対応する出力として「品物:傘;場所:図書館入口」を示すと、モデルはこの例から項目の書き方を推測できます。新しい会話を始めた際、システムが例を引き継いでいなければ、独自に決めた形式をモデルがまだ知っているとは考えられません。繰り返し使う必要があるなら、確認済みの例を再利用できるプロンプトや作業設定に保存しておきましょう。
フューショットの例の数にも、どのタスクにも通用する最適値はありません。いくつ選ぶかは、タスクの複雑さ、例の長さ、誤りの種類によって変わります。分類ルール自体が矛盾していれば、例を増やしても混乱を増すだけかもしれません。形式が特殊なら、明確な例が一つあるだけでも大きく役立つ可能性があります。決まった例の数にこだわらず、新しいデータに対する結果で判断しましょう。
詳しい説明を読む
通常例、情報欠落の例、境界例の三種類で処理ルールを定義し、新しい投稿に適用した後、例示していない別のデータで検証する。
適切な例で分類の境界を見えるようにする
落とし物情報の通常例には、品物と場所が明確なものを使えます。ただし、こうした例だけを入れると、モデルはすべての投稿に完全な情報があると誤解するかもしれません。次に用意する例では、情報の欠落を扱います。例えば「さっきカードを拾いました」なら、場所の項目は「未記載」とするのが期待される出力であり、駅や教室だと推測してはいけません。
境界例は、混同しやすいルールを伝えるのに役立ちます。例えば「イヤホンをなくしました」は落とし物を探す投稿であり、拾得を知らせる投稿ではありません。拾得情報だけを扱うシステムなら、どのようにラベル付けして「対象外」と示すかを、例で教える必要があります。傘や水筒についての似た投稿を何件も追加するより、こうした例のほうが分類の本当の境界をモデルに伝えられます。
Anthropic の公式プロンプトガイドは、関連性があり、多様で、構造が明確な例を推奨しています。この場面での多様性とは、名詞を適当に入れ替えることではありません。情報がそろっている、必須項目が欠けている、タスクの対象外である、一文に複数の品物が含まれるといった、異なる判断を網羅することです。例で示すべきなのは、単なる文体ではなくルールの分岐です。
結果を確認できる落とし物情報用プロンプトを書く
まず、短い文章で作業を定義します。「投稿が拾得物について述べているか判断し、文中に明記された品物と場所だけを抽出してください。記載のない項目は『未記載』としてください。」次に、各組の入力と期待される出力を区別して示し、モデルが例を新しい処理対象と取り違えないようにします。最後に、今回実際に整理したい投稿を独立して配置します。
新しい入力の例を見てみましょう。「運動場のそばで、誰かが置いていった保温タンブラーを見かけました。すでに持ち去られたかどうかは分かりません。」理想的な出力は、品物と場所を残しつつ、現在の状態が不確かであることを示します。既定の項目で不確実性を表せないなら、曖昧な事実を無理に「拾得済み」に当てはめるようモデルに求めるのではなく、まず項目の設計を修正すべきです。
出力後は原文と照らし合わせ、品物の名称が変わっていないか、場所が勝手に補われていないか、その場で見かけただけなのに保管済みと誤解されていないかを確認します。この確認が成功の基準です。形式が整っていても、情報を誇張していれば失敗です。一方、事実の判断は正しいのに項目が統一されていないなら、主な問題は形式の例が十分に明確でないことかもしれません。
例示用データと検証用データは分ける必要がある
モデルに教えるために使った投稿を、成績を示す唯一の根拠としても使うのは適切ではありません。見たことのある例をモデルがうまく再現できても、それで分かるのは例を再現できるということだけです。同じ判断の境界を含み、言い回しが異なる新しい投稿を別に確保しておくことで、未見の入力にもルールを適用できるか観察できます。
プロンプトの各バージョンを比較するときは、まず検証用データを固定します。ルールだけの版、通常例を加えた版、さらに情報欠落の例と境界例を加えた版を用意します。自分が最も気に入った一回の回答だけを見るのではなく、各版がどの事例で間違えたかを記録しましょう。ここではこの実験を実施していないため、正答率や改善率は提示しません。
新版で傘の投稿への対応だけが安定し、落とし物を探す投稿まで全部拾得情報として扱うようになったなら、例のバランスを見直す必要があります。例の並びや形式が暗示を与えていないかも確認しましょう。例えば、前半はいつも受け入れる例、後半はいつも拒否する例になっている場合です。固定した順番で推測しやすいパターンを作るより、内容とラベルの関係を明確にすることが大切です。
フューショットが向く場合と、別の問題に対処すべき場合
モデルが大まかな意図を理解していても、項目、文体、分類の境界をつかめていないときは、フューショットプロンプティングを試す価値が特にあります。最新のお知らせを知らない場合、例は情報検索の代わりにはなりません。元の投稿が OCR で誤って読み取られた場合も、例だけで元データを自動修復できるわけではありません。すべての失敗を例の不足のせいにしないよう、まずどの段階の誤りかを見極めましょう。
高い一貫性が求められるシステムでは、必須項目が存在するか、ラベルが許可リストに含まれるかなど、プログラムによるチェックも加えるべきです。形式の誤りは検出できますが、意味の正しさまでは完全に検証できないため、原文と抜き取り確認の手順も残しておく必要があります。モデルが有効な形式で返すことは、システムが受け取れる条件であって、内容が正しいことを意味しません。
例を整理するときは、不要な個人情報を使わないようにしましょう。落とし物情報なら、架空の内容でルールを示せます。実在する電話番号、氏名、身分証明書番号をプロンプトに繰り返し入れる必要はありません。最終的には、重要な判断を明確に伝えられる少数の例を残し、それぞれが対応するルールを記録します。そうすれば、将来改訂するときも、各例を残す価値がある理由が分かります。
チームで分類の定義を変更したら、すべての例も同時に更新しましょう。文章の説明には古いルールがあり、例には新しいルールが現れると、モデルは矛盾する手掛かりを受け取ります。各組の例の用途と最終確認日も残しておけば、引き継ぐ人が例の保守方法を理解する助けになります。
| 方法 | 与えるもの | 主な制約 |
|---|---|---|
| ゼロショットプロンプティング | ルールと新しい入力 | 形式の細部を明確に伝えにくい場合がある |
| フューショットプロンプティング | ルール、例、新しい入力 | 例が誤解を招いたり、入力領域を占めたりする場合がある |
| ファインチューニング | 学習データでパラメータを更新 | 別途、学習と評価の工程が必要 |
ゼロショットプロンプティング(Zero-shot Prompting)とは:まずタスクを明確に伝えるゼロショットプロンプティング(Zero-shot Prompting)とは:まずタスクを明確に伝えるゼロショットプロンプティングとは、解答例を示さず、ルールと新しいデータを使ってモデルに直接作業を依頼する方法です。ゼロショットは、モデルが未訓練であることや、プロンプトに資料を添えられないことを意味しません。本記事では家電の説明書を整理する例を通じて、出力項目、情報の欠落、判断範囲を明確にする書き方を説明し、フューショットプロンプティングと検索資料の用途の違いを比較します。比較表とテスト手順も掲載し、直接質問するだけで十分な場合と、例を追加すべき場合を解説します。記事全文を読む
文脈内学習(In-context Learning)とは:その場で新しいルールに適応する
AI 用語総索引:Loop Engineering から生成 AI まで
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
この記事を引用している記事
出典
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。