ライフスタイル
アテンション機構(Attention)とは:モデルは参照する token をどう決めるのか
アテンション機構は、系列内の各位置について query と key を照合して重みを求め、各位置の value を加重平均して新しい表現を作ります。2014 年の翻訳におけるアライメントから 2017 年の Transformer までをたどり、Q、K、V、自己注意、クロスアテンション、マルチヘッドアテンションを例で説明します。また、標準的な手法では計算量が長さの二乗に比例して増えることや、アテンションの重みをモデルの判断理由と直接みなせない点も取り上げます。
読了目安 13 分
目次
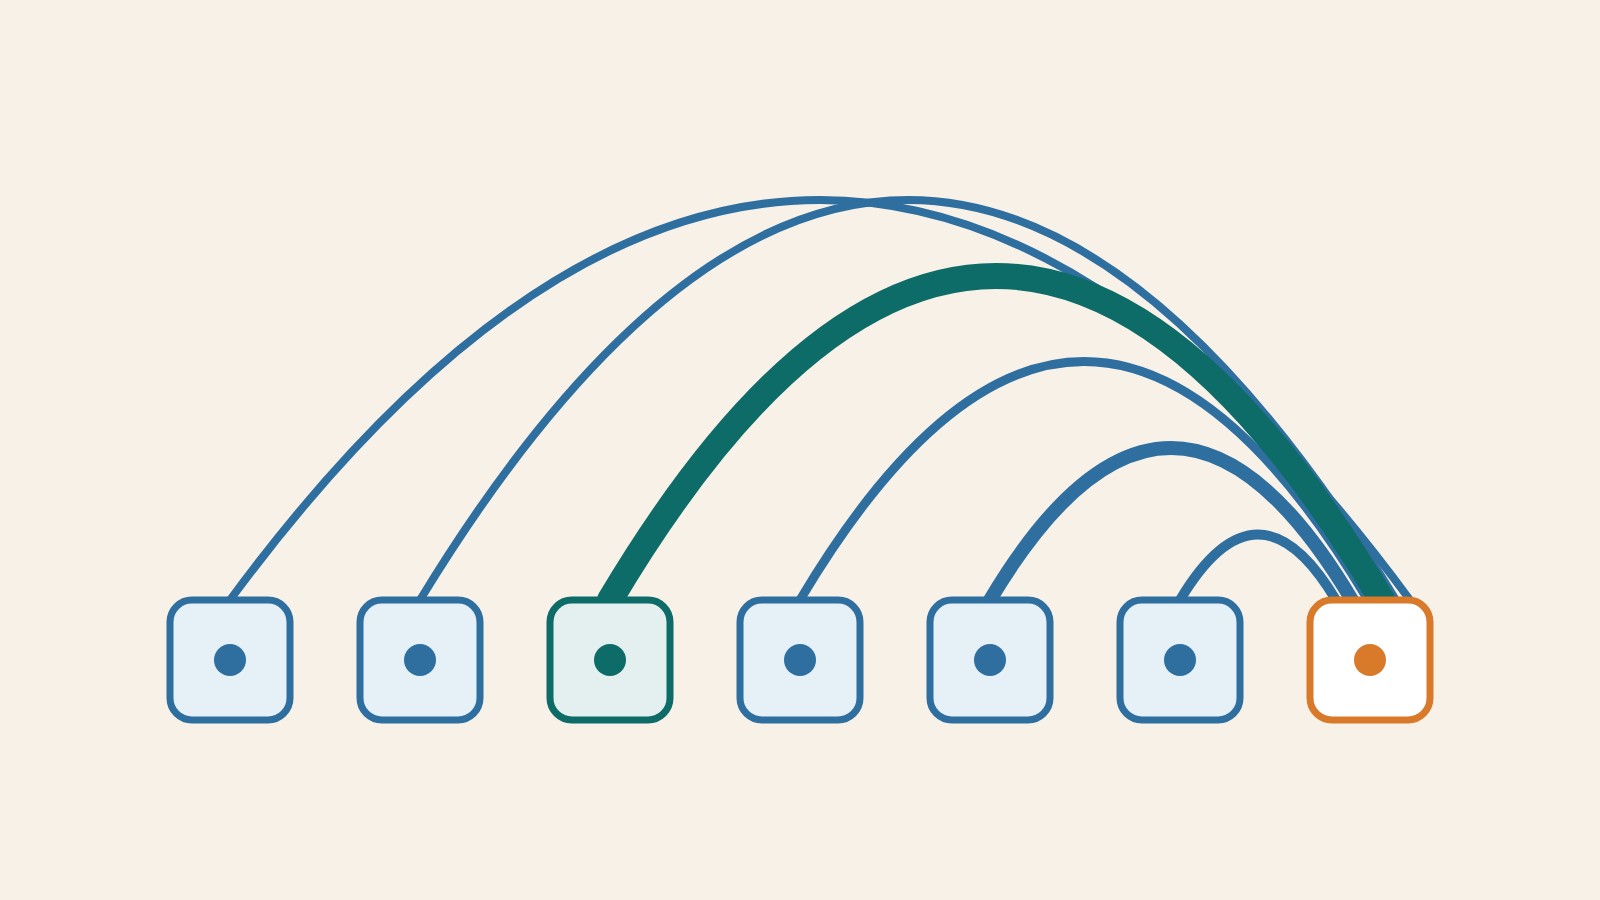
アテンション機構(Attention)は計算の一種です。系列内のある位置を処理するとき、その位置が参照できるすべての位置(自己注意では自分自身も含む)の関連度を採点し、合計が 1 になる重みに変換して、各位置の内容を加重平均し、新しい表現を作ります。「注意」は訳語であり、数学的な重み付けを指すもので、人間の意識的な集中ではありません。遠く離れた二つの単語も同じ層で直接照合できますが、標準的な手法では計算量がおおむね系列長の二乗に比例して増えます。
本記事では、翻訳のアライメント問題から Q、K、V、自己注意、マルチヘッドアテンションまでを取り上げ、重みを「モデルの判断理由」として直接読み取れない理由や、長さとコストの関係を説明します。情報は 2026 年 10 月時点のものです。「例」と記した内容は学習用に作成したもので、実測ではありません。
翻訳のアライメントからアテンションだけの構成へ
2014 年、Bahdanau らは機械翻訳に取り組みました。当時一般的だったエンコーダー・デコーダー構成は、原文全体を固定長のベクトルに圧縮してから訳文を生成していました。彼らはこれがボトルネックだと考え、デコーダーが訳文の単語を一つ生成するたびに、原文の各位置の表現を採点して重みに変換し、加重平均によって、そのステップ専用のコンテキストベクトルを求める方式に変更しました。採点には、翻訳モデルと一緒に学習する小規模な順伝播型ニューラルネットワークニューラルネットワーク(Neural Network)とは:層と重みから成り、データから学習する関数ニューラルネットワークは、単純なユニットを多層に組み合わせた関数です。各ユニットは重み付き和を計算し、多くの場合は非線形変換を加え、重みはデータから調整します。二つのスイッチで廊下の照明を操作する手計算の例で、順伝播、損失、逆伝播、勾配降下法を説明し、学習と推論を区別します。さらに、パラメータ数、ニューロン数、能力の違いと、深層学習や Transformer との関係を整理します。記事全文を読むを使いました。この論文の英仏翻訳実験では、基本構成の性能は文が長くなるにつれて明らかに低下しましたが、最大 50 語の文で学習したアライメント版は、50 語を超える文でも性能が低下しませんでした。これは同論文の設定下で得られた結果です。
2017 年、Vaswani らは、当時のアテンションの多くがリカレントネットワークと併用されていると指摘し、再帰や畳み込みを使わず、アテンションに全面的に依存するTransformer アーキテクチャTransformer アーキテクチャ(Transformer)とはTransformer は、アテンション機構で系列内の関係を処理するニューラルネットワークのアーキテクチャで、多くの言語モデルやマルチモーダルモデルの重要な基盤です。本記事では、活動のお知らせに含まれる代名詞や語順を例に、自己アテンション、位置情報、フィードフォワードネットワーク、マスクがどう連携するかを説明し、当初のエンコーダー・デコーダー設計と後の派生形を区別します。モデルが文脈をどう利用するかを理解するとともに、アテンションの重みは人間の注意や意思決定の完全な説明ではなく、長い系列には計算と検証のコストが伴うことも学べます。記事全文を読むを提案しました。論文では、アテンションを、一つの query と「key-value のペア」の集合を一つの出力に写像するものと定義しています。出力は各 value の加重和で、重みは query と各 key の適合度を測る関数から求めます。
Q、K、V:照合、重み付け、混合
各位置(言語モデルでは通常、一つの token)は、学習した三組の行列を使って、それぞれ query、key、value のベクトルに変換されます。大まかに言えば、query は「何を探すか」、key は「自分がどのように照合されるか」、value は「選ばれたときに渡す内容」です。三つとも学習によって得られる数値であり、誰かがあらかじめ単語に主語や代名詞のラベルを付けているわけではありません。
- query と各位置の key の内積を取り、スコアを求めます。
- スコアを key の次元数の平方根で割ります。原論文では、これにより次元数が大きいときに内積が大きくなりすぎ、softmax の勾配が小さくなりすぎるのを防げると推測しています。
- softmax を使い、非負で合計が 1 になる重みに変換します。
- その重みで各位置の value を加重平均し、新しい表現を求めます。
例(学習用。単語の区切りは説明のためのもので、実際のモデルで測定したものではありません):「小雅はスーツケースをトランクに入れた。それが重すぎたからだ。」「それ」を処理するとき、重みがスーツケース 0.55、トランク 0.25、小雅 0.10、残りの単語の合計 0.10 で、総和は 1 だと仮定します。「それ」の新しい表現は各 value を混ぜたもので、スーツケースが最も大きな割合を占めます。
スーツケースとトランクの重みを入れ替えると、新しい表現はトランク寄りになり、後続の層が「重すぎる」を誤った対象に結び付ける可能性があります。実際のモデルの重みは取り出さなければ分かりませんし、重みは混合比率にすぎず、最終的な答えではありません。
詳しい説明を読む
「それ」を query として、小雅、スーツケース、トランク、残りの単語の key と照合し、softmax で重みに変換する。例示の重みは順に 0.10、0.55、0.25、0.10 で、合計は 1。その重みに従って各位置の value を混ぜ、「それ」の新しい表現を得る。スーツケースの内容が最も大きな割合を占める。重みは学習用の例であり、実測値ではない。
自己注意とクロスアテンション
両者の違いは query、key、value の出所であり、計算方法は同じです。自己注意(self-attention)では、三つとも同じ系列から得られます。クロスアテンション(cross-attention、原論文では encoder-decoder attention)では、query はデコーダーから、key と value はエンコーダーの出力から得られます。Bahdanau らの機構もデコーダーが原文を参照する仕組みですが、内積ではなく小規模なネットワークで採点します。デコーダーの自己注意にはさらにマスクを加え、各位置から自分自身とそれ以前の位置だけを参照できるようにします。
マルチヘッドアテンションは何をするのか
マルチヘッドアテンション(multi-head attention)は、それぞれ学習した射影を使って query、key、value を h 組の小さなベクトルに変換し、各組で並列にアテンションを計算してから、連結して元の次元数に射影します。原論文の基本設定は 8 ヘッド、各ヘッド 64 次元、モデルの次元数 512 で、総計算量は全次元を使う単一ヘッドとほぼ同じです。著者らは、複数のヘッドによって、異なる表現部分空間や異なる位置から同時に情報を取り込めると説明しています。単一ヘッドでは、加重平均がそれを妨げるというのが理由です。
ただし、各ヘッドが特定の意味を固定的に担当するということではありません。同論文の英独翻訳におけるアブレーション実験(総計算量を固定)では、単一ヘッドは最良の設定より性能が低く、ヘッド数が多すぎても品質が下がりました。付録の図には、エンコーダーの第 5 層(全 6 層)の二つのヘッドが、英語の代名詞 its を処理する際の重みが示されています。著者らは、これらが代名詞の指示対象に関係している「ように見える」と述べていますが、これは特定のモデル、層、文についての観察であり、別のモデルでも再現するとは限りません。
アテンションの重みはモデルの判断理由ではない
重みはよくヒートマップで示され、まるで「モデルはこの単語があるから、こう答えた」と語っているように見えます。Jain と Wallace(NAACL 2019)は、この直感を検証しました。アテンションを備えた双方向 LSTM を使い、英語のテキスト分類、質問応答、自然言語推論を行いました。その結果、リカレントエンコーダーのアテンションの重みと、「どの単語が重要か」を測るほかの二つの指標(勾配、単語を取り除いた後の出力の変化)との相関は弱めで、一貫性もありませんでした。他のパラメータを固定しても、重みの集中先が異なるのに予測がほとんど変わらない重みを、別途構成できることがよくありました。彼らは、標準的なアテンションを意味のある説明とみなすべきではないと主張しました。
Wiegreffe と Pinter(EMNLP 2019)は、二重否定のタイトルで応答しました。彼らは相関についての実験には説得力があるとしつつ、後半の議論に異を唱えました。結論は「説明」の定義に左右され、モデルの計算を忠実に反映することを求めるのか、人が理解でき、筋が通ることだけを求めるのかでは、基準が異なるというのです。また、反例を作る際に、モデルのほかの部分を考慮せず、重みだけを変えてはいけないとしました。彼らは代わりにモデル全体を一緒に学習させ、集中先の異なる「敵対的」な重みを見つけ、それを固定した重みとして、文脈を参照できない単純な診断モデルに使わせました。英語の二値分類用データセット四つのうち、三つでは、元々学習された重みを使った場合より成績が明らかに劣りました。残る一つでは両者が同程度で、著者らはそのデータセットの特性に関係すると考えました。これを根拠に、先行研究はアテンションが説明に役立たないことを証明していないと主張しました。ただし、一部の分類タスクでは実際にこうした敵対的な重みを見つけられることも確認しており、先行手法で見つかったほど極端ではないという違いがあります。
両論文が主に研究したのは、アテンションを備えたリカレントモデルと英語のタスクであり、現在の大規模 Transformer 言語モデルを直接検証したものではありません。どちらの結論も、そのまま一般化することはできません。確実に言えるのは、重みが表すのは、ある層のあるヘッドが内容を混ぜる割合であり、その後にも多くの層があるため、一枚の重みの図だけでは、答えを生んだ因果的な根拠として不十分だということです。
系列が長くなるときのコストとコンテキストウィンドウ
標準的な自己注意では、すべての位置をすべての位置と組み合わせるため、n 個の token に対して n 掛ける n 個のスコアがあります。長さが倍になると、組み合わせの数は約四倍になります。原論文の Table 1(下表参照。n は系列長、d は表現の次元数)では、いくつかの種類の層を比較しています。自己注意の計算量は n の二乗に比例して増えますが、任意の二つの位置間の最長経路長は定数オーダーです。どれほど離れた二つの単語でも、一つの層で直接照合できます。一方、リカレント層の経路長は n に比例して増えます。
| 層の種類 | 層ごとの計算量 | 任意の二つの位置間の最長経路長 |
|---|---|---|
| 自己注意 | O(n²·d) | O(1) |
| リカレント層 | O(n·d²) | O(n) |
| 近傍の r 個の位置だけを見る自己注意 | O(r·n·d) | O(n/r) |
これが、入力が長くなると必要な計算量やメモリ量も増える理由の一つです。ただし、実装によって違いがあります。FlashAttention の論文も、自己注意の時間計算量とメモリ計算量が長さの二乗に比例すると指摘し、「厳密な」(exact)アルゴリズムを提案しています。数学的には同じアテンションを計算しつつ、GPU メモリの読み書きを減らして高速化するため、実際の速度は二乗の式だけでは推定できません。また、ウィンドウに収まることと、うまく活用できることは別です。Liu ら(TACL 2024)は、複数文書を使う質問応答とキー・バリュー検索の実験で、関連情報が長い入力の中ほどにあると、冒頭や末尾にある場合より性能が明らかに劣る傾向を観察しました。関連項目:コンテキストウィンドウ。
token を一つずつ生成するときは、KV キャッシュを使えると Hugging Face の公式ドキュメントは説明しています。以前の token の key と value を保存し、各ステップでは新しい token の分だけを計算しますが、その代わりにメモリ使用量は系列長に比例して増えます。
関連用語をさらに読むには、AI 用語総索引から始めてください。
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
出典
- Bahdanau、Cho、Bengio:アライメントと翻訳を同時に学習するニューラル機械翻訳(arXiv:1409.0473、ICLR 2015)確認日:
- Vaswani ら:必要なのはアテンションだけ(arXiv:1706.03762)確認日:
- Jain、Wallace:アテンションは説明ではない(arXiv:1902.10186)確認日:
- ACL Anthology:アテンションは説明ではない(NAACL 2019、N19-1357)確認日:
- Wiegreffe、Pinter:アテンションが説明ではないわけではない(arXiv:1908.04626)確認日:
- ACL Anthology:アテンションが説明ではないわけではない(EMNLP 2019、D19-1002)確認日:
- Dao ら:FlashAttention:IO を考慮した高速でメモリ効率のよい厳密なアテンション(arXiv:2205.14135)確認日:
- Liu ら:中間で見失う:言語モデルは長いコンテキストをどう使うか(arXiv:2307.03172、TACL 2024)確認日:
- Hugging Face Transformers 公式ドキュメント:キャッシュの仕組み(KV キャッシュ)確認日:
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。