教學
與旅行無關的分享:AI 工具與教學、軟體、3C 裝置與日常心得。
生活分享
Claude Code|建立第一個 mod:在 Claude Code 行程內數工具呼叫
寫一個三檔案的 mod,用驗證器與測試確認它掛上的事件。文件把 mod 定義成多了入口檔的 plugin:入口檔叫 hooks module,Claude Code 在事件發生時呼叫裡面的函式,函式可以觀察、改寫或接手事件。
- AI 工具
- 教學
- Claude Code
生活分享
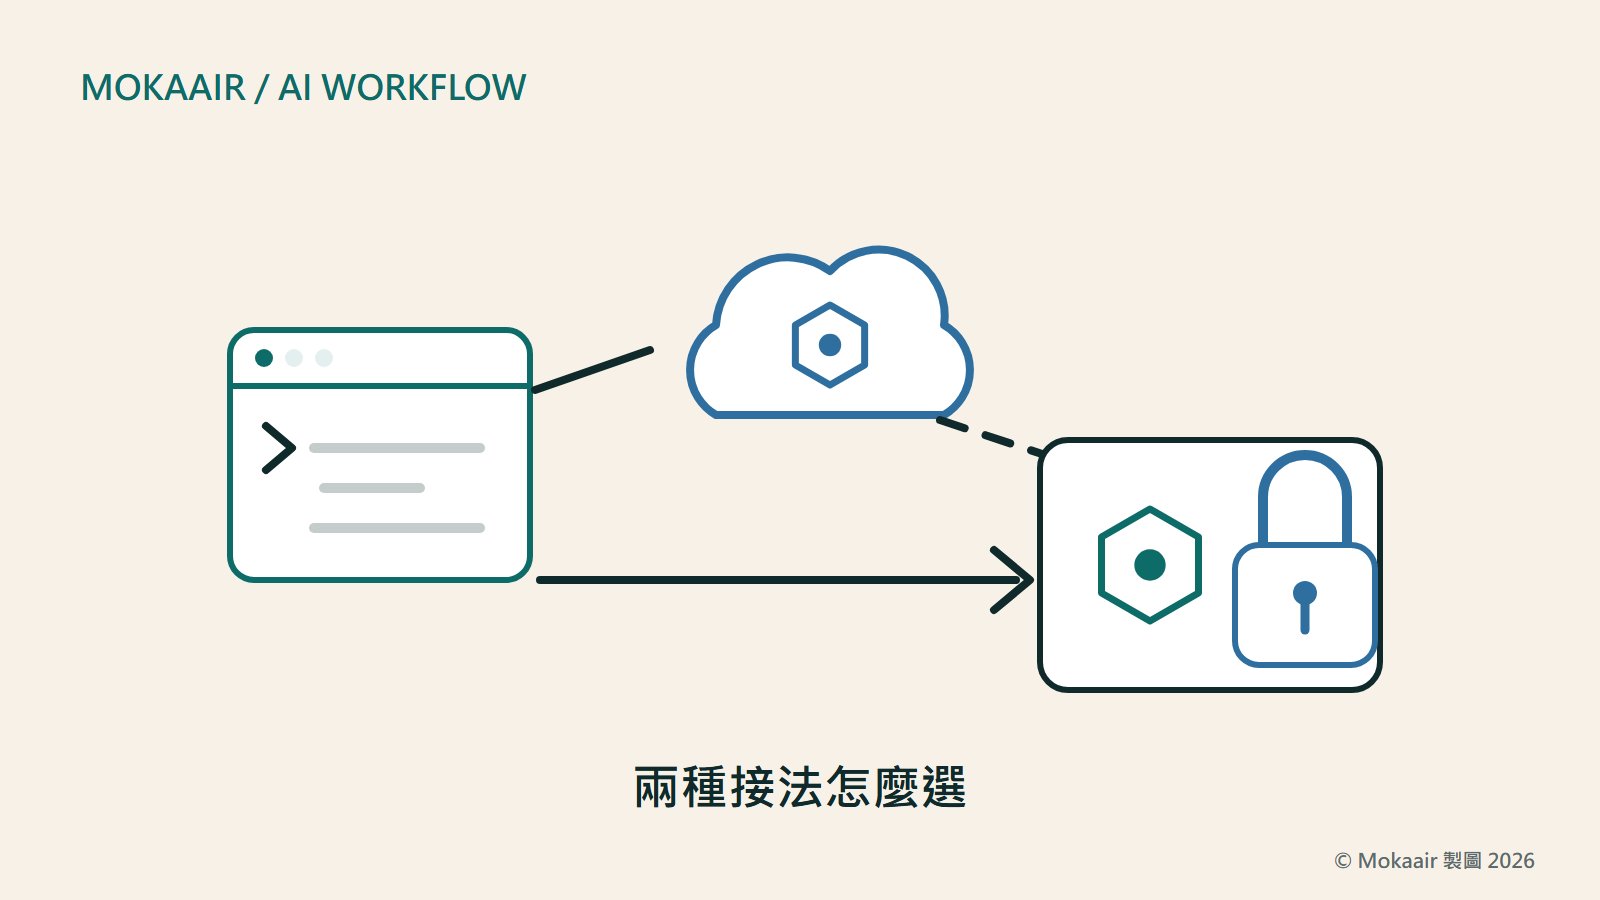
Claude Code、Codex 搭本機模型:兩種接法怎麼選
Claude Code 與 Codex 搭配本機模型有兩種接法:代理照常連雲端、把大量雜務交給腳本或 MCP 工具去問本機模型,或是把代理的模型整個換成本機模型。這篇用資料能不能出門、上下文開得夠不夠長、工作的類型三個問題幫你選,並對照 Ollama、LM Studio、Anthropic 與 OpenAI 的官方文件,分清楚本機權重、Ollama 的 cloud 標籤與供應商端點是三種不同的東西。
- AI 工具
- 教學
- AI 寫程式與本機模型
生活分享
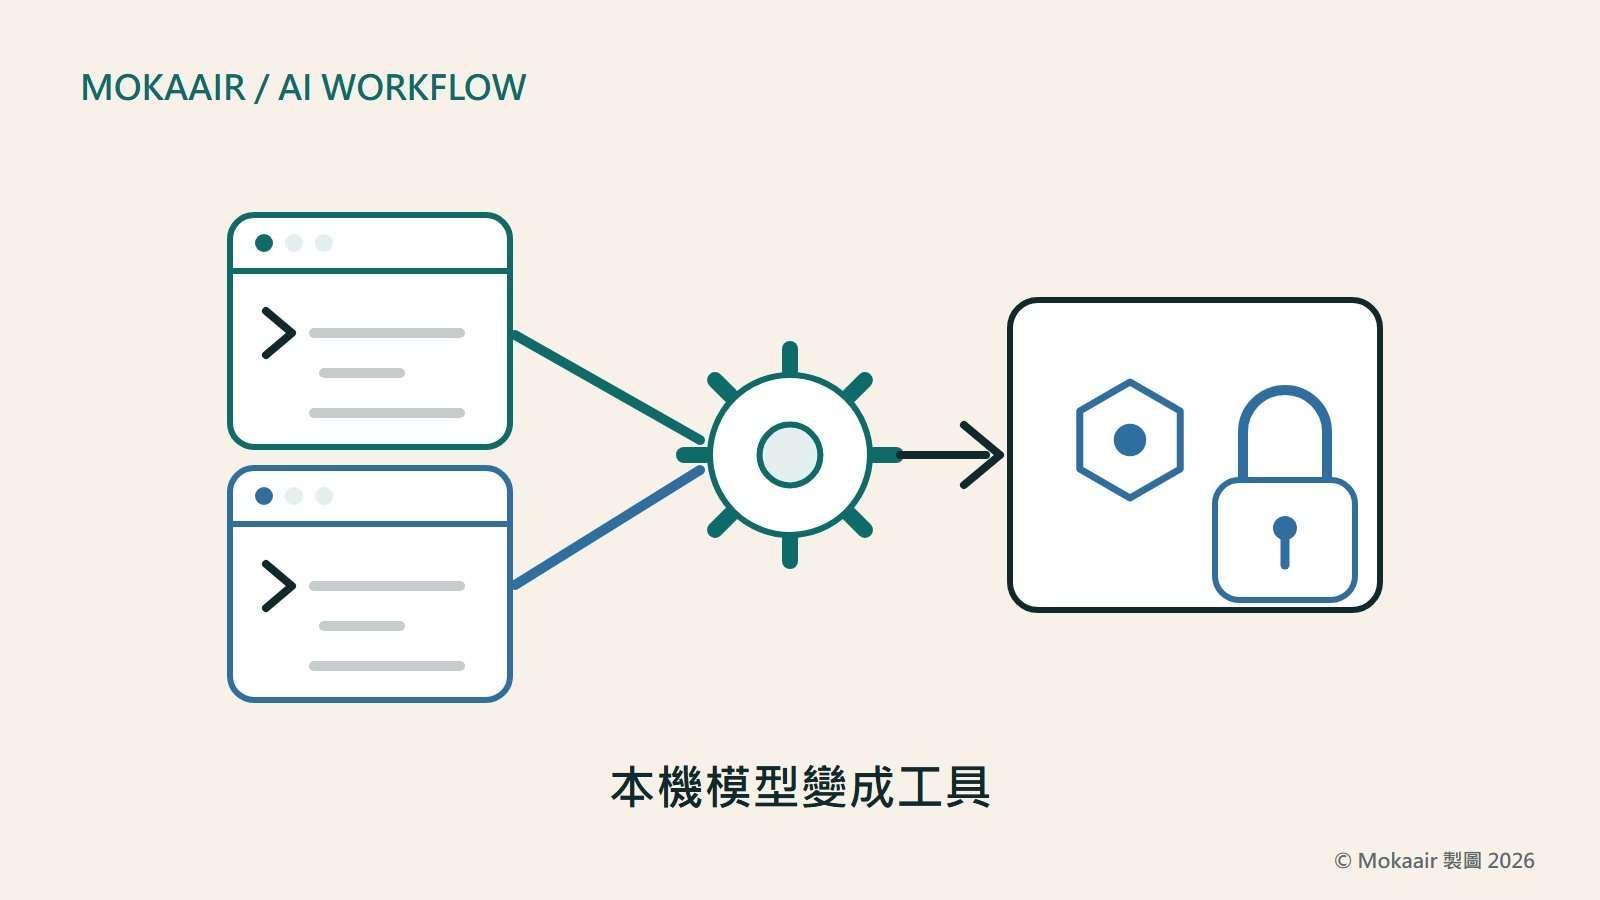
把本機模型包成 MCP 工具,Claude Code 與 Codex 共用一支伺服器
用官方 Python SDK 寫一支 stdio 的 MCP 伺服器,把本機的 Ollama 模型包成工具,Claude Code 與 Codex 就能共用:工具只收 inbox 底下的路徑,只回分類結果與結果檔路徑,不回信件原文。文中列出兩邊的登記指令、逾時與輸出上限的官方預設值,以及換成別家本機模型只改環境變數 LOCAL_MODEL 的做法,步驟都來自官方文件。
- AI 工具
- 教學
- AI 寫程式與本機模型
生活分享
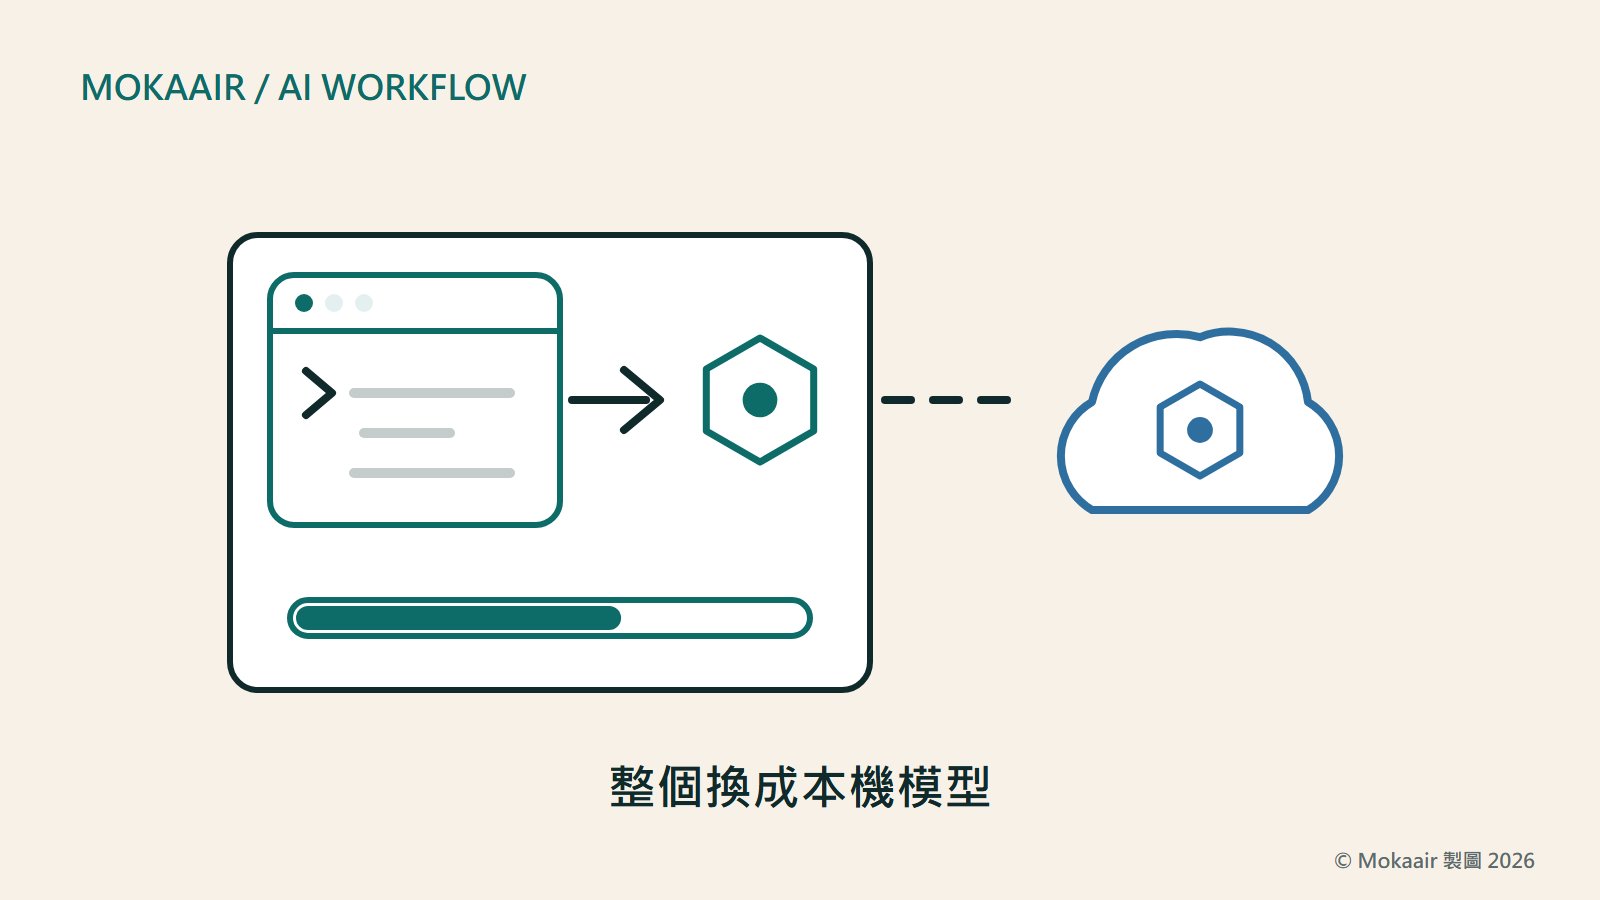
把 Claude Code、Codex 整個換成本機模型:Ollama 與 LM Studio 設定與還原
Ollama、LM Studio 與 Codex 的文件寫了把 Claude Code、Codex 整個換成本機模型的接法:Ollama 用 ollama launch 一行指令或手動設定,LM Studio 先開本機伺服器再設環境變數或加 --oss。這篇把四種組合的指令、兩家文件建議的上下文長度、Claude Code 用 /status 確認連到誰的方法,以及用完怎麼還原整理在一起;需要先裝好 Ollama 或 LM Studio,並且已有 Claude Code 或 Codex。
- AI 工具
- 教學
- AI 寫程式與本機模型
生活分享
Claude Code、Codex 搭本機模型的注意事項:開工前的檢查清單
Claude Code 或 Codex 搭本機模型之前,先照一張表逐項核對:代理讀不讀得到原始檔、現在連的是誰、標籤是不是 :cloud、上下文實際開多長、逾時與輸出量、怎麼驗收。每一項寫怎麼檢查,並指出詳見同組哪一篇,另外收進供應商端點、條款與授權、繁體中文用字檢查;檢查方法取自 Anthropic、OpenAI、Ollama 與 DeepSeek 的官方文件。
- AI 工具
- 教學
- AI 寫程式與本機模型
生活分享
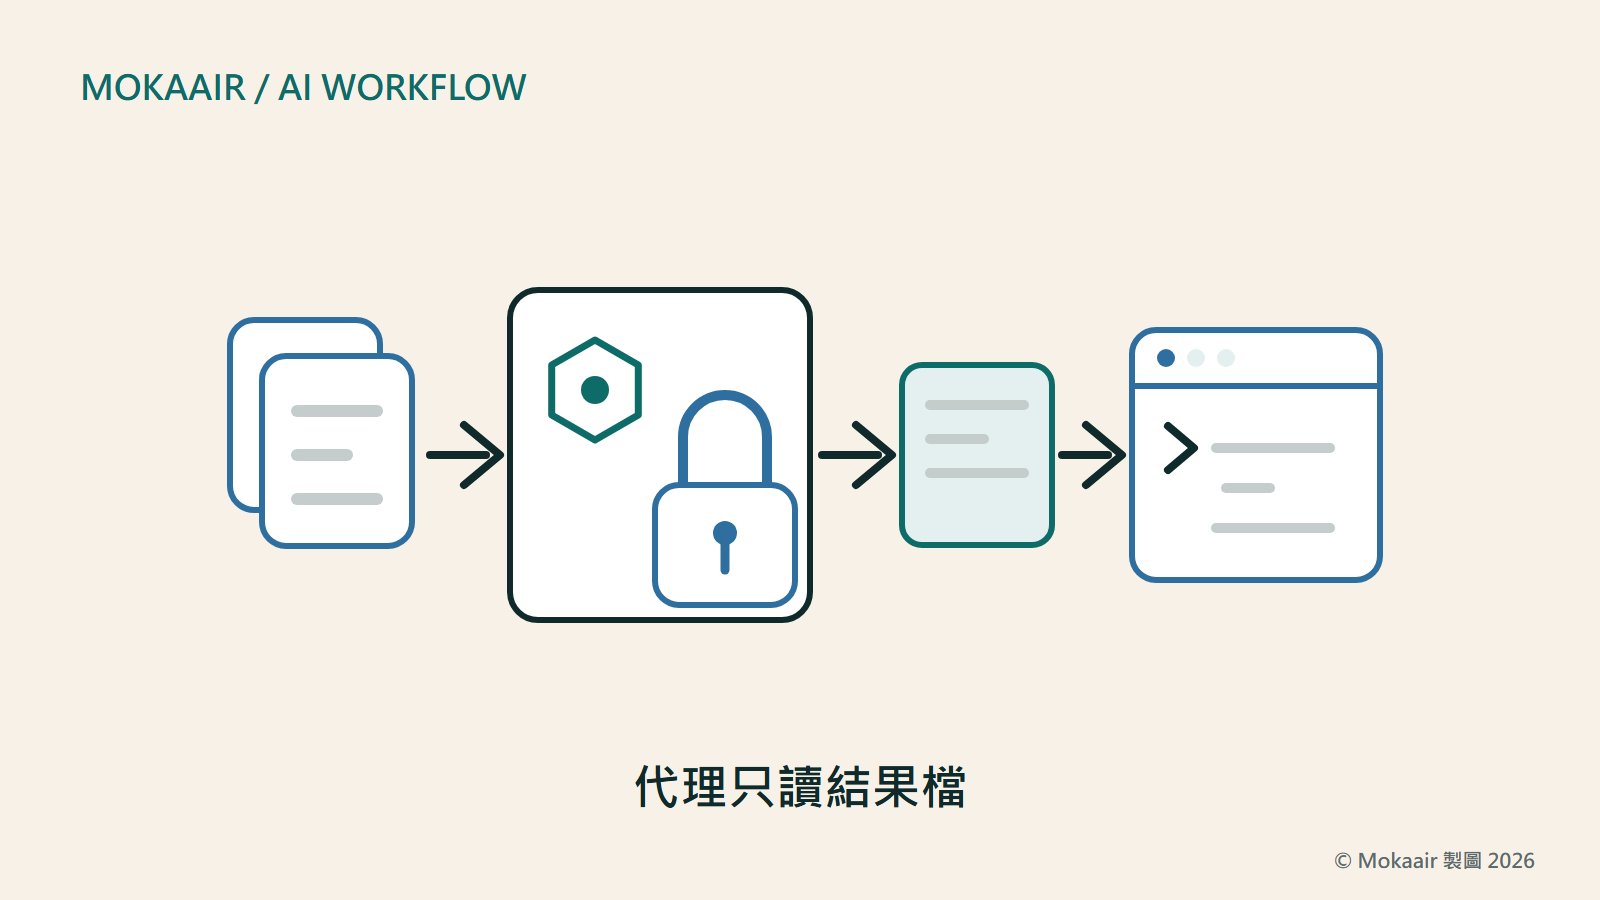
讓 Claude Code、Codex 把大量雜務交給本機模型:一支 Python 腳本
要讓雲端代理處理一批含個資的文字檔又不讓它讀原始檔,可以把這件事交給一支不到 80 行的 Python 腳本:腳本逐封問本機的 Ollama 模型,用 JSON schema 要求固定欄位,結果寫成 out 資料夾,代理只讀結果。Claude Code 讓代理自己執行腳本,Codex 這一路由你先執行;文中寫清楚 deny 規則與 Codex 的 permission profile(beta)各擋得住什麼,以及逾時、分批與失敗標記;換模型只改 LOCAL_MODEL。
- AI 工具
- 教學
- AI 寫程式與本機模型
生活分享
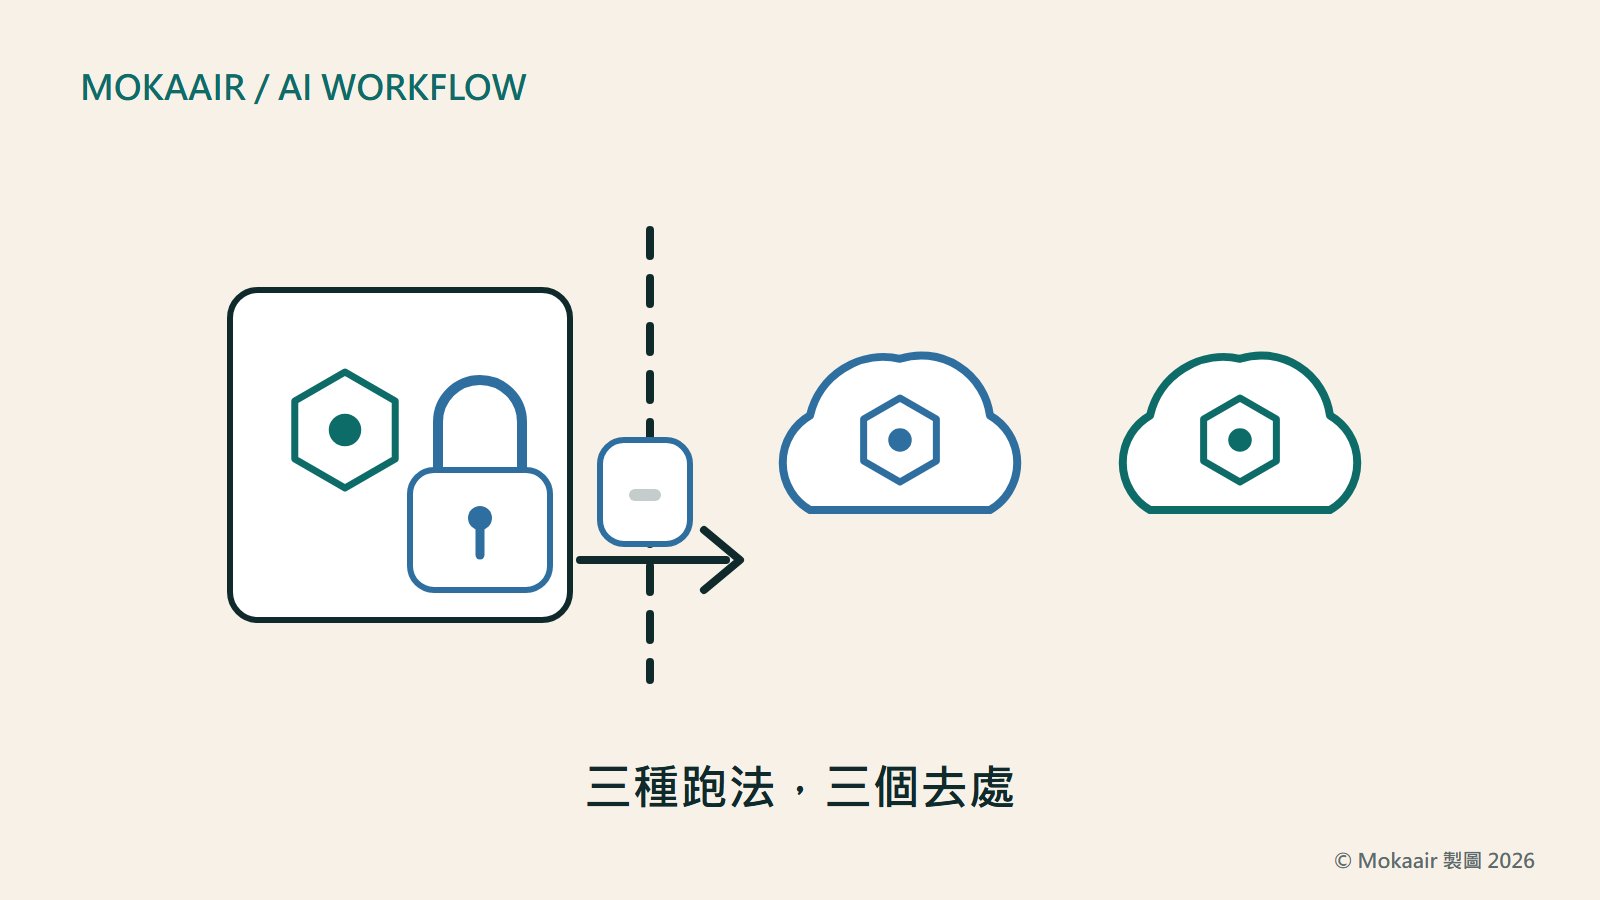
GLM、Qwen、DeepSeek 接上 Claude Code 與 Codex:哪些在本機、哪些其實在雲端
同一個模型名字有三種跑法:權重下載到自己電腦、Ollama 的 :cloud 標籤、供應商自己的端點,只有第一種的提示詞由自己的電腦處理。這篇照 2026 年 10 月 3 日重讀的官方頁,逐家寫 Qwen、GLM、DeepSeek 在 Ollama 有哪些標籤能下載、哪些只有 :cloud,並整理 Z.ai、DeepSeek、阿里雲百鍊接 Claude Code 與 Codex 的端點設定,每一處都標明資料會送到哪裡。
- AI 工具
- 教學
- AI 寫程式與本機模型
生活分享
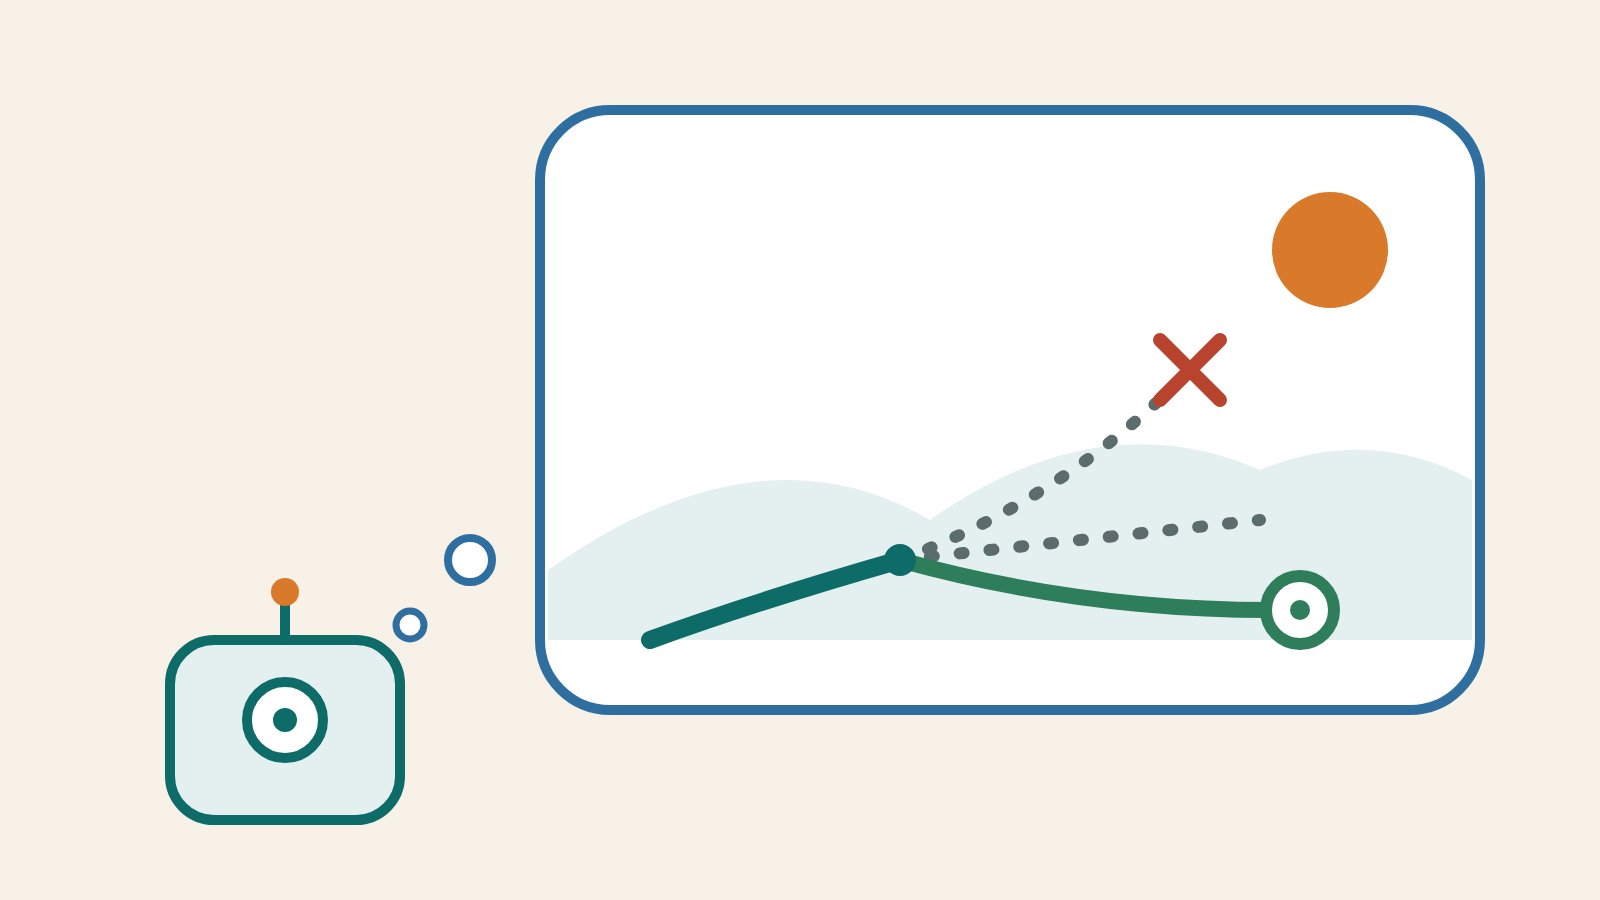
世界模型(World Model)是什麼:讓 AI 預測「接下來會怎樣」
世界模型指 AI 內部用來預測「這樣做之後會怎樣」的模型,但這個詞至少有三種用法:強化學習代理在想像中練習用的環境模型、LeCun 主張預測抽象表示的架構路線,以及能隨操作即時生成畫面的互動環境。內容用示例說明怎麼在想像中規劃,並列出大型語言模型有沒有世界模型的正反研究,附讀新聞時的檢查問題。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
視覺語言模型(VLM)是什麼:讓 AI 讀圖片、再用文字回答
視覺語言模型(VLM)能同時接收圖片與文字,再用文字回答。內容拆解視覺編碼器、連接層與語言模型三段結構,說明 CLIP、Flamingo、LLaVA 三篇論文各補上哪一塊,並和多模態 AI、文字生圖分清楚;也整理它常犯的錯:數錯數量、搞混位置、說出圖裡沒有的東西,附上讀收據時逐行核對的步驟。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
溫度(Temperature)是什麼:AI 回答變化程度的取樣參數
溫度(temperature)是文字生成時調整取樣的參數,讓模型從下一個 token 的機率分布裡抽得更集中或更分散。用假想的台南早餐示例算出低溫與高溫的差別,說明 top-p 的來源和它與 top-k 的差別,並依官方文件與論文指出:調低溫度不代表更準,設成 0 也不保證每次相同,部分模型還不開放調整。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
合成資料(Synthetic Data)是什麼:兩種用途、品質控管與模型崩潰
合成資料是由演算法或模型產生、模仿真實資料特徵的資料,常見用途有兩種:訓練模型,以及在隱私需求下替代真資料。內容依 Self-Instruct、模型崩潰研究(替換與累積資料的差別)與 NIST、ICO 的隱私文件,說明做法、抽查流程,以及它不能保證的事。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
迎合(Sycophancy)是什麼:AI 為什麼順著你說,怎麼問才不被帶著走
迎合(Sycophancy)指 AI 順著使用者的立場改變答案,犧牲正確性。內容依 Perez、Sharma、Cheng 等人的論文與 OpenAI 對 2025 年 4 月事件的公開檢討,說明研究怎麼量測、可能的成因、它與幻覺的差別,並用同一題問三次的示例,教你判讀差異與降低被帶著走的機率。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
結構化輸出(Structured Outputs)是什麼:讓 AI 照固定格式交資料
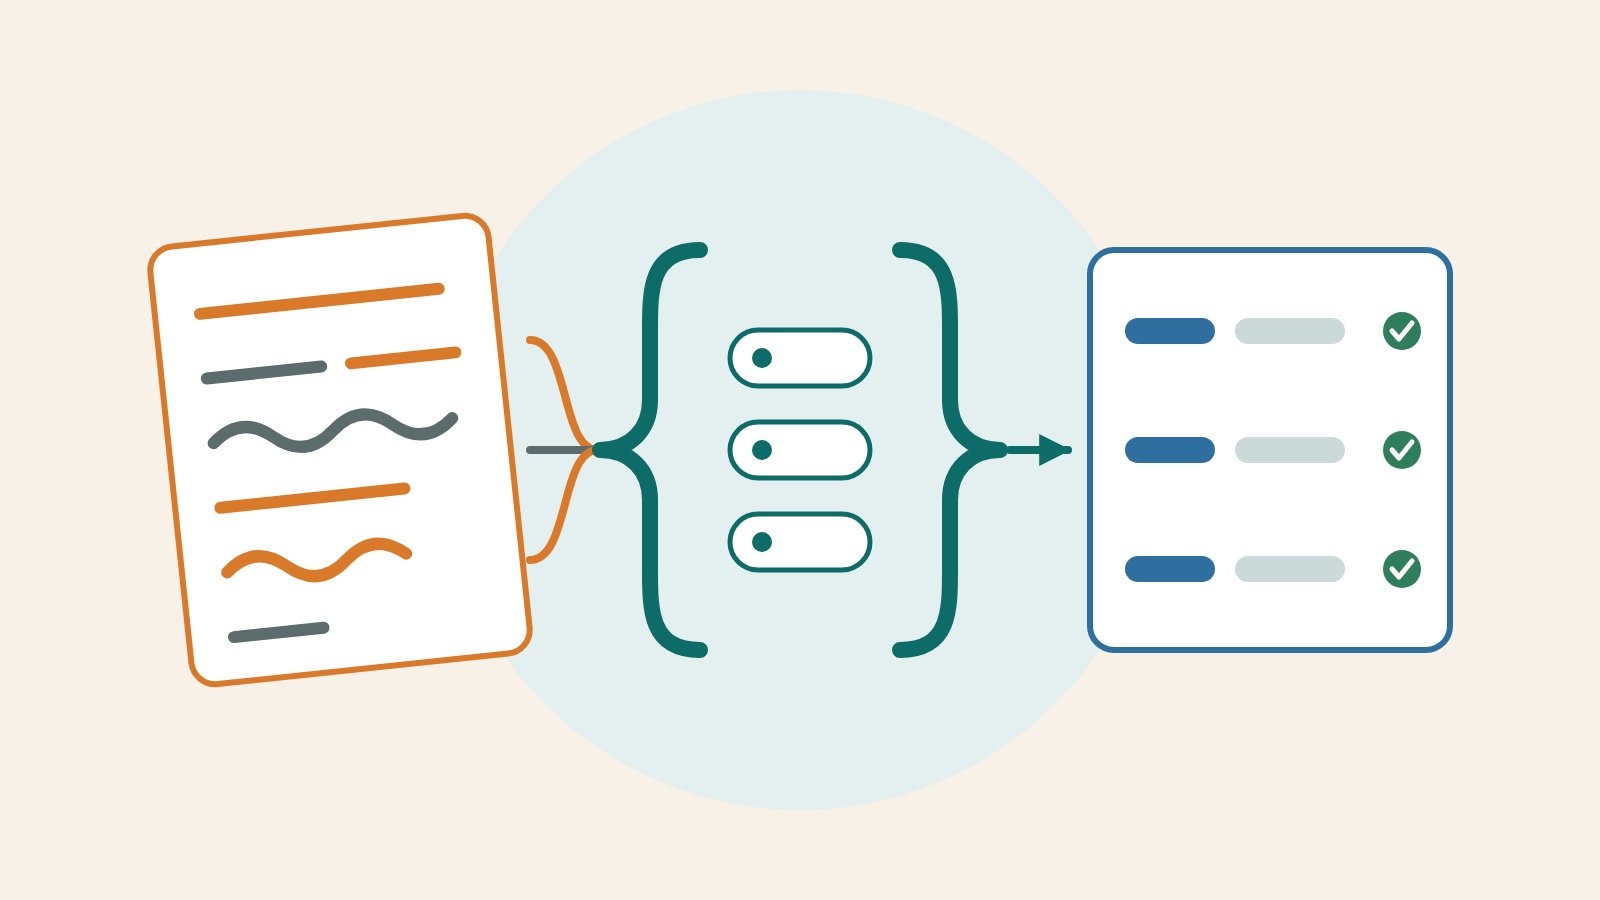
結構化輸出讓模型依 JSON Schema 產生固定欄位的資料,程式才能直接讀取。內容區分提示詞要求 JSON、JSON 模式與 schema 限制三種做法,用虛構報名信示範缺值與拒答的處理,整理三家官方文件列出的限制,並說明格式合法不等於內容正確。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
縮放定律(Scaling Laws)是什麼:規模變大,損失與能力怎麼變
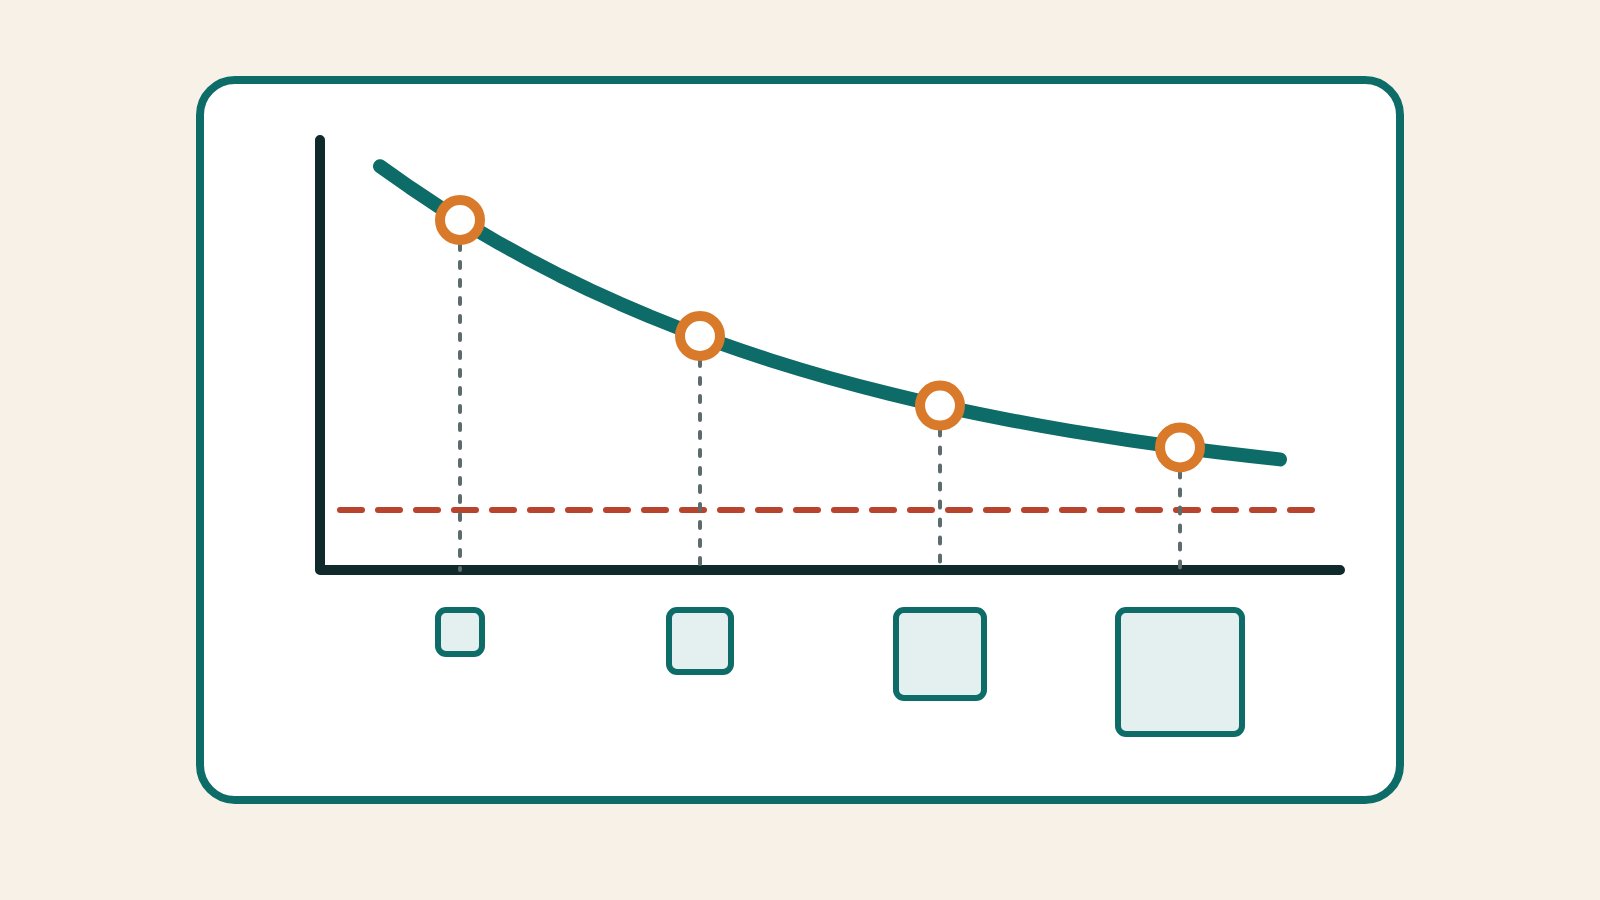
縮放定律是從訓練實驗擬合出的經驗規律:在特定設定下,語言模型的損失隨參數量、資料量與訓練計算量近似冪律下降。內容說明 Kaplan 與 Chinchilla 對預算分配的不同結論與成因、損失與任務表現的落差、湧現能力的兩種說法、推論時計算的縮放,以及如何閱讀「縮放撞牆」的新聞。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
獎勵駭客(Reward Hacking)是什麼:AI 拿到高分,卻沒做到你要的事
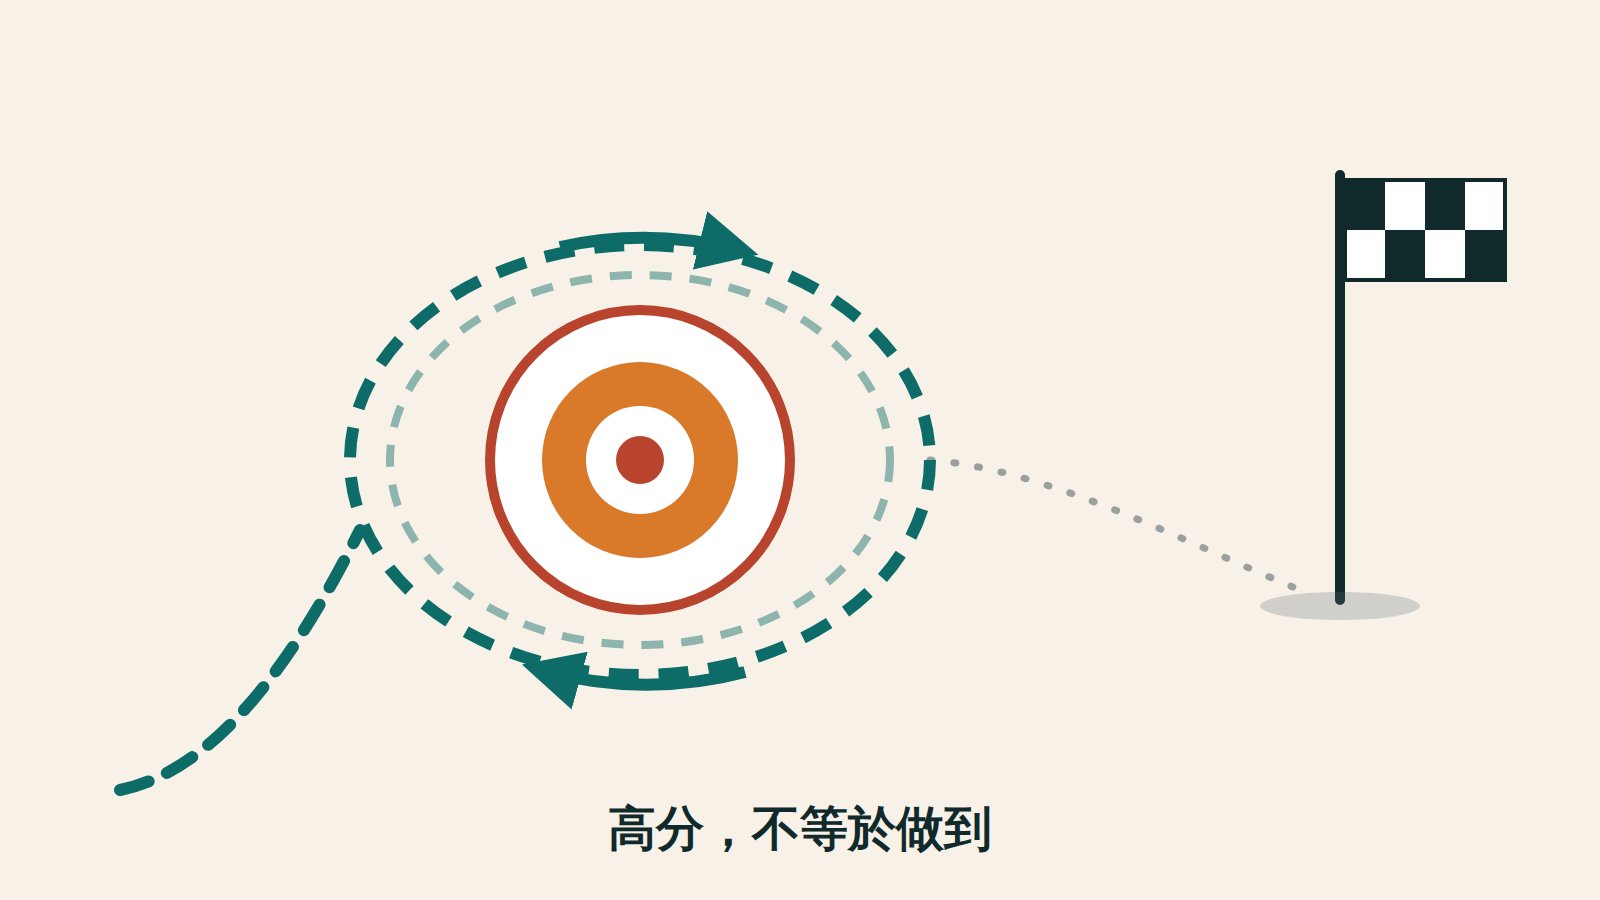
獎勵駭客(Reward Hacking)指 AI 找到讓獎勵或評分變高、卻沒達成設計者目的的做法。內容依原始論文與官方研究,說明它和規格鑽漏洞、古德哈特定律的關係,拆解強化學習、RLHF 與寫程式代理三個實例,並整理評測、多種訊號、人工抽查與推理監看各自的限制,以及它和對齊、迎合的關聯。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
強化學習(Reinforcement Learning)是什麼:靠獎勵一步步試出做法
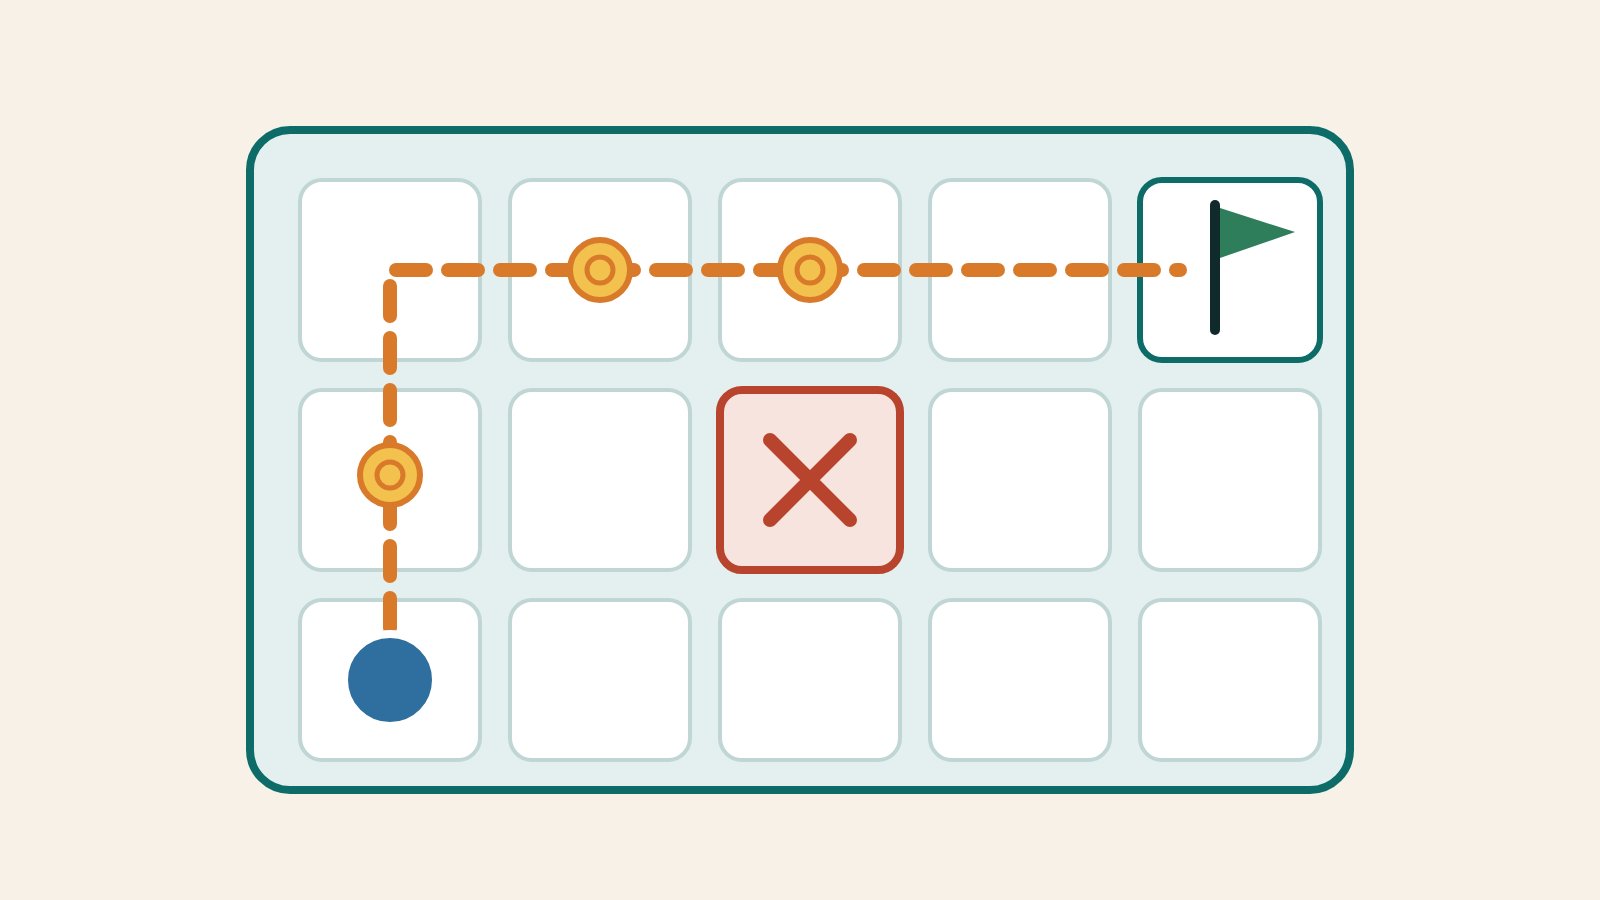
強化學習讓代理在環境中採取動作,依環境回饋的獎勵數字調整策略,目標是長期累積的回報最大。內容用格子世界示例說明狀態、動作、獎勵、策略與回報,對照監督式與非監督式學習,解釋探索與利用的取捨,再談語言模型裡的偏好獎勵與可驗證獎勵,以及獎勵設計不良時為什麼會被鑽漏洞。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
速率限制(Rate Limit)是什麼:API 為什麼回你 429
速率限制是 API 在一段時間內允許的請求數或 token 數上限,超過時通常回 HTTP 429,也可能附 Retry-After 告訴你等多久。依 RFC 與 OpenAI、Anthropic、Google 官方文件,說明 RPM、TPM 怎麼算、哪些 429 不該重試、退避加抖動的示例流程,並分清配額、花費上限與上下文視窗,最後談代理迴圈與批次工作的節流。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
過度擬合(過擬合,Overfitting)是什麼:考古題全對、新題卻答錯
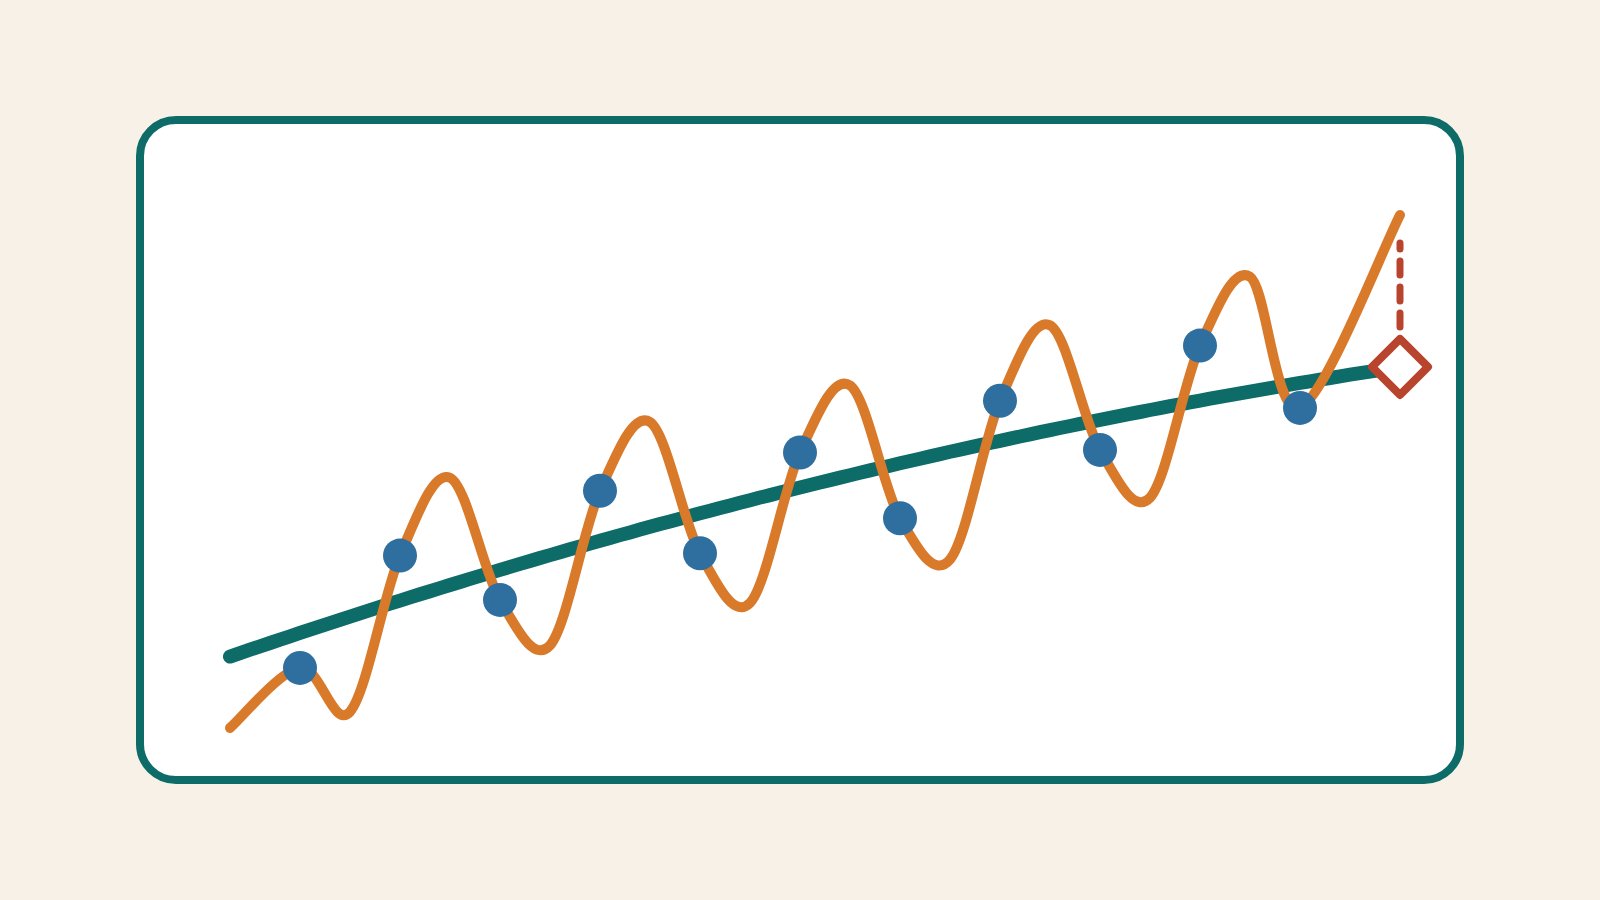
過度擬合是模型連訓練資料裡的雜訊與特例都學進去:訓練時幾乎全對,遇到沒看過的資料就失準。用示例誤差曲線說明訓練集、驗證集、測試集的分工,對照低度擬合,整理更多資料、正則化、dropout、提早停止等對策,並解讀深度網路能背下隨機標籤的研究,以及基準測試題目外洩造成的「看起來會」。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
神經網路(Neural Network)是什麼:由層與權重組成、能從資料學習的函數
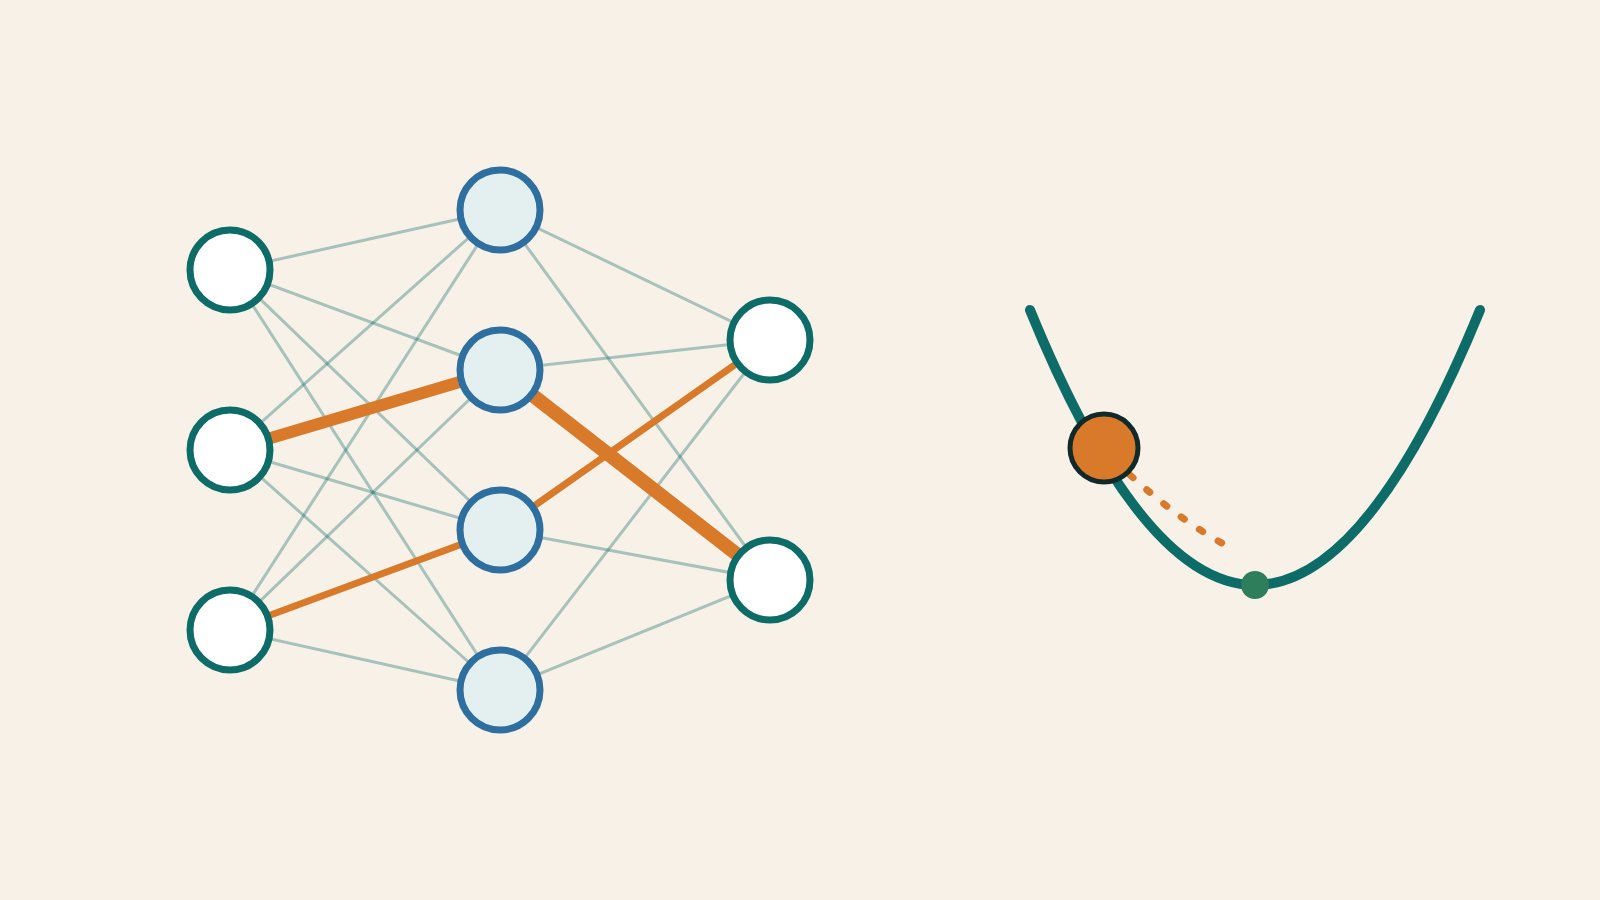
神經網路是由多層簡單單元組成的函數:單元做加權加總,多半再經非線性轉換,權重由資料調整。用雙開關走廊燈的手算示例,說明前向計算、損失、反向傳播與梯度下降,區分訓練與推論,並釐清參數數量、神經元數量與能力的差別,以及它與深度學習、Transformer 的關係。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
本機推論(Local Inference)是什麼:在自己的裝置上跑模型
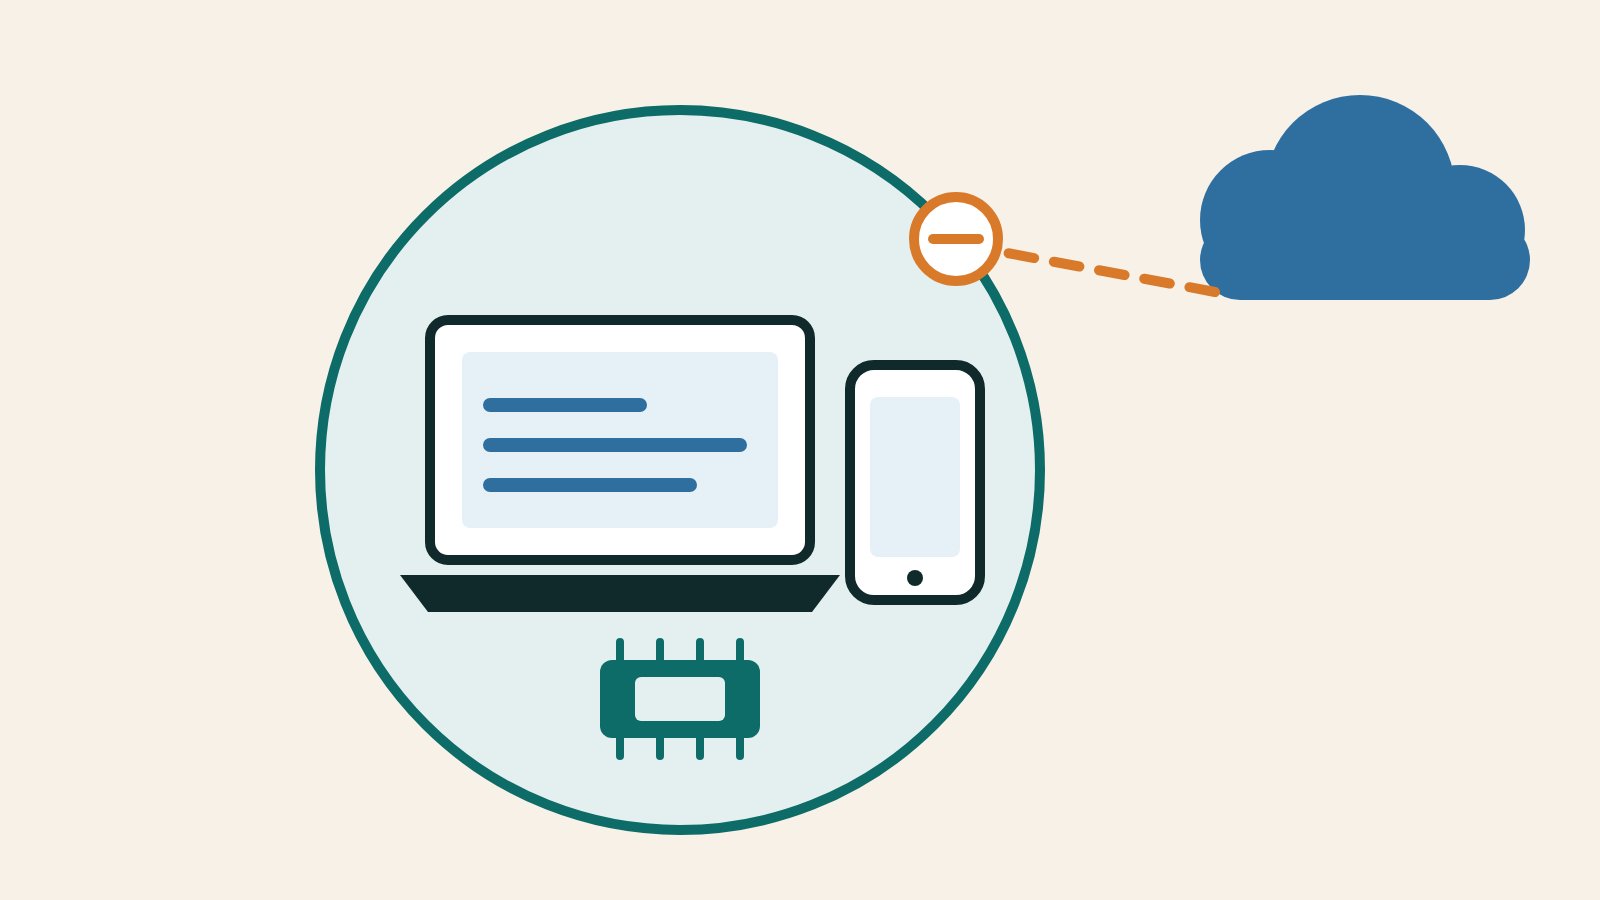
本機推論是把模型權重下載到自己的電腦或手機,由這台裝置完成計算,提示詞不必送進雲端。內容說明哪些東西真的留在本機、哪些仍可能連網,記憶體需求如何由權重、量化與 KV 快取決定,作業系統內建的裝置端模型怎麼運作,並比較本機與雲端推論在隱私、成本、速度與維護上的取捨。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
KV 快取(KV Cache)是什麼:為什麼對話越長越吃記憶體
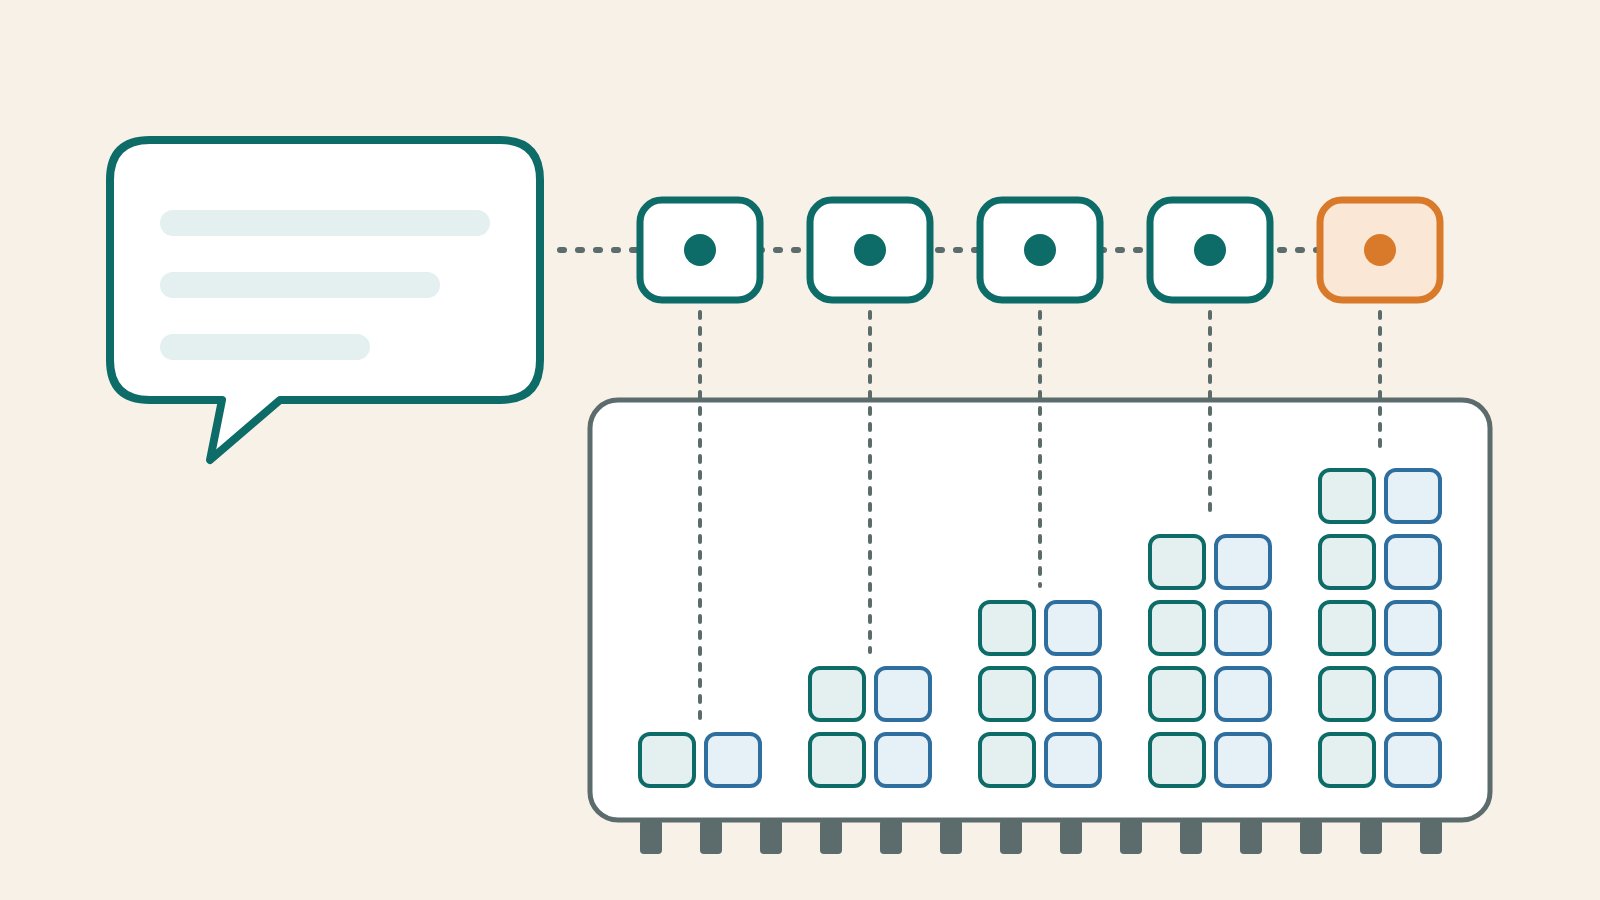
KV 快取是語言模型逐個產生 token 時,把前面每個位置在各層算好的 key 與 value 存起來、下一步只補算新 token 的做法。內容用四步示例說明它省下哪些重算,記憶體為何隨上下文長度、層數與注意力頭數成長,PagedAttention、MQA/GQA 與量化各省在哪,以及它和提示詞快取的分工。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
知識截止日(Knowledge Cutoff)是什麼:模型知道到哪一天,又為什麼不準
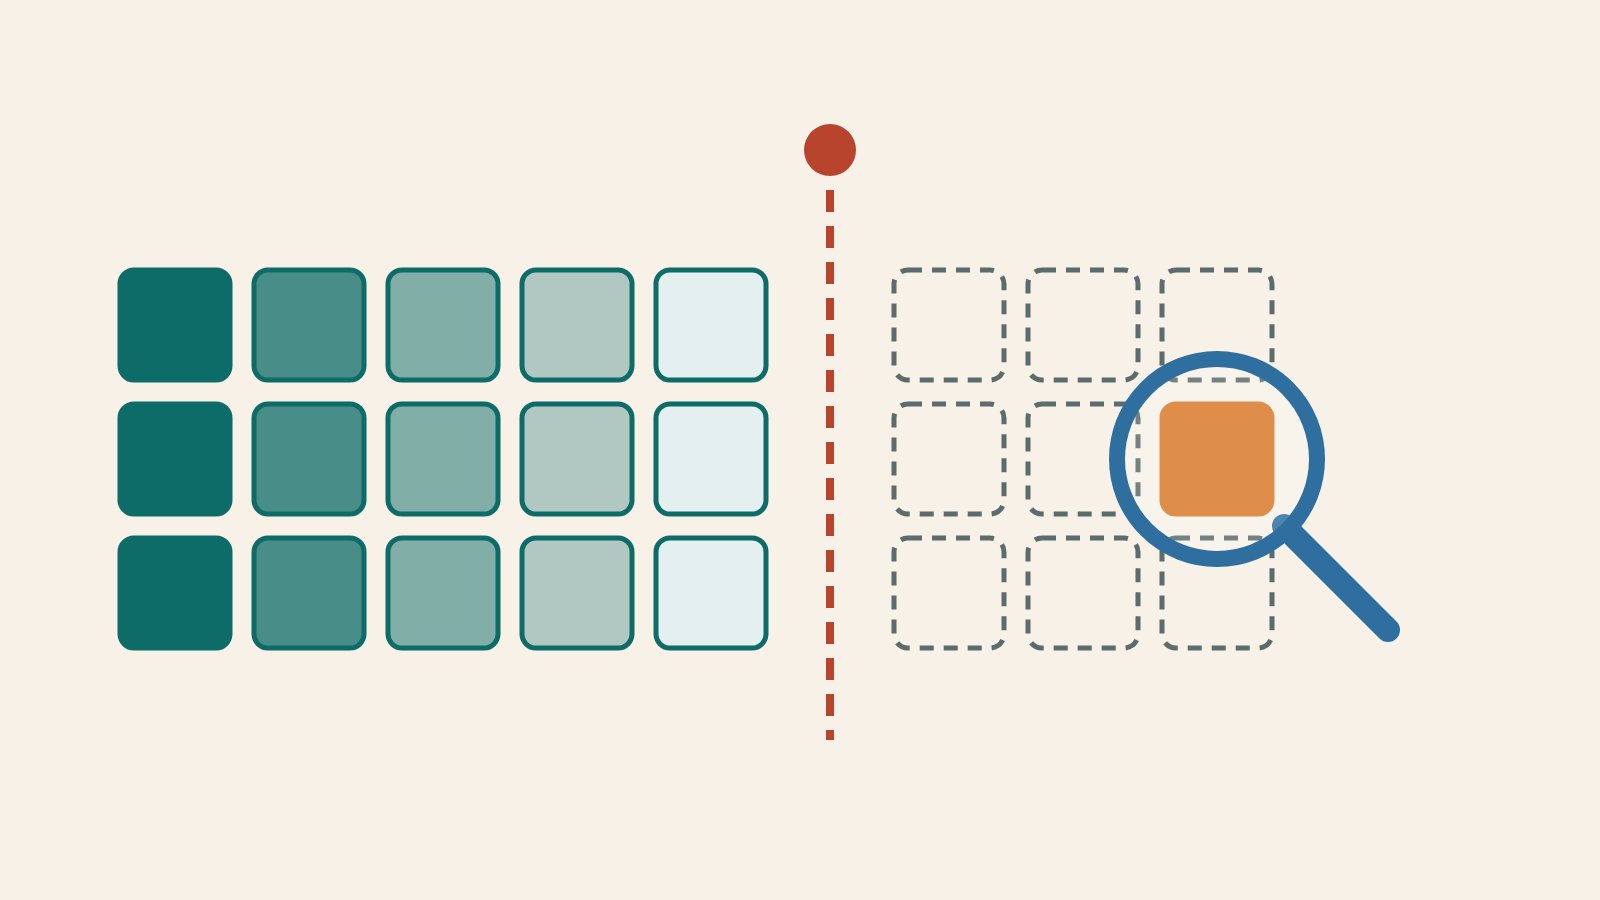
知識截止日是供應商標示模型訓練資料大致到哪個時間的說法,不是模型什麼都知道的保證。內容說明各家怎麼標示、訓練資料截止日與可靠知識截止日的差別,為什麼越近截止日的事越不牢靠,用虛構案例區分承認不知道、過期資訊與幻覺,再比較附上資料、檢索與搜尋工具的補救與失敗點。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
可解釋性(Interpretability)是什麼:看懂模型為什麼這樣回答
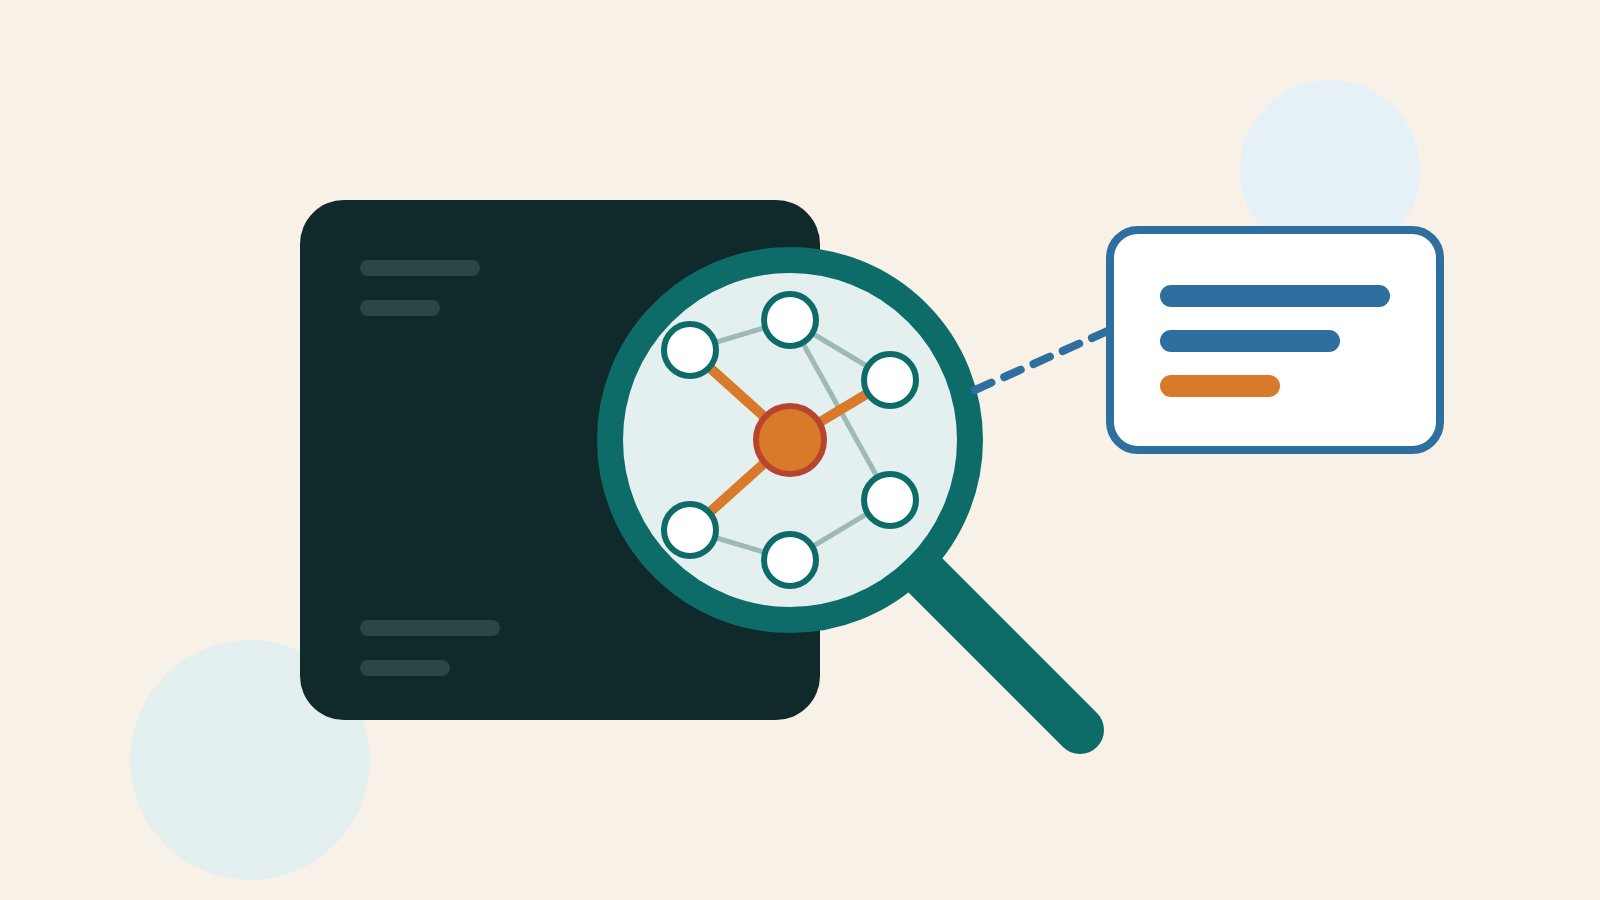
可解釋性是讓人理解模型輸出從何而來的研究與方法,連定義都有分歧。以下並列 Doshi-Velez 與 Kim、Lipton、Rudin 與 NIST 的說法,分三類說明天生可讀的模型、SHAP 等事後歸因與機制可解釋性,解釋本身為何可能不忠實,以及讀到「AI 能解釋它的決定」時該追問哪三件事。
- AI 工具
- 教學
- AI 名詞解釋
生活分享
推論(Inference)是什麼:模型訓練完之後,每次回答都在做的計算
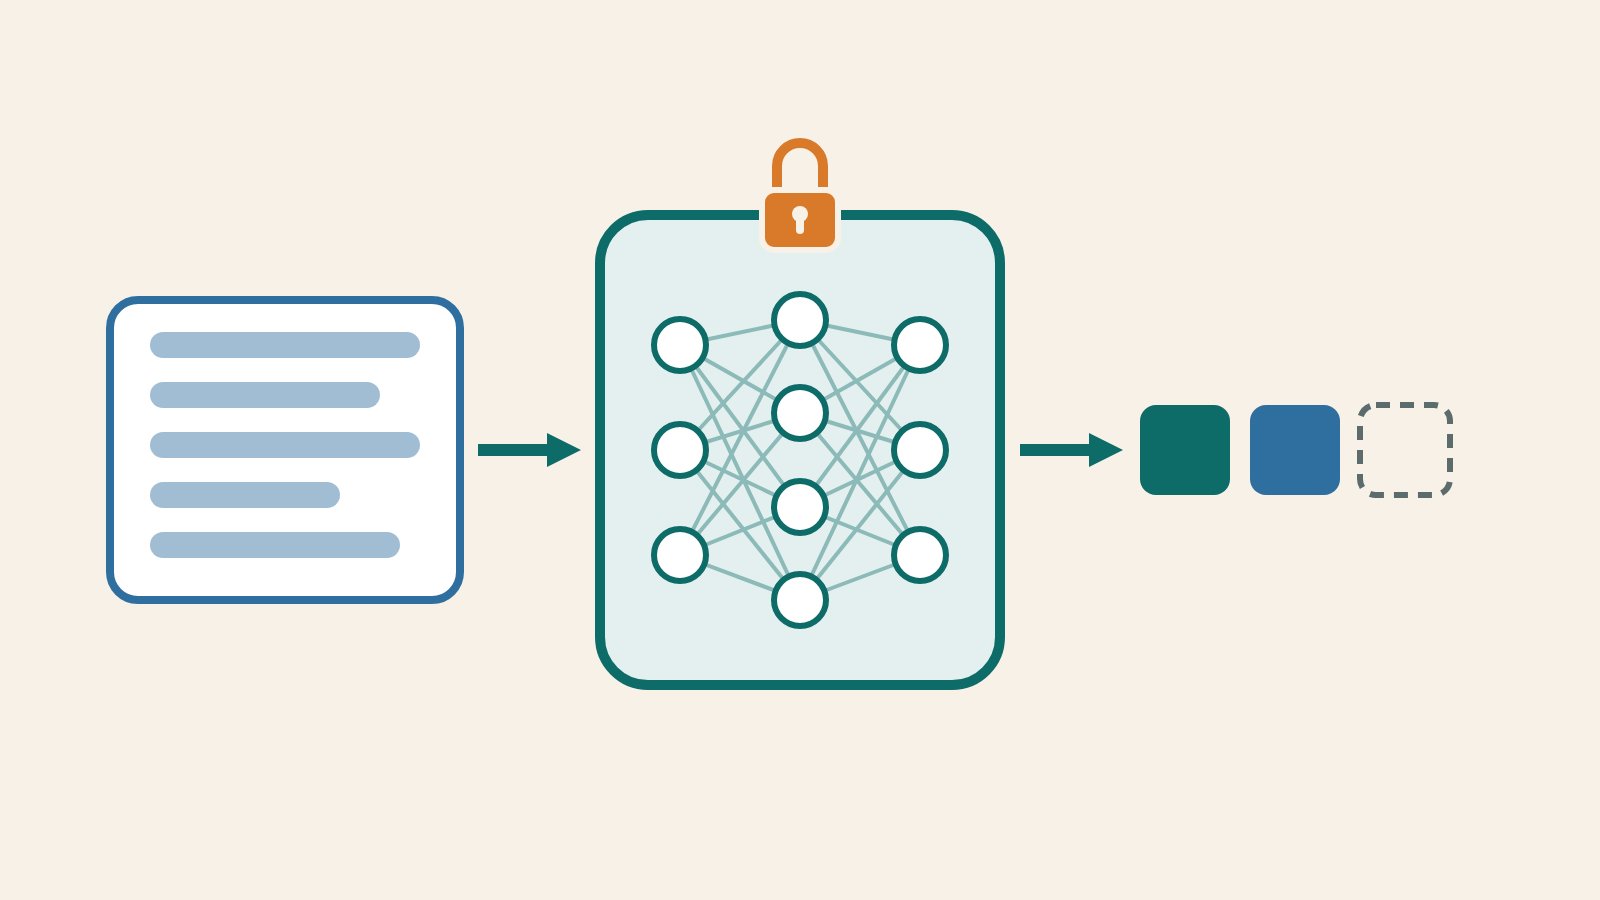
推論是用已訓練好的模型處理新輸入、產生輸出的過程,權重在這個階段固定不變。內容拆開語言模型推論的兩段:讀入提示(prefill)與逐個產生(decode),說明首個 token 時間、完整回答時間與吞吐量的差別,分清推論(inference)與推理(reasoning)、雲端與本機,並看懂批次、量化與快取各自省在哪裡。
- AI 工具
- 教學
- AI 名詞解釋