生活分享
縮放定律(Scaling Laws)是什麼:規模變大,損失與能力怎麼變
縮放定律是從訓練實驗擬合出的經驗規律:在特定設定下,語言模型的損失隨參數量、資料量與訓練計算量近似冪律下降。內容說明 Kaplan 與 Chinchilla 對預算分配的不同結論與成因、損失與任務表現的落差、湧現能力的兩種說法、推論時計算的縮放,以及如何閱讀「縮放撞牆」的新聞。
閱讀時間約 8 分鐘
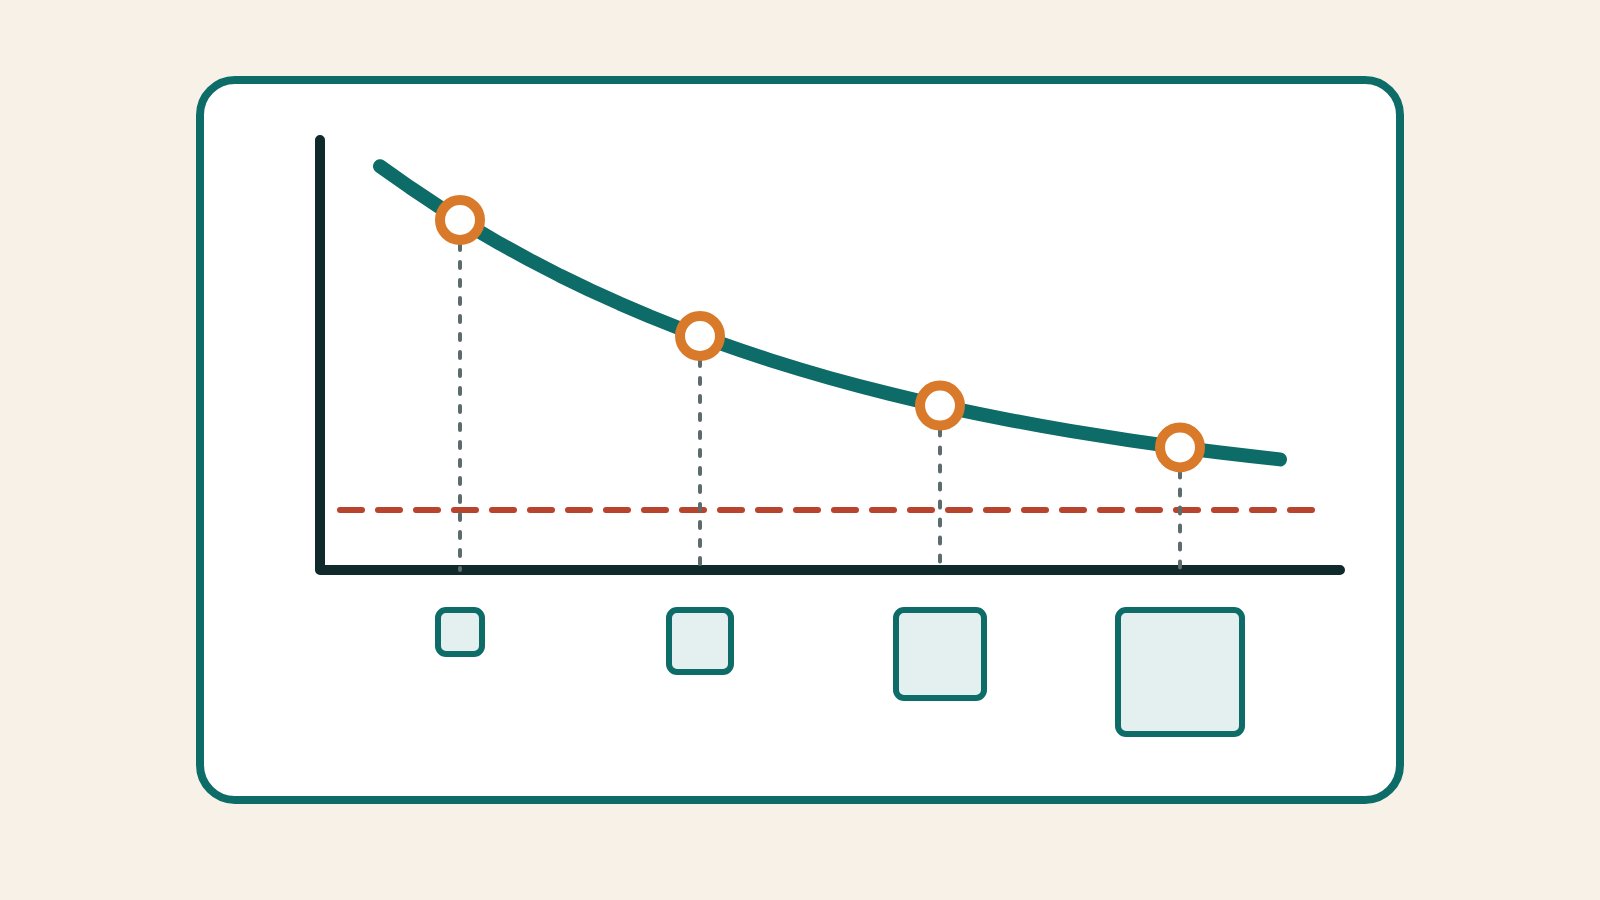
縮放定律(Scaling Laws)是研究者從訓練實驗中擬合出的經驗規律:在特定的模型、資料與訓練設定下,語言模型在沒看過的文字上的預測誤差(損失),會隨參數量、資料量與訓練計算量增加而平滑下降,形狀接近冪律。它不是物理定律,量的是損失,不等於任何一項任務的實用程度。
本文講機制與讀法,不談任何模型的規模,也不預測未來會不會撞牆。文中的數字都是論文在自己的設定下量到的結果,不能推廣成通則。
冪律的白話說法:進步要靠成倍的資源
先說損失。語言模型每預測下一個 token(文字切成的處理單位),都會替真實出現的那個 token 給一個機率;損失衡量模型對真實文字有多意外,在沒拿來訓練的文字上量,越低越好。Kaplan 等人 2020 年的論文用一系列 Transformer 模型,量到損失與模型參數模型參數(Model Parameters)是什麼模型參數是訓練時調整、用來把輸入轉成輸出的數值,例如權重與偏差。本文用簡單算式示例說明參數如何影響預測,區分模型參數、訓練超參數、提示詞與生成設定,並解釋參數量、數值精度和啟用參數為何是不同指標。讀完能更準確閱讀模型規格,理解參數增加不等於知識逐條增加,也不代表每次聊天都在重新訓練模型。閱讀全文的數量、資料量、訓練計算量,各自近似冪律。
冪律的白話意思是:資源每乘上固定倍數,損失就乘上固定比例。該論文在自己的設定下(資料足夠、訓練到收斂),參數量加倍,損失約變成原來的 0.95 倍,少了約 5%;再加倍一次,也只再少約 5%,這次要多投入的資源卻是上一次的兩倍。畫在兩軸都取對數的圖上,它是一條直線;換成一般座標,就是愈來愈平緩的曲線。
這是擬合出來的曲線,不是推導出來的定律:Kaplan 等人寫明,當時沒有紮實的理論解釋這些規律,難以判斷在哪些情況可以信任。下一節會談到的 Chinchilla 論文,公式還多一項不會再降的損失,對應自然文字本身的不確定性,所以曲線有下限。
同一筆預算,參數與資料怎麼分
假設預訓練預訓練(Pretraining):模型的基礎能力從哪裡來預訓練是在特定任務調整之前,讓模型從大量資料學得可重用表示與規律的階段。本文用下一個 token 預測和遮住內容再還原的例子說明資料、目標與參數更新,區分預訓練、微調和使用時提供上下文,也解釋為什麼學過文字不等於記得來源或保證事實正確。讀完能理解基礎模型的能力來源,以及訓練資料品質和評估汙染的影響。閱讀全文的算力預算固定,要決定模型多大、看多少 token。Kaplan 等人的結論是新增的預算多半花在放大模型;Hoffmann 等人 2022 年的論文(通稱 Chinchilla)訓練了超過 400 個模型,結論是模型大小與訓練 token 數該等比例增加。Chinchilla 論文把前者的建議換算成:預算多 10 倍時,模型放大約 5.5 倍,資料只增加約 1.8 倍。
差異從哪來?Chinchilla 論文的解釋是:Kaplan 對所有模型用同樣的訓練長度與學習率排程,且實驗模型多半較小。2024 年的兩篇後續研究重做了比較,都發現學習率排程不是主因:Pearce 與 Song 認為很大一部分差異來自 Kaplan 計參數時不算嵌入層(把 token 及其位置轉成向量的部分),加上分析在小規模進行;Porian 等人重現 Kaplan 的結果後找出三個因素,分別是沒計入最後一層(輸出層)的計算成本、暖身期對小模型太長、最佳化器設定沒隨模型規模調整,修正後與 Chinchilla 吻合。兩篇的歸因不完全相同,重疊之處是 Kaplan 計算參數與算力時,沒有算進嵌入層或最後一層。這兩部分在小模型裡占比較大,Kaplan 的實驗又以小模型為主,漏算就讓結論偏向把預算多花在放大模型。
估計本身也可能出錯:Chinchilla 論文用三種方法估計最佳配置,Besiroglu 等人用從論文圖表重建的資料重做第三種,發現原報告的數值與前兩種方法不一致,重做後則與前兩種相容。「最佳」也只指固定訓練算力下損失最低;Sardana 等人 2024 年把模型上線後的推論(inference)成本也算進去,結論是預期請求量夠大時,該訓練比 Chinchilla 建議更小、看更多 token 的模型。
損失下降,不等於任務變好:湧現能力的兩種說法
損失與任務之間隔著評量指標。Kaplan 等人自己就寫道,損失的進步是否轉成語言任務的進步,需要另外檢驗。Wei 等人 2022 年的論文把湧現能力(emergent abilities)定義為小模型沒有、大模型有,因此無法從小模型的表現外推;在他們整理的任務曲線上,表現在某個規模前接近隨機,之後明顯高於隨機。他們承認指標可能掩蓋漸進的進步,在檢查的六項任務上也看到損失早已改善,但認為這只是不完整的解釋:分類題也有湧現,而且預測不了轉折的規模。
Schaeffer 等人 2023 年提出另一種解釋:指標若是非線性或不連續的,平滑的進步也會看起來像突然躍升。他們統計一份人工標注的 BIG-Bench 湧現能力清單,超過 92% 出現在兩種指標下,一是多選題的最高機率選項是否正確,一是輸出與答案字串完全相同;在他們檢驗的案例中,換成連續指標,躍升就消失。他們強調這不表示大型模型不可能有湧現能力,只是先前主張的可能出自分析方式。
示例(假設數字,未實測):某題的答案固定是 5 位數,5 位全對才算對。若模型愈來愈大,逐位答對率依序是 50%、70%、90%、95%,整串全對的機率就是 3%、17%、59%、77%(假設各位彼此獨立,Schaeffer 等人說明這只是近似)。逐位進步平穩,整串全對率卻在中段陡升。這顯示指標會放大平滑變化,但不證明所有湧現都是假象。
推論時計算也有縮放曲線
另一條軸是回答當下多花算力,即推論時計算推論時計算(Test-time Compute):把算力花在這一道題推論時計算是模型回答當下投入的運算資源,增加它可用於更長推導、多個候選或額外驗證。本文以活動排程示範順序修正和平行探索,依原始研究說明題目難度與驗證器如何影響效果,也區分推論、訓練和單純等待。讀完能判斷哪些問題值得多算、哪些需要補資料,並知道如何把延遲、總運算與可驗證品質放在一起比較。閱讀全文:同一題取樣多次、讓模型修改答案,或用驗證器挑答案。Brown 等人對同一題重複取樣,量覆蓋率,也就是至少有一個樣本答對的題目比例,發現在橫跨約四個數量級的取樣次數內,覆蓋率都持續上升。程式題這類能自動驗證答案的題目,覆蓋率上升就直接轉成實際表現;沒有自動驗證器時,覆蓋率不等於最終答對率:在 MATH 題集、一個開放權重模型的設定下,覆蓋率從 100 次取樣的 82.9% 升到 10,000 次的 98.44%,改用多數決或獎勵模型挑答案,進步最多的做法也只從 40.50% 升到 41.41%。
Snell 等人在 MATH 題集上,用微調過的模型研究怎麼分配推論算力:依題目難度調整策略,論文估計推論算力的使用效率比一律取樣再挑最好的提高約 2 至 4 倍。與參數量約 14 倍的模型在總運算量相同下比較,結果取決於難度與推論負載:題目簡單或中等、或推論量少時,多算推論較划算;題目很難、或推論量大時,預訓練較有效。論文的結論是兩者不能一比一互換。
看到「縮放撞牆」,先問誰說的、量什麼
「縮放撞牆」可能指好幾件不同的事。曲線在一般座標上變平是冪律本來的形狀,要看實測有沒有偏離擬合線才算數;訓練資料不夠是供應問題,Villalobos 等人專門估算公開人類文字的存量與資料需求,並非在問損失曲線;基準測試基準測試(Benchmark)是什麼基準測試用共同題目、執行設定與評分方法比較系統,是理解 AI 能力的一種參考,不能直接當成所有用途的排名。本文以圖書館資料整理需求為例,說明題型、指標、提示詞、工具與測試汙染如何影響分數,解釋平均值與排名變動的限制。讀完能閱讀基準的適用範圍,判斷不同報告是否真的可比,並把公開成績接到自己的實際任務驗證。閱讀全文分數進步變慢,要先分辨是指標飽和還是能力停滯。
| 縮放什麼 | 論文量到的 | 不要誤讀成 |
|---|---|---|
| 參數、資料、訓練計算 | 沒看過文字上的損失近似冪律下降 | 每項任務都同樣進步 |
| 推論時計算 | 特定題集上多取樣或修改後的表現 | 所有題目都有效 |
| 湧現能力 | 某指標在某規模前近隨機、之後上升 | 能力必然在該規模突然出現 |
論文只能說它的設定內發生了什麼,範圍之外沒有保證。相鄰的詞可從AI 名詞總索引AI 名詞總索引:從 Loop Engineering 到生成式 AI想看懂 Loop Engineering、Harness Engineering、Context Engineering、RAG、MCP 與其他 AI 名詞,可以從這份總索引開始。依 2026 年 9 月查證範圍,把這些概念分組整理,每個詞連到白話專文,附依任務安排的閱讀路徑、容易混淆的層次,以及原始論文和官方定義的查核方式。閱讀全文查找。
同主題延伸閱讀
生活分享
世界模型(World Model)是什麼:讓 AI 預測「接下來會怎樣」
世界模型指 AI 內部用來預測「這樣做之後會怎樣」的模型,但這個詞至少有三種用法:強化學習代理在想像中練習用的環境模型、LeCun 主張預測抽象表示的架構路線,以及能隨操作即時生成畫面的互動環境。內容用示例說明怎麼在想像中規劃,並列出大型語言模型有沒有世界模型的正反研究,附讀新聞時的檢查問題。
生活分享
視覺語言模型(VLM)是什麼:讓 AI 讀圖片、再用文字回答
視覺語言模型(VLM)能同時接收圖片與文字,再用文字回答。內容拆解視覺編碼器、連接層與語言模型三段結構,說明 CLIP、Flamingo、LLaVA 三篇論文各補上哪一塊,並和多模態 AI、文字生圖分清楚;也整理它常犯的錯:數錯數量、搞混位置、說出圖裡沒有的東西,附上讀收據時逐行核對的步驟。
生活分享
溫度(Temperature)是什麼:AI 回答變化程度的取樣參數
溫度(temperature)是文字生成時調整取樣的參數,讓模型從下一個 token 的機率分布裡抽得更集中或更分散。用假想的台南早餐示例算出低溫與高溫的差別,說明 top-p 的來源和它與 top-k 的差別,並依官方文件與論文指出:調低溫度不代表更準,設成 0 也不保證每次相同,部分模型還不開放調整。
生活分享
合成資料(Synthetic Data)是什麼:兩種用途、品質控管與模型崩潰
合成資料是由演算法或模型產生、模仿真實資料特徵的資料,常見用途有兩種:訓練模型,以及在隱私需求下替代真資料。內容依 Self-Instruct、模型崩潰研究(替換與累積資料的差別)與 NIST、ICO 的隱私文件,說明做法、抽查流程,以及它不能保證的事。
引用本文的文章
最新旅遊情報攻略

情報
2026 韓國楓葉預測:雪嶽山 10 月 20 日、首爾近郊 10 月底、內藏山與漢拏山 11 月上旬
韓國山林廳 2026 年 9 月 22 日公布的楓紅高峰預測:雪嶽山 10 月 20 日,春川、國立樹木園到首爾植物園落在 10 月 28 日到 11 月 2 日,內藏山 11 月 4 日、漢拏山 11 月 6 日,整體比最近 5 年晚約 0.8 天。整理各地楓樹與銀杏的預測日、首爾出發怎麼排,以及出發前去哪裡看即時楓況。2026 年 10 月查證。
- 季節活動
- 自然
- 觀景

攻略胡志明市
胡志明市到頭頓一日遊:白藤碼頭搭高速船、船票與班次,下船就是胡梅纜車與耶穌基督像
人在胡志明市挪一天去頭頓看海:市中心的白藤高速船碼頭搭船,航程 120 分鐘到頭頓的胡梅碼頭,平日成人 320,000 越南盾、週末 350,000,回程末班平日 15:00。下船就是胡梅纜車站,同一條路上有白宮,小山頂上是耶穌基督像。平日一天只有兩班船,整天要從末班船倒推著排。
- 交通
- 行程範例
- 海灘

攻略沖繩
沖繩不開車攻略:單軌只到浦添,美麗海水族館要坐兩個多小時的巴士,回那霸的最後一班直達車 17:22 就開走
不租車的沖繩怎麼移動:那霸市區靠沖繩都市單軌電車(ゆいレール),那霸機場站到終點てだこ浦西 19 站、17 公里、37 分鐘,一日券 1,000 日圓;美麗海水族館有那霸機場直達的高速巴士,單程 2,000 日圓起、官方時刻表上 2 小時上下,下車後還要走 10 分鐘;古宇利島要在今帰仁村役場轉車,當天來回光坐車就六個半小時;回程的最後一班直達車 17:22 就從記念公園前開走(2026 年 9 月查證)。
- 交通
- 行程範例
- 預算
資料來源
- Kaplan 等人 2020:Scaling Laws for Neural Language Models(arXiv:2001.08361) · 查證日期:
- Hoffmann 等人 2022:Training Compute-Optimal Large Language Models(arXiv:2203.15556) · 查證日期:
- Pearce 與 Song 2024:Reconciling Kaplan and Chinchilla Scaling Laws(arXiv:2406.12907,TMLR) · 查證日期:
- Porian 等人 2024:Resolving Discrepancies in Compute-Optimal Scaling of Language Models(arXiv:2406.19146,NeurIPS 2024) · 查證日期:
- Besiroglu 等人 2024:Chinchilla Scaling: A replication attempt(arXiv:2404.10102) · 查證日期:
- Wei 等人 2022:Emergent Abilities of Large Language Models(arXiv:2206.07682,TMLR) · 查證日期:
- Schaeffer 等人 2023:Are Emergent Abilities of Large Language Models a Mirage?(arXiv:2304.15004) · 查證日期:
- Brown 等人 2024:Large Language Monkeys: Scaling Inference Compute with Repeated Sampling(arXiv:2407.21787) · 查證日期:
- Snell 等人 2024:Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters(arXiv:2408.03314) · 查證日期:
- Villalobos 等人:Will we run out of data? Limits of LLM scaling based on human-generated data(arXiv:2211.04325) · 查證日期:
- Sardana 等人 2024:Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws(arXiv:2401.00448,ICML 2024) · 查證日期: