AWS SageMaker HyperPod Inference 支援 NVIDIA Dynamo:多節點、分離式 prefill/decode,Qwen3-235B 基準吞吐達 2.05 倍
AWS 宣布 Amazon SageMaker HyperPod Inference 現已支援 NVIDIA Dynamo,提供多節點部署、prefill 與 decode 分離及 KV 感知路由。以下依 AWS 文章整理運作方式、基準測試與限制。
新聞日期: 閱讀時間約 6 分鐘
AWS 在官方部落格宣布,Amazon SageMaker HyperPod Inference 現已支援 NVIDIA Dynamo,用於部署超出單一執行個體 GPU 記憶體的大型語言模型。文章未提及預覽、測試版或區域限制,也未說明台灣供應情形。簡單說,prefill 是模型讀入並處理提示詞的階段,decode 是逐一生成回覆 token 的階段。KV cache 是處理提示詞時留下、之後可重用的暫存資料。KV 感知路由則會參考可重用的提示詞前綴快取與各 worker 的負載來分派請求。對需要自行營運大型模型推論的團隊而言,重點是把 prefill 與 decode 拆開、跨節點部署的工作,交給受管理的附加元件處理。
這次更新解決什麼問題?與先前有何不同
AWS 指出,GLM-5.3 的 FP8 權重超過單一 ml.p5.48xlarge 執行個體的 640 GB GPU 記憶體(尚未計入 KV cache 與執行期開銷),而且長提示詞與 token 生成共用 GPU 時會拖慢生成速度。AWS 稱 Dynamo 是開源分散式推論框架,支援多節點部署、prefill 與 decode 分離、KV 感知路由,可搭配 vLLM、SGLang 與 TensorRT-LLM。
據 AWS 說明,HyperPod 附加元件會安裝 Dynamo 的自訂資源定義,以及 HyperPod Inference Operator、Dynamo operator、Grove 與 Kubernetes AI(KAI)Scheduler。Grove 負責協調相關 pod 群組,KAI Scheduler 以 gang scheduling 讓多節點 worker 所需 pod 一起排程。Dynamo 執行期由 AWS Deep Learning Containers 提供,採用新版 Dynamo 需更新附加元件。
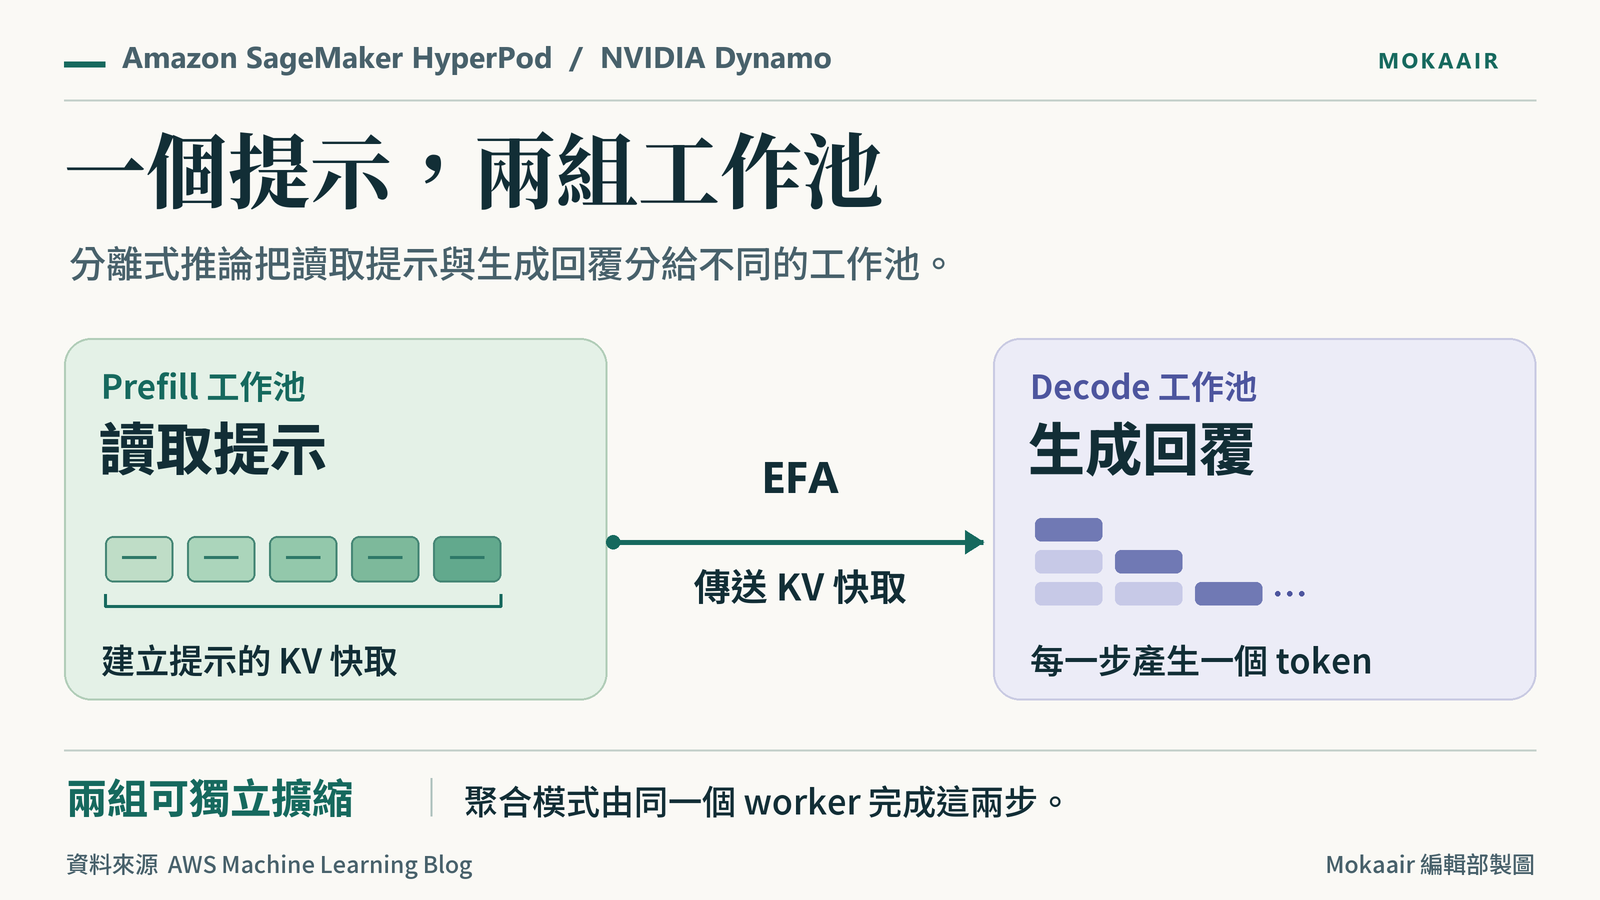
在分離式架構中,AWS 說前端將請求導向處理提示詞的 prefill worker 與生成 token 的 decode worker,兩組可獨立擴縮與調校,兩者都載入完整模型權重,KV cache 透過 EFA(Elastic Fabric Adapter,AWS 的高效能網路)傳輸。Dynamo 也支援聚合式服務,即 prefill 與 decode 在同一 worker。
支援哪些部署方式?
AWS 提供兩條路徑:自帶 DynamoGraphDeployment(DGD),適合沿用上游文件與清單的既有 Dynamo 使用者;或使用含 dynamoSpec 的 InferenceEndpointConfig,適合已熟悉 HyperPod Inference 設定格式與 OpenAI 相容介面的使用者。引擎可選 vLLM、SGLang 或 TensorRT-LLM,預設為 vLLM。兩者都支援單一執行個體與多節點。
| 項目 | 自帶 DGD | IEC 搭配 dynamoSpec |
|---|---|---|
| 你要撰寫 | 完整 DGD 清單 | 含 dynamoSpec 的 IEC |
| 適合對象 | 想直接控制服務圖或重用既有 DGD 的團隊 | 想透過 IEC 受管設定端點的團隊 |
| 模型權重 | 自行設定下載或掛載 | Operator 從 Amazon S3 或 Amazon FSx 暫存 |
| 端點、TLS、註冊 | 自行設定與管理 | 由 HyperPod Inference Operator 管理 |
| 自動擴縮 | 自行設定與管理 | 透過 autoScalingSpec 使用 KEDA(聚合與分離式皆可) |
AWS 的基準測試顯示什麼?
第一項測試以 AIPerf 比較 Qwen3-235B-A22B-FP8 在兩台 p5en.48xlarge(16 顆 H200)上,使用 Dynamo 與 TensorRT-LLM 的聚合式與分離式服務。請求含 4,000 輸入 token 與 200 輸出 token,只保留 P90 首 token 時間低於一秒、且每位使用者中位生成速度至少 50 tokens/秒的測量點。AWS 稱在這些點中,分離式達到聚合式最高吞吐的 2.05 倍:每 GPU 每秒 207 對 101 個輸出 token,並發數分別為 80 與 32。
第二項測試針對 Qwen3.5-397B-A17B-FP8,使用 Dynamo 與 vLLM、TP4 × PP2、八顆啟用的 H200。AWS 比較單一 p5en.48xlarge 上八顆 GPU,與兩台各四顆 GPU。在高前綴重用的代理型工作負載、並發 32 時,雙節點每 GPU 達 126.4 輸出 token/秒,保留單節點吞吐的 99.1%。AWS 說明該模型本可放進單一執行個體,此處僅作受控基準。
實際部署流程與最佳實務有哪些?
AWS 以 ml.p5.48xlarge 上的 GLM-5.3 與 vLLM 為例。聚合式範例用一個 model-worker 副本跨兩個執行個體(16 顆 GPU)、兩個前端副本,並把 frontend.routingMode 設為 kv-aware 以啟用 KV 感知路由。分離式範例為一個 prefill 副本與兩個 decode 副本,每個跨兩個執行個體,共六個執行個體。完整清單以 kubectl apply 套用,端點就緒後可經 SageMaker Runtime API 送出 OpenAI 相容請求;具體清單與設定步驟請見 AWS 文章及其連結的儲存庫。
- 先選擇符合模型、推論引擎與 GPU 類型的 Dynamo recipe,並把權重、KV cache 與執行期記憶體納入 worker 規模估算。
- 跨執行個體部署時,先確認通訊使用預期的 EFA 傳輸,包括 prefill 與 decode 間的 KV cache 傳輸。
- 用 AIPerf 重放自己的流量,掃描並發數,保留達成 SLA 的點,再依成本與延遲取捨。
- 依實測瓶頸調整,先動拓撲與 worker 配置,再調引擎設定,一次只改一個變數。
常見問題
什麼情況適合用分離式 prefill/decode?
AWS 指出長提示詞與 token 生成共用 GPU 會拖慢生成速度,分離式讓兩組 worker 獨立擴縮與調校。是否划算要以自身流量實測,AWS 的 2.05 倍僅是特定條件下的結果。
已有 Dynamo 清單的團隊可以沿用嗎?
據 AWS,可用自帶 DGD 路徑沿用上游文件、recipe 與清單,需使用支援的容器映像,並為叢集設定儲存、網路與 pod 放置。
節點故障時會怎樣?
AWS 表示 HyperPod 監控節點、GPU 與 EFA 健康並負責替換節點,編排元件會重建受影響的 worker。
如何升級 Dynamo 版本?
AWS 稱附加元件管理整合元件版本,採用受支援的 Dynamo 版本時更新附加元件即可。
同主題延伸閱讀
Shortical 推出 AI 微短劇《Inevitable》並開放「臉部授權」:首次使用真人肖像,方案尚無簽約
據 TechCrunch,微短劇新創 Shortical 與演員 Aki Avni 簽約,以其 AI 化身製作全 AI 微短劇;對外的臉部授權方案仍在早期,尚無已簽署合約,報酬未公開。
Chess.com 推出 Classic Games 平台公開測試:新增 10 款經典遊戲,支援網頁、iOS 與 Android
Claude Code 2.1.330:企業管理主控台登入、easel 圖表模組、排程任務延長至 30 天
AWS Quick 更新:對話建立流程、多代理協作、新增 Meta ads 與 Amplitude 連接器,AWS 稱所有 Quick 區域即日可用
資料來源
本文依據上方所列參考來源與標示之核對日期整理;票價、時刻、功能規格或服務條款可能變動,出發、預訂或購買前請至相關官方網站確認最新資訊。