生活分享
本機去識別化、雲端收尾:用 Ollama 打造混合式 AI 工作流
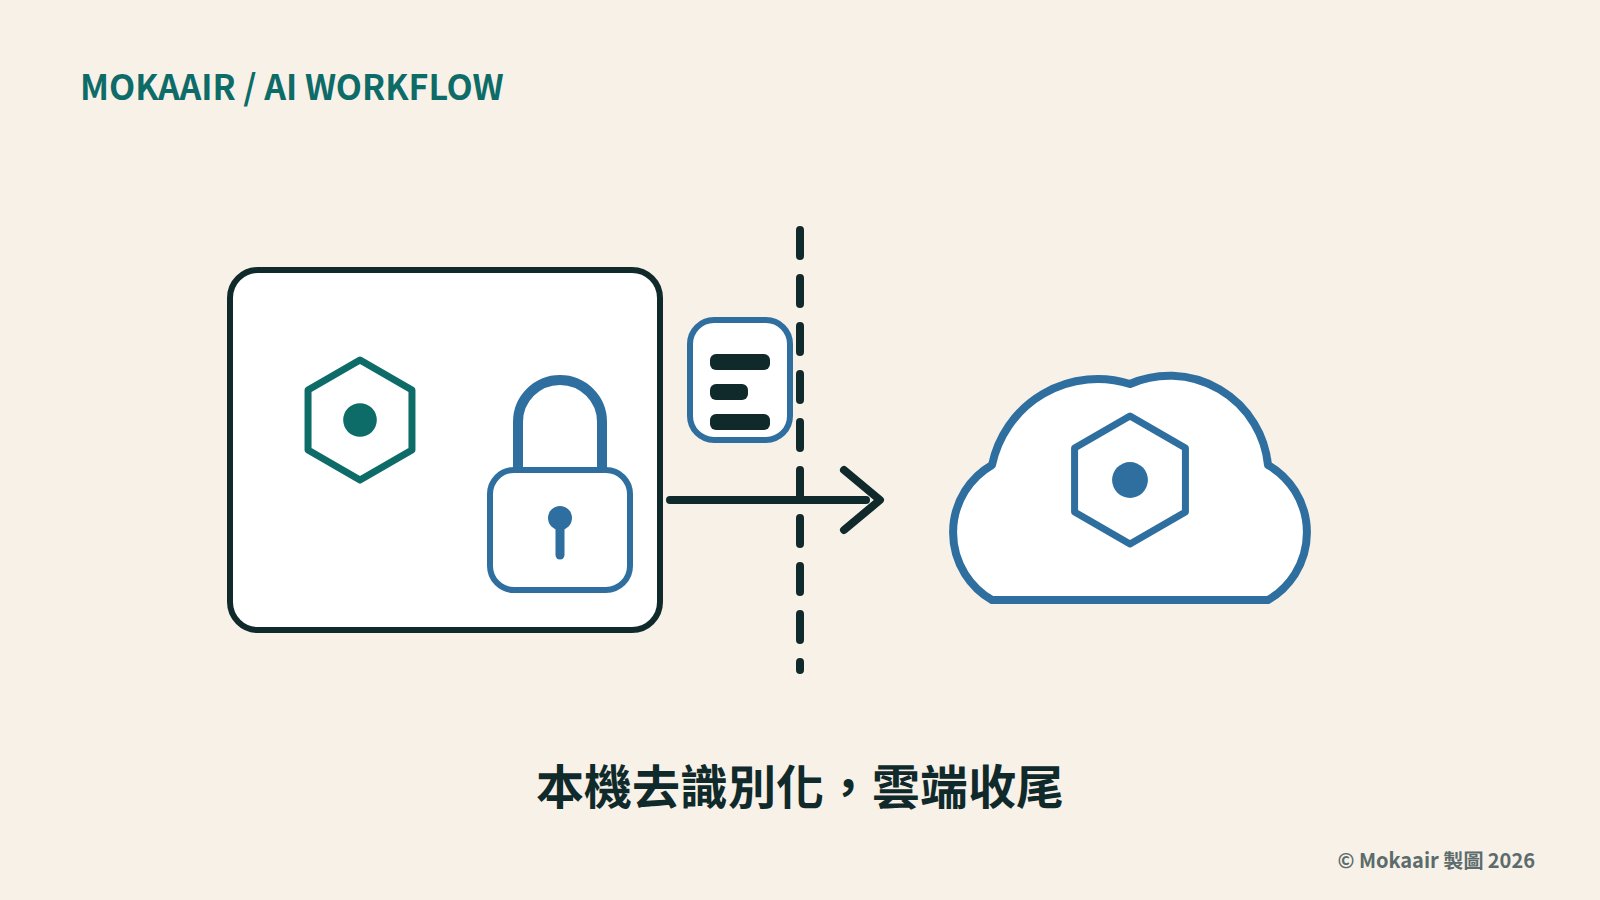
這篇教你用 Ollama 的 OpenAI 相容端點,把分類與去識別化這類會碰到原始個資的步驟留在本機執行,換成代號的乾淨文字才送進雲端模型收尾,同一支 Python 程式靠 base_url 切換兩端。本機範例只用 Ollama 模型庫查得到的 gemma4、qwen3.6 與 gpt-oss,標籤大小、上下文視窗與硬體提示照官方頁當天的數字寫,本機和雲端實際跑起來差多少本站沒有實測;哪些資料留在機器裡、哪些會送出去,也逐條對照官方文件寫清楚。
閱讀時間約 10 分鐘
本篇目錄
這篇回答一個問題:多模型工作流裡,哪一段該放在本機、哪一段可以交給雲端——結論是用 Ollama 的 OpenAI 相容端點跑本機模型,處理分類、去識別化這類會碰到原始個資的步驟,等文字乾淨了才送進雲端模型收尾。程式上本機與雲端差的只有 base_url、api_key 和 model,但要讓資料真的留在機器裡,模型標籤也得一起挑對。
讀完你會有一支能在本機與雲端間切換的 Python 程式,還有一套先在本機去識別化、再讓雲端模型寫出最終答案的流程,範例照 Ollama 官方文件與模型庫頁當天的原文寫成。動手需要 Python 3.11 以上、跑著的本機 Ollama、執行過 pip install openai,雲端那端的金鑰放進環境變數,不寫進程式裡;本機模型只用 Ollama 模型庫查得到的 gemma4、qwen3.6 與 gpt-oss。
為什麼要把敏感步驟留在本機、交給雲端收尾
多模型工作流通常要決定每一步交給哪個模型,其中一種切法是照資料敏不敏感分——原始文字裡有沒有姓名、電話、病歷這類碰不得的內容,是分類這一步就能判斷出來的事,系列裡《一件事拆給多個模型:依步驟、能力、風險、資料敏感度四種切法》把這種切法和另外三種放在一起講,這篇只把「照資料敏感度分」這一種做完整:分類與去識別化這兩步留在本機的 Ollama,判斷過、遮蔽過的文字才進入下一步,下一步才輪到雲端模型。
這個界線在 Ollama 的文件裡也找得到對應的說法。官方常見問答被問「會不會把提示詞和回覆送回 ollama.com」,回答第一句是「Ollama 是在本機執行的,你在本機執行時我們看不到你的提示詞或資料」;同一份文件另一題寫,Ollama 預設綁定 127.0.0.1 的 11434 埠,要讓網路上的其他裝置連得到,得自己改 OLLAMA_HOST 這個環境變數。不過「呼叫本機端點」不等於「資料留在本機」:OpenAI 相容性那頁寫,透過已登入的本機伺服器也可以選用雲端模型,例如 gemma4:cloud,API 介紹頁同樣寫要透過本機伺服器使用雲端模型就登入 Ollama。所以這篇的界線要兩件事同時成立——網址指到本機,而且模型標籤是已經下載到這台機器的本機標籤。
同一支 Python:base_url 和標籤決定資料去哪裡
Ollama 的 API 文件把本機和雲端的網址並排寫在同一張 Base URLs 表裡,OpenAI 相容那一列:本機是 http://localhost:11434/v1,Ollama 自己的雲端是 https://ollama.com/v1;官方原文寫「雲端請求需要 API 金鑰,本機請求不用」。用 openai 這個 Python 套件接兩邊時,程式碼幾乎一樣,差的只有兩處:OpenAI() 建構子裡的 base_url 與 api_key,以及呼叫時填的 model 名稱;如果要接的不是 Ollama 自己的雲端,而是 OpenRouter、LiteLLM 這類統一多家供應商的閘道,系列裡《統一 API 層:OpenRouter 與 LiteLLM 換模型不改程式》另外講那一種寫法。
import os

from openai import OpenAI

# Ollama 的 OpenAI 相容端點:本機是 http://localhost:11434/v1,
# Ollama 自己的雲端是 https://ollama.com/v1(官方文件的 Base URLs 表)。
LOCAL_BASE_URL = "http://localhost:11434/v1"
CLOUD_BASE_URL = "https://ollama.com/v1"

# 只有下載到這台機器的標籤才算本機;帶 cloud 字樣的標籤會送到 Ollama 的雲端,
# 即使 base_url 指的是本機伺服器也一樣。
LOCAL_MODELS = {"gpt-oss:20b", "qwen3.6:35b", "gemma4:12b"}


def ensure_local_tag(model: str) -> None:
  """本機那一步的守門員:標籤不在白名單就不要送出去。"""
  if model not in LOCAL_MODELS:
    raise ValueError(f"{model} is not a downloaded local tag")


def get_client(target: str) -> OpenAI:
  """target 是 'local' 或 'cloud',換的只有 base_url 和金鑰。"""
  if target == "local":
    # 本機不檢查金鑰,用戶端仍要求填一個值,官方範例填 'ollama'。
    return OpenAI(base_url=LOCAL_BASE_URL, api_key="ollama", timeout=30.0)
  if target == "cloud":
    # 雲端要求真正的金鑰,一律從環境變數讀,不寫進程式。
    return OpenAI(
      base_url=CLOUD_BASE_URL,
      api_key=os.environ["OLLAMA_API_KEY"],
      timeout=30.0,
    )
  raise ValueError(f"unknown target: {target}")


def ask(target: str, model: str, prompt: str) -> str:
  if target == "local":
    ensure_local_tag(model)
  client = get_client(target)
  response = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": prompt}],
  )
  return response.choices[0].message.content


if __name__ == "__main__":
  # 本機模型只留在自己的機器上執行。
  print(ask("local", "gpt-oss:20b", "用一句話說明什麼是去識別化"))
本機那組範例官方文件寫得直白:「這些範例接的是你本機的 Ollama 伺服器,用戶端仍要求填一個金鑰值,但 Ollama 會忽略它」,所以程式裡的 api_key="ollama" 不是要保密的密碼,是用戶端建構子硬性要求的欄位;真正的金鑰只有指到 https://ollama.com/v1 的雲端那支才需要,官方文件自己的範例把金鑰放進環境變數讀出來。逾時也照官方套件的讀我檔寫:建構子的 timeout 設全域預設,單次呼叫要另外算就用 with_options(timeout=…) 覆寫。模型名稱則有一個容易搞混的地方:雲端頁寫,直接對 ollama.com 送 API 請求時用清單回傳的名稱,例如 gemma4:31b,在 Ollama 的 App 或 CLI 裡則用 gemma4:cloud;OpenAI 相容性那頁還寫了第三種情況,透過已登入的本機伺服器也可以選用 gemma4:cloud 這種雲端模型。cloud 是接在冒號後面的標籤,模型庫頁上另外看得到 gemma4:31b-cloud 這種把尺寸和 cloud 併在一起的寫法。
本機扛得動什麼:gemma4、qwen3.6 與 gpt-oss 的標籤與大小
這篇的本機模型只挑 Ollama 模型庫裡查證過的三個名字:gemma4、qwen3.6 與 gpt-oss,各自的標籤、下載大小與上下文視窗都照模型庫頁當天寫的數字,標籤寫法也照頁面上的樣子,一律小寫加冒號。三頁上方都排著 CLI、cURL、Python、JavaScript 四個分頁,cURL 那個分頁印出來的位址就是本機的 11434 埠;但要判斷一段文字跑在哪裡,看的不是呼叫方式,而是網址加標籤:這張表最後一欄只管標籤這一半,雲端頁寫對 ollama.com 送請求用的正是 gemma4:31b 這種不帶 cloud 的名稱。
| 模型標籤 | 下載大小 | 上下文視窗 | 型態 | 跑在哪裡 |
|---|---|---|---|---|
| gemma4:e2b | 7.2GB | 128K | 文字、圖片 | 本機 |
| gemma4:e4b(latest) | 9.6GB | 128K | 文字、圖片 | 本機 |
| gemma4:12b | 7.6GB | 256K | 文字、圖片 | 本機 |
| gemma4:26b | 19GB | 256K | 文字、圖片 | 本機 |
| gemma4:31b | 20GB | 256K | 文字、圖片 | 下載後在本機;雲端頁寫對 ollama.com 送 API 請求也用這個名稱,那一種就跑在雲端 |
| gemma4:cloud、gemma4:31b-cloud | 大小欄寫「-」 | 256K | 文字、圖片 | Ollama 的雲端;讀我檔的「Ollama's cloud」一節寫 ollama run gemma4:31b-cloud |
| qwen3.6:27b | 18GB | 256K | 文字、圖片 | 本機 |
| qwen3.6:35b(latest) | 23GB | 256K | 文字、圖片 | 本機;查證當天這一頁沒有列出帶 cloud 的標籤 |
| gpt-oss:20b(latest) | 14GB | 128K | 文字 | 本機;讀我檔寫量化後最低 16GB 記憶體可跑 |
| gpt-oss:120b | 65GB | 128K | 文字 | 本機;讀我檔寫可塞進單張 80GB 顯示卡 |
| gpt-oss:20b-cloud、gpt-oss:120b-cloud | 大小欄寫「-」 | 128K | 文字 | Ollama 的雲端;官方寫雲端模型不用下載 |
其中 gpt-oss 的讀我檔把硬體門檻寫得最具體:MoE混合專家模型(Mixture of Experts)是什麼混合專家模型透過路由器,讓輸入在某些層只使用部分專家網路,以不同方式安排模型容量與運算。本文以檔案分類的小型路由示意,說明總參數、啟用參數、專家與路由的角色,解釋它為何不是多個聊天代理開會,也不能只用啟用參數推算記憶體或品質。讀完能更準確閱讀 MoE 模型規格,理解速度、部署、訓練穩定性與負載分配的取捨。閱讀全文 權重量化成 MXFP4 格式之後,讀我原文寫這讓較小的模型可以在「最低只有 16GB 記憶體」的機器上跑、較大的模型塞得進單張 80GB 顯示卡,並形容 20B 是「設計給更低延遲、本機或特定用途使用的」。至於哪些名字有雲端版本:gemma4 的讀我檔有一節就叫「Ollama's cloud」,底下寫著 ollama run gemma4:31b-cloud,gpt-oss 的標籤清單也列著 20b-cloud 與 120b-cloud,大小欄同樣是「-」;qwen3.6 那一頁在本文查證當天沒有列出任何帶 cloud 字樣的標籤——這是當天那一頁的狀態,不是官方宣告過它不會有雲端版本。
流程:本機先去識別化,雲端模型才收尾
這裡示範一個典型的敏感步驟——去識別化:原始文字裡的姓名、電話、地址先在本機被換成像 [PERSON_1] 這樣的代號,換過的對照表留在本機的記憶體或檔案裡,只有代號版本的文字連同問題送進雲端模型;雲端寫出回覆之後,代號再由本機換回真正的姓名或電話,這一步也在本機做。要提醒的是,遮蔽這一步是交給模型判斷的,抓不抓得乾淨沒有人替你保證,正式用之前要自己拿真實樣本驗過。
import json

REDACT_PROMPT = (
  "找出下面文字中的姓名、電話、身分證號與地址,"
  "把每一個換成像 [PERSON_1]、[PHONE_1] 這樣的代號,"
  "同一個人或號碼要用同一個代號,只回傳 JSON,"
  "格式是 {\"masked\": \"...\", \"map\": {\"[PERSON_1]\": \"原文\"}}。"
)


def redact_locally(text: str, model: str = "qwen3.6:35b") -> tuple[str, dict[str, str]]:
  """原始文字留在本機,只有這支函式呼叫本機模型。"""
  ensure_local_tag(model)
  client = get_client("local")
  # 單次呼叫要另外算逾時,官方套件的寫法是 with_options。
  response = client.with_options(timeout=60.0).chat.completions.create(
    model=model,
    messages=[
      {"role": "system", "content": REDACT_PROMPT},
      {"role": "user", "content": text},
    ],
    response_format={"type": "json_object"},
  )
  payload = json.loads(response.choices[0].message.content)
  return payload["masked"], payload["map"]
這支函式接續前面 hybrid_client.py 定義的 get_client("local") 與 ensure_local_tag,只是把提示詞換成要求模型找出個資並回傳固定格式的 JSON;Ollama 的 OpenAI 相容端點支援 response_format 這個欄位,才能穩定拿回 JSON 而不是一段夾雜說明文字的回答。這種把本機那一步的輸出用固定格式交給下一步的做法,系列裡《模型之間交接資料:JSON Schema 與結構化輸出》講得更完整。
def finish_in_cloud(masked_text: str, question: str, model: str = "gemma4:31b") -> str:
  """雲端只看得到代號版本的文字,原文與代號的對照表留在本機。

  官方文件直接雲端存取的範例用的就是 gemma4:31b 這個名稱。
  """
  client = get_client("cloud")
  prompt = (
    f"以下是去識別化後的內容,代號不用還原,直接根據內容回答問題。\n\n"
    f"{masked_text}\n\n問題:{question}"
  )
  response = client.with_options(timeout=60.0).chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": prompt}],
  )
  return response.choices[0].message.content


def restore(answer: str, mapping: dict[str, str]) -> str:
  """還原代號只在本機做這一步,雲端的回覆從頭到尾沒看過真正的姓名或電話。"""
  for placeholder, original in mapping.items():
    answer = answer.replace(placeholder, original)
  return answer


if __name__ == "__main__":
  raw = "王小明,電話 0912-345-678,想詢問退款進度。"
  masked, mapping = redact_locally(raw)
  reply = finish_in_cloud(masked, "幫這位客人寫一封回覆,說明退款需要 5 個工作天。")
  print(restore(reply, mapping))
finish_in_cloud 呼叫的是 get_client("cloud"),也就是走 https://ollama.com/v1 這條路,模型名稱用官方直接雲端存取範例寫的 gemma4:31b;restore 那個函式才是還原代號的地方。整段程式從讀取原始文字到印出最終答案,只有 finish_in_cloud 那一次網路呼叫的內容離開本機;ask 和 redact_locally 走本機那一步之前都先跑 ensure_local_tag,擋掉「網址指到本機、標籤卻挑到雲端」這種把原文送出去的寫法。
延遲與硬體的現實:官方數字之外,先不要相信排名
本機模型跑不跑得動,Ollama 的模型庫頁只給得出下載大小、上下文視窗與 gpt-oss 讀我檔那種記憶體門檻這類規格數字,本文引用的官方頁沒有公開本機和雲端實際回覆要等多久;本站也沒有拿同一段文字在本機顯示卡和雲端之間各跑一次計時,所以本站沒有實測,這篇不排名誰比較快、誰比較準。而讀我檔替 120B 開出的那張 80GB 顯示卡,本身就說明了為什麼收尾那一步常常不放在自己的機器上。
雲端模型還有本機模型沒有的一種現實:雲端頁的「退場」一節寫,帳號的用量設定頁會列出最近用過、即將退場的模型,要在退場日期前換掉;同一段話也寫「已下載的本機模型不受影響」,這是選擇本機的另一個理由,不只是隱私。本機安裝的完整步驟,以及本機和雲端哪個比較省錢的試算,「Ollama 入門:Windows、Mac 安裝與第一個模型」和「本機 vs 雲端 AI 成本試算:訂閱、API 與電費怎麼算」兩篇已經寫過;如果本機模型要處理的是自己的文件而不是這篇的去識別化,「本機 RAG檢索增強生成(RAG)是什麼:讓回答附上可查的依據檢索增強生成會先從外部資料找出相關內容,再交給語言模型組織回答。本文以活動報名規章的問答為例,拆解建索引、檢索、生成與來源核對,說明它和搜尋、微調的差別,也解釋為什麼有引用仍可能答錯。讀完能判斷問題出在資料未更新、文件沒找齊,還是模型把證據解讀過頭,並知道什麼情況應保留不知道的答案。閱讀全文:跟自己的文件聊天」示範了完整的檢索流程,這篇不重複那三篇的內容。
常見問題
本機模型和雲端模型真的可以用同一支程式嗎?
可以。差別只有兩處:OpenAI() 建構子裡的 base_url 從本機的 11434 埠換成 Ollama 雲端的網址、api_key 從官方範例的 'ollama' 換成環境變數裡的真正金鑰,以及呼叫時填的 model 換成雲端那邊跑得動的名稱,其餘寫法完全一樣。
去識別化之後,雲端還會看到原始的姓名或電話嗎?
這套流程送出去的只有代號版本的文字和問題,姓名、電話這類原文和代號的對照表留在本機的記憶體或檔案裡,雲端回覆之後才在本機把代號換回原文,這一步同樣不經過網路。前提是本機那一步真的跑在本機:網址指到 11434 埠,模型也用已下載的本機標籤。另外遮蔽是由模型判斷的,抓不抓得乾淨要自己拿真實樣本驗過。
本機一定要用 gemma4、qwen3.6 或 gpt-oss 嗎?
這篇的範例只用這三個名字,因為標籤、大小和上下文視窗都是查證當天在 Ollama 模型庫讀到的數字;模型庫裡還有更多名字,換成別的模型前,同樣要自己到模型庫頁確認標籤怎麼寫、大小是多少。
Ollama 自己的雲端也算本機嗎?
不算。base_url 指到 Ollama 雲端的網址就是離開這台機器;而且官方文件寫,透過已登入的本機伺服器也可以選用 gemma4:cloud 這種雲端模型,所以只把網址指到本機還不夠,模型標籤也要挑已經下載下來的本機標籤。
為什麼不直接比較本機和雲端的速度?
因為本文引用的官方頁沒有公開這個數字,本站也沒有拿同一段文字在本機和雲端各跑一次計時比較,所以本站沒有實測,這篇只引用模型庫頁上的下載大小、上下文視窗和記憶體門檻這類規格數字。
怎麼確認本機那一步真的沒有把資料送出去?
看兩件事:base_url 是不是指到本機的 11434 埠,以及模型標籤是不是已經下載到這台機器的本機標籤。模型庫頁把雲端標籤的大小欄寫成「-」、名字帶 cloud 字樣,這種標籤是送到 Ollama 自己的雲端執行,就算網址指到本機也一樣。
雲端模型會不會忽然被下架?
雲端模型有退場機制,帳號的用量設定頁會列出最近用過、即將退場的模型,需要在退場日期前換掉;已經下載到本機的模型不在這個機制裡,不受退場影響。
多模型 AI 工作流教學:從拆任務到串接不同模型多模型 AI 工作流教學:從拆任務到串接不同模型這個系列教的是怎麼把一件工作拆開、交給合適的模型,再把結果接回同一條流程:判斷該不該拆、拆給誰,換供應商不改程式,設計便宜先試的路由與級聯,讓模型之間用結構化輸出交接資料,再到代理式工具怎麼分工、同一套工具怎麼給多個客戶端共用、Claude Code 與 Codex 怎麼搭本機模型,以及上線後怎麼追蹤與防護。一般使用者可以從判斷該不該拆的觀念讀起,已經會寫 Python 的人能直接進到換供應商、寫路由與交接資料的幾篇。閱讀全文
Ollama 入門:Windows、Mac 安裝與第一個模型Ollama 入門:Windows、Mac 安裝與第一個模型Ollama 是在自己電腦跑本機 AI 的入門工具,官網下載頁寫 macOS 要 14 Sonoma 或更新版本、Windows 要 10 或更新版本。這篇照官方文件走完安裝、第一次對話、看懂模型庫的標籤與大小、用 ollama ps 確認模型跑在顯示卡還是 CPU,再從 curl 與 Python 呼叫本機 11434 埠的 API,最後說清楚結尾帶 cloud 的標籤是雲端模型、怎麼關掉。閱讀全文
同主題延伸閱讀
生活分享
Claude Code、Codex 搭本機模型:兩種接法怎麼選
Claude Code 與 Codex 搭配本機模型有兩種接法:代理照常連雲端、把大量雜務交給腳本或 MCP 工具去問本機模型,或是把代理的模型整個換成本機模型。這篇用資料能不能出門、上下文開得夠不夠長、工作的類型三個問題幫你選,並對照 Ollama、LM Studio、Anthropic 與 OpenAI 的官方文件,分清楚本機權重、Ollama 的 cloud 標籤與供應商端點是三種不同的東西。
引用本文的文章
最新旅遊情報攻略

情報
2026 韓國楓葉預測:雪嶽山 10 月 20 日、首爾近郊 10 月底、內藏山與漢拏山 11 月上旬
韓國山林廳 2026 年 9 月 22 日公布的楓紅高峰預測:雪嶽山 10 月 20 日,春川、國立樹木園到首爾植物園落在 10 月 28 日到 11 月 2 日,內藏山 11 月 4 日、漢拏山 11 月 6 日,整體比最近 5 年晚約 0.8 天。整理各地楓樹與銀杏的預測日、首爾出發怎麼排,以及出發前去哪裡看即時楓況。2026 年 10 月查證。
- 季節活動
- 自然
- 觀景

攻略胡志明市
胡志明市到頭頓一日遊:白藤碼頭搭高速船、船票與班次,下船就是胡梅纜車與耶穌基督像
人在胡志明市挪一天去頭頓看海:市中心的白藤高速船碼頭搭船,航程 120 分鐘到頭頓的胡梅碼頭,平日成人 320,000 越南盾、週末 350,000,回程末班平日 15:00。下船就是胡梅纜車站,同一條路上有白宮,小山頂上是耶穌基督像。平日一天只有兩班船,整天要從末班船倒推著排。
- 交通
- 行程範例
- 海灘

攻略沖繩
沖繩不開車攻略:單軌只到浦添,美麗海水族館要坐兩個多小時的巴士,回那霸的最後一班直達車 17:22 就開走
不租車的沖繩怎麼移動:那霸市區靠沖繩都市單軌電車(ゆいレール),那霸機場站到終點てだこ浦西 19 站、17 公里、37 分鐘,一日券 1,000 日圓;美麗海水族館有那霸機場直達的高速巴士,單程 2,000 日圓起、官方時刻表上 2 小時上下,下車後還要走 10 分鐘;古宇利島要在今帰仁村役場轉車,當天來回光坐車就六個半小時;回程的最後一班直達車 17:22 就從記念公園前開走(2026 年 9 月查證)。
- 交通
- 行程範例
- 預算
資料來源
- Ollama 說明文件:OpenAI 相容性(本機與 Ollama 雲端的 base_url、api_key 處理、模型名稱寫法) · 查證日期:
- Ollama 說明文件:API 介紹(Ollama API、OpenAI 相容與 Anthropic 相容三種端點的本機/雲端網址表) · 查證日期:
- Ollama 說明文件:雲端(API 金鑰、模型命名 gemma4:31b 對 gemma4:cloud、退場機制、資料處理) · 查證日期:
- Ollama 說明文件:常見問答(本機隱私聲明、127.0.0.1:11434 預設綁定、停用雲端功能) · 查證日期:
- Ollama 模型庫:gemma4(各標籤下載大小、上下文視窗與 cloud 標籤) · 查證日期:
- Ollama 模型庫:qwen3.6(各標籤下載大小與上下文視窗) · 查證日期:
- Ollama 模型庫:gpt-oss(各標籤下載大小、上下文視窗與 MXFP4 量化後的記憶體/顯示卡門檻) · 查證日期: