ライフスタイル
機械学習(Machine Learning)とは
機械学習はデータを通じてモデルを調整し、未知の入力に対する予測やコンテンツ生成を可能にします。本記事では、朝食店の仕込み量の予測を例に、特徴量、ラベル、訓練、テストがどう連携するかを説明し、教師あり学習、教師なし学習、強化学習を区別したうえで、データ漏洩、過学習、環境変化の影響を解説します。読み終えると、モデルにテストデータの取り分けが必要な理由を理解でき、具体的な問いを通じて、一見精度の高い予測を信頼してよいか判断できます。
読了目安 11 分
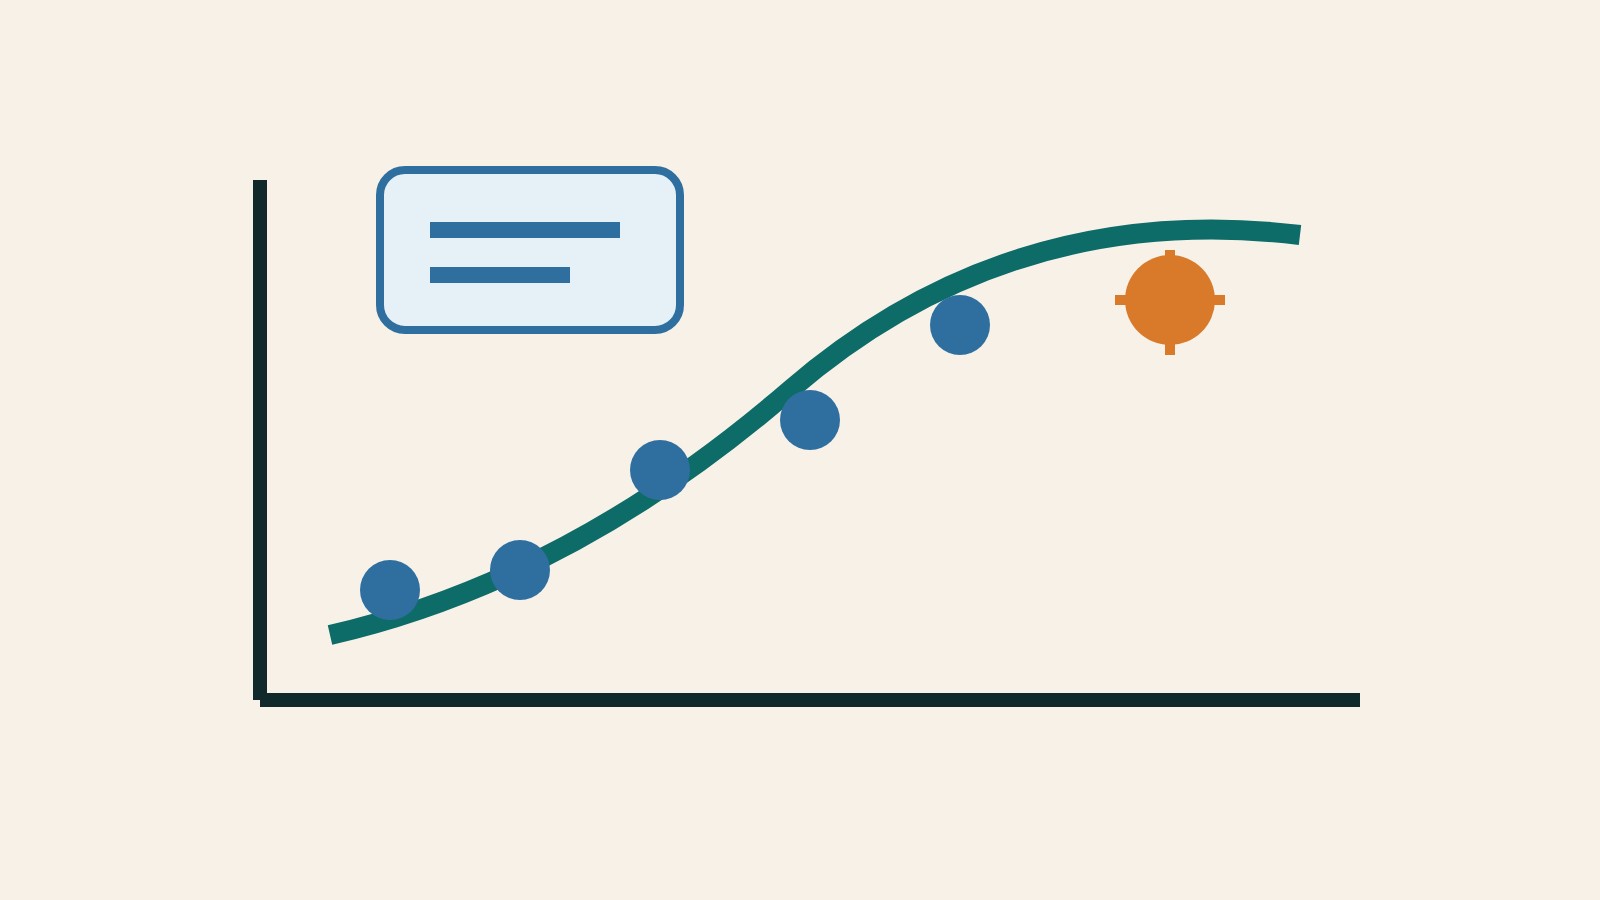
機械学習は、データを使ってモデルを訓練し、予測やコンテンツ生成に使える関係を学ばせる仕組みです。すべての判断を個別に固定したルールとして書く方法とは異なり、開発者がデータ、モデルの形式、学習目標を選び、訓練プログラムがモデルを調整します。本当に検証すべきなのは、見たことのあるデータを記憶できるかではなく、新しい状況で役立つ結果を出せるかです。
朝食店が翌日に必要な仕込みの食数を予測する場面を考えると、直感的に理解できます。店には過去の販売数、曜日、営業時間帯、天気のデータがありますが、翌日の実際の需要はまだわかりません。以下では、この独自の想定例を使って訓練と利用の違いを説明します。実際の販売数の予測や保証を提供するものではありません。情報の確認は 2026 年 9 月 14 日時点です。
データの特徴量と正解は異なる役割を持つ
Google の機械学習入門では、データでモデルを訓練し、予測やコンテンツ生成を行うものとして、この概念を説明しています。教師あり学習では、特徴量はモデルが判断に使う入力で、ラベルは訓練時に与える正解です。朝食店なら曜日と天気が特徴量になり、その日に実際に売れた食数がラベルになります。こうした役割は、取り組む課題によって決まります。
同じデータ項目でも、課題が変われば役割も変わる可能性があります。販売数を予測するなら天気は参考情報ですが、降雨を予測するなら降雨の状態が正解になり得ます。何を集めるかを決めるには、まず問題を定義する必要があります。表計算シートの全項目を入力しても、モデルが使える項目や、予測時点ではまだ存在しない情報を自動的に理解するわけではありません。
需要と販売数も区別する必要があります。ある日に少量しか用意せず、早く売り切れた場合、記録された販売数は顧客が本当に買いたかった数とは一致しません。モデルがその記録だけを学ぶと、品切れを需要の少なさと捉える可能性があります。これは独自の想定例におけるデータの意味の問題です。ラベルの業務上の定義が曖昧だと、どれほど精密なアルゴリズムでも、誤った目標を学ぶ可能性があることを示しています。
訓練は調整、推論は利用
訓練では、モデルが現在のパラメータに基づいて予測を行い、損失関数で予測とラベルの差を比較し、特定の誤差を減らすようにパラメータを更新します。訓練が終わった後、新しい曜日と入手可能な天気情報を入力して、モデルが予測値を出す利用段階を推論と呼びます。予測のたびに再訓練するとは限らず、両者は別の処理として理解する必要があります。
この例では、まず過去のデータで訓練し、その後の、訓練に使っていない日のデータでテストできます。得たいのは日ごとの予測と実際の結果の比較で、過大予測、過小予測とその影響も記録します。仕込みが少なければ品切れに、多ければ廃棄につながり、それぞれの誤りのコストは異なる可能性があります。そのため、「平均でどれくらいずれるか」だけでは、店が重視する点をすべて捉えられるとは限りません。
単純な比較基準も重要です。例えば、直近の同じ曜日の販売数をそのまま参考にする方法があります。新しいモデルが、仕組みを理解しやすい基準を明確に上回らず、しかも多くの保守作業を必要とするなら、使う価値は低いかもしれません。比較には同じテスト期間と同じ入手可能なデータを使い、ある方法だけが事前に正解を見られ、別の方法は当時の情報だけに頼る、といった条件の差を作らないようにします。
データ漏洩は好成績の意味を失わせる
scikit-learn の公式ドキュメントは、データ漏洩をよくある落とし穴として挙げています。不適切な処理を通じてテスト情報が訓練に入り込むと、評価が楽観的になりすぎます。朝食店で、その日の会計金額を、その日の販売数を予測する入力にすると、モデルは高い精度を示すかもしれません。しかし、前夜に仕込み量を決める時点では、その項目はそもそも得られません。この結果は想定する用途に役立ちません。
前処理でもデータの境界を守る必要があります。例えば、変換に必要なパラメータをデータから算出する場合は、訓練データだけで求め、同じ変換をテストデータに適用します。全データを先に処理してから訓練用とテスト用に分けると、意図せず将来の情報がモデル構築に入り込む可能性があります。ツールのパイプラインは処理の一貫性を保つ助けになりますが、データの分割は人が正しく設計する必要があります。
テストデータは、実際の利用状況にも近づける必要があります。将来の需要を予測する場合、近接した日付のデータを無作為に分けると、実際に時間を隔てて予測するより簡単な条件になり得ます。テストデータの量だけを見るのではなく、時間の順序、店ごとの違い、データの重複を考慮すべきです。評価の信頼性を支えるのは適切な設計であり、報告書に並ぶ小数点以下の桁数ではありません。
詳しい説明を読む
過去のデータを訓練用と、取り分けておくテスト用に分けます。訓練でパラメータを調整し、固定後にテスト入力から予測を行い、実際の結果と比較します。
学習方法はひとつではない
教師あり学習は入力と正解の組を使い、販売数の予測や迷惑メールの分類などを行います。教師なし学習は、正解ラベルを指定していないデータからパターンを探します。例えば、購買行動が似た取引をグループに分ける方法です。グループに分かれても、それぞれに一定のビジネス上の意味が自動的に備わるわけではなく、人による解釈が必要です。両者は解決する問題が異なるため、どちらが先進的かだけで比較することはできません。
強化学習は、システムが環境の中で行動した結果として得るフィードバックに着目し、より有利な行動戦略を学ぶ方法です。誰かが「いいね」を押すたびに即座にモデルを更新することを意味するわけではなく、あらゆる反復練習を指すわけでもありません。一般的な仕込み量の予測なら、教師ありの手法で十分な場合もあります。用語が話題だからといって、より複雑な学習方法に変える必要はありません。
生成 AI生成AI(Generative AI)とは生成AIはデータからパターンを学び、入力条件に応じて文章、画像、音声などのコンテンツを生み出します。本記事では地域のフリーマーケットの宣伝素材を例に、生成と分類・検索の違いを説明し、言語モデル、拡散、敵対的生成などの異なる手法を紹介します。また、もっともらしい内容でも事実に忠実とは限らない理由を解説します。読後には、創作上の要望、保持すべき情報、人による検収を分けて計画し、どの成果物がまだ確認待ちの草稿なのかを判断できるようになります。記事全文を読む も機械学習を基盤としていますが、説明文の生成と食数の予測では検証方法が異なります。文章による提案がもっともらしく見えても、内部の数値が信頼できる需要モデルによって算出されたとは限りません。数値予測と言語による説明を併用するシステムでは、どの部分がモデルによる推定で、どの部分がその後の説明なのかを、読者が見分けられるようにすべきです。
運用開始後もデータの変化を確認する
モデルが過学習を起こし、訓練データの細部に敏感になりすぎて、新しいデータではかえって性能が下がることがあります。また、訓練時には適切でも、近隣の学校が休みに入る、店が提供メニューを変える、新たな競合店ができるといった変化によって、データの関係が変わる可能性もあります。こうした場合は「モデルは以前とても正確だった」と言うだけでなく、最近の予測と実際の結果を改めて比較する必要があります。
予測は意思決定を助けるために使うべきで、不確実性を覆い隠すものであってはなりません。人が加えた調整とその理由を記録しておくこともできます。例えば、店が翌日に近所でイベントがあると知っていても、それがまだデータに反映されていない場合です。こうした記録は、モデルと人それぞれの役割を評価する助けになり、今後のデータ処理に取り入れる価値のある新情報を見極めることにもつながります。
機械学習を理解するうえで実用的なのは、正解をどう定義するか、入力情報はその時点で得られるか、テストは本当に切り離されているか、誤りがどんな結果を招くか、という問いです。これらを明確にするほうが、モデル名だけを知るよりも、予測システムが自分の業務に適しているかを判断するのに役立つことが多いでしょう。
| 概念 | 仕込み量の例 | 注意点 |
|---|---|---|
| 特徴量 | 曜日と予測時に得られる情報 | 会計結果を事前に使うことはできない |
| ラベル | 実際の販売数、または別途定義した需要指標 | 売り切れ時の販売数は需要を過小評価する可能性がある |
| テスト | 後の日付のデータ(訓練には不使用) | 実際の予測の順序に沿う必要がある |
人工知能(Artificial Intelligence)とは人工知能(Artificial Intelligence)とは人工知能は、さまざまな技術や応用を含む総称で、チャットボットと同じではなく、必ず文章を生成するものでもありません。本記事ではOECDのシステム定義を出発点に、写真分類と地域資源の推薦を例として、入力、推論、出力、人の目標がどうつながるかを説明し、機械学習、深層学習、生成AIとの関係を整理します。具体的な問いからAI機能の働きを判断し、能力、自律性の程度、信頼性を区別できるようになります。記事全文を読む
深層学習(Deep Learning)とは深層学習(Deep Learning)とは深層学習は多層のニューラルネットワークを使い、データからさまざまな階層の表現を学習する手法で、画像・音声・テキストのタスクによく使われます。本記事では資源ごみの写真分類を例に、隠れ層、非線形性、訓練、推論の役割を説明し、モデルが物品ではなく背景を覚える可能性や、データ・計算資源・解釈可能性のトレードオフを解説します。深層学習と機械学習全般の関係を理解し、撮影条件を変えてモデルが本当に有用なパターンを学んだか確認できるようになります。記事全文を読む
モデルパラメータ(Model Parameters)とはモデルパラメータ(Model Parameters)とはモデルパラメータは、入力を出力に変換するために学習時に調整される数値で、重みやバイアスなどがあります。この記事では簡単な式を使って、パラメータが予測にどう影響するかを説明し、モデルパラメータ、学習のハイパーパラメータ、プロンプト、生成設定を区別します。また、パラメータ数、数値精度、アクティブパラメータ数が異なる指標である理由も解説します。モデルの仕様をより正確に読み取り、パラメータが増えても知識が一件ずつ増えるわけではなく、チャットのたびにモデルを学習し直すわけでもないことを理解できます。記事全文を読む
AI 用語総索引:Loop Engineering から生成 AI まで
この記事が役に立ったら、必要な方にシェアしてください
同じテーマの記事
ライフスタイル
エージェント型検索拡張生成(Agentic RAG):いつ再検索が必要か
エージェント型検索拡張生成では、モデルが検索の判断に関与し、質問とすでに得られた根拠に応じて情報源の選択、クエリの書き換え、追加検索を行います。本記事では LangGraph のドキュメントにある具体的なフローを採用し、会場の利用条件の比較を例に固定型 RAG との違いを示すとともに、停止条件、権限、検索履歴、コスト管理を説明します。読後には、タスクに動的な探索が必要か、予測可能な固定フローで十分かを判断できるようになります。
ライフスタイル
グラフ検索拡張生成(GraphRAG):関係から文書群全体を読み解く
GraphRAG はエンティティとその関係を検索に取り入れ、文書をまたぐ関連性や全体のテーマについての回答を支援します。本記事では Microsoft の原論文と公式ドキュメントを対象に、エンティティ抽出、コミュニティ要約、ローカル検索、グローバル検索を解説し、地域イベントの記録を例に、問いによって異なる経路が必要なことを示します。また、グラフの接続漏れ、名称の誤統合、要約の歪みが回答にどう影響するかを説明し、見栄えのよい関係図を検証済みの事実と取り違えないようにします。
ライフスタイル
ナレッジグラフ(Knowledge Graph):事物と関係を明確にする
ナレッジグラフはエンティティと関係でデータを整理し、「誰が何に参加し、どこで、いつ起きたか」をリンクに沿って検索できるようにします。本記事ではコミュニティイベントのデータを例に、エンティティの識別、関係の方向、出典、時間を説明します。リソース記述フレームワーク(RDF)とプロパティグラフの表現の違いを紹介し、グラフが可視化や信頼できる事実と同じではないことも解説します。読めば、データがグラフ化に適しているかを判断でき、テーブル、ベクトル検索、グラフ検索拡張生成(GraphRAG)との組み合わせ方も理解できます。
ライフスタイル
ハイブリッド検索(Hybrid Search):語句の正確さと意味を両立
ハイブリッド検索は、全文検索やベクトル検索などの異なる検索結果を統合し、正確なコードと自然言語による要求の両方に対応します。本記事では機器の取扱説明書の検索を例に、候補の取得、重複排除、順位融合、再ランキングを解説します。逆数順位融合(RRF)が順位を使って異なる検索結果を統合する仕組みを紹介するとともに、組み合わせればあらゆる面で精度が上がるわけではないことも説明します。コードを含む質問、言い換えた質問、答えのない質問で品質を確認し、権限、フィルター、重複コンテンツによる偏りを見分けられるようになります。
この記事を引用している記事
出典
- Google:機械学習とは?確認日:
- scikit-learn:よくある落とし穴と推奨される実践方法確認日:
- Google:線形回帰確認日:
上記の参考資料および記載の確認日時点の情報をもとに整理しています。料金・時刻・機能・利用規約は変更される場合があるため、ご旅行や予約・購入の前には該当する公式サイトで最新情報をご確認ください。