生活分享
实战:制作数据整理工具
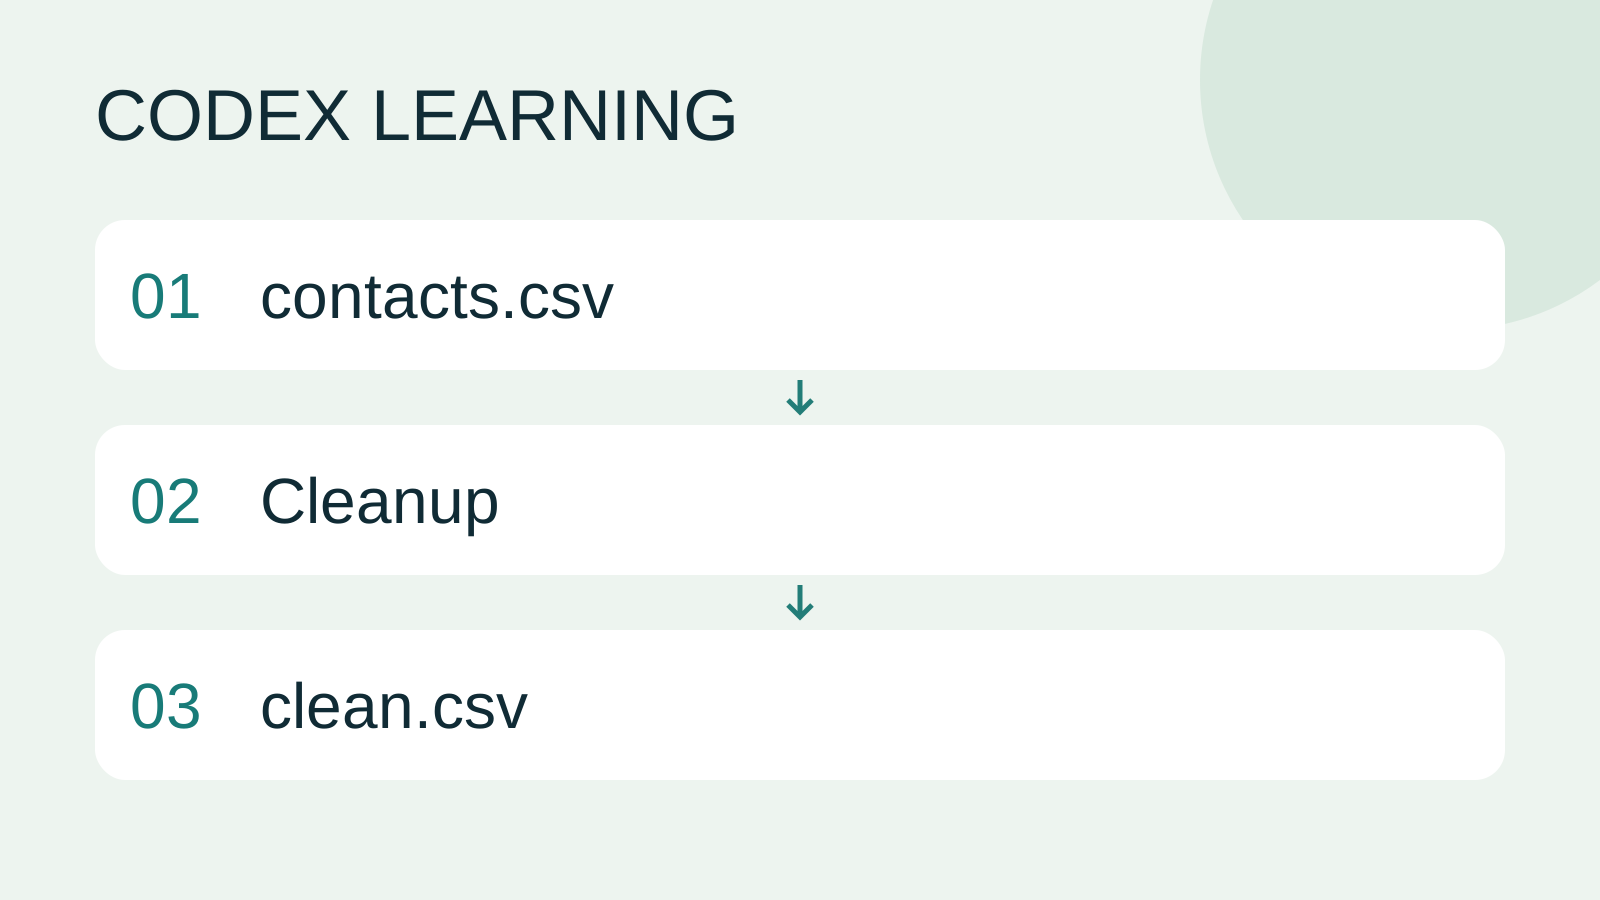
这个实战制作 CSV 名单整理工具,保留原档并产生新结果。规则固定为修剪空白、将 email 转小写、同 email 保留第一笔有效资料、略过缺姓名或格式不合的 email,最后回报保留、重复与无效笔数。这是练习用格式检查,不保证信箱真实存在。
阅读时间约 20 分钟 · 操作 45 分钟
本篇目录
返回 Codex 教学总目录Codex 学习中心:完整教程目录从安装、第一个任务到 MD 规则与进阶集成,规划 60 篇 Codex 教程、十个单元。按程度、平台、需求或命令搜索下一篇;尚未公开的教程会标示状态,方便安排学习路线。阅读全文
目标与准备
步骤 1:建立可以人工验算的资料
在编辑器开启 csv-lab,以 UTF-8 建立 contacts.csv,完整内容如下。第一列栏名必须正好是 name,email,顺序也相同。保留 Alice 前后与第一笔 email 的空白,它们是测试条件。使用纯文字编辑器检查原文,避免试算表另存时换编码或改值。Windows 执行 py -3 --version,macOS/Linux 执行 python3 --version,确认版本至少为 Python 3.9;本例不需要 pip、pandas 或资料库。
name,email
 Alice , ALICE@EXAMPLE.TEST
Alice duplicate,alice@example.test
Bob,bob@example.test
Missing,
| 输入列 | 判定 | 输出 |
|---|---|---|
| Alice/ALICE@EXAMPLE.TEST | 有效,清除空白并转小写 | Alice/alice@example.test |
| Alice duplicate/alice@example.test | 与有效 email 重复 | 不保留 |
| Bob/bob@example.test | 有效 | Bob/bob@example.test |
| Missing/空 email | 无效 | 不保留 |
因此预期 kept 2、duplicate 1、invalid 1。去重依标准化后 email,不依姓名;若第一笔同地址资料因姓名空白而无效,后来第一笔有效资料仍可保留。这些规则应在生成程式前说清楚。
步骤 2:请 Codex 先规划整理契约
让 Codex 开启 csv-lab,先用 Plan 模式Plan 模式:先规划再实现Plan 模式适合还需要决定范围或做法的工作。它帮你把需求整理成可实作的计划,但计划本身不是已完成的程式。使用时先定义要讨论的问题,再检查计划是否包含输入、输出、限制与验证。阅读全文确认输入、输出、例外及验收,再交付实作。每次只输出新档案;结构坏掉要整次失败,不留下看似成功的半份资料。一般无效 email 是可计数的资料问题,但缺栏、多栏或错误表头是契约错误。这个区分会直接影响下游是否敢使用结果,不能只写一句帮我清理 CSV。
Create clean_contacts.py using Python's standard library only.
Expose clean(source: Path, target: Path) returning kept/duplicate/invalid counts.
Read UTF-8 with optional BOM using csv.DictReader, not string splitting.
Require exactly name,email. Trim both fields and lowercase email.
Keep the first valid row per email; reject empty names and invalid email shapes.
Treat missing/extra columns or malformed CSV as whole-run failures.
Read and validate before creating output. Never change input or overwrite output.
Write UTF-8 with name,email and a newline after each row.
CLI takes source and target paths, reports counts on stderr and exits 0 on success,
1 on data/file errors. Add tests for preservation, duplicates, Unicode, quoted
commas, malformed rows and overwrite refusal. Do not use real contact data.
步骤 3:检查参考程式的保护位置
以下是完整参考程式,存为 clean_contacts.py 可独立执行;若你已让 Codex 生成版本,先另存备份,再比较差异。csv 模组负责引号、逗号与换行,不能用 split(',') 替代。程式在全部输入读完后才用 x 模式建立输出;已有目标档就失败。这能避免输入格式错误时留下输出,但磁碟在写到一半失败仍可能留下不完整档案,该次必须标记失败并检查产物,不能声称这是完整交易系统。
"""Clean a practice CSV without overwriting either the input or an existing output."""
import argparse
import csv
import json
import re
import sys
from pathlib import Path


def clean(source: Path, target: Path) -> dict[str, int]:
    if source.resolve() == target.resolve():
        raise ValueError("Input and output must differ")
    rows = []
    seen = set()
    counts = {"kept": 0, "duplicate": 0, "invalid": 0}
    with source.open(encoding="utf-8-sig", newline="") as stream:
        reader = csv.DictReader(stream, strict=True)
        if reader.fieldnames != ["name", "email"]:
            raise ValueError("Expected exactly: name,email")
        for row in reader:
            if None in row or any(value is None for value in row.values()):
                raise ValueError("Malformed CSV row")
            name = row["name"].strip()
            email = row["email"].strip().lower()
            # An exercise-level shape check, not proof an address can receive mail.
            if not name or not re.fullmatch(r"[^\s@]+@[^\s@]+\.[^\s@]+", email):
                counts["invalid"] += 1
            elif email in seen:
                counts["duplicate"] += 1
            else:
                seen.add(email)
                rows.append({"name": name, "email": email})
                counts["kept"] += 1
    # Exclusive creation: a rerun never silently replaces an existing result.
    with target.open("x", encoding="utf-8", newline="") as stream:
        writer = csv.DictWriter(stream, fieldnames=["name", "email"], lineterminator="\n")
        writer.writeheader()
        writer.writerows(rows)
    return counts


def main() -> int:
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("source", type=Path)
    parser.add_argument("target", type=Path)
    args = parser.parse_args()
    try:
        counts = clean(args.source, args.target)
    except (OSError, ValueError, csv.Error) as error:
        print(str(error), file=sys.stderr)
        return 1
    print(json.dumps(counts), file=sys.stderr)
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
步骤 4:执行、保存状态与核对输出
执行前确认 cleaned-01.csv 不存在;macOS/Linux 的 contacts-before.csv 也须是未使用档名,避免 cp 覆盖旧备份。Windows PowerShell 记下输入 SHA256;macOS/Linux 则复制自己这份虚构输入供 cmp 比较。计数写在 stderr,成功时仍会显示 JSON,不能只因这个通道有文字就判定失败。立即保存退出状态,再核对输出与原件。
$csvBefore = (Get-FileHash -LiteralPath contacts.csv -Algorithm SHA256).Hash
py -3 clean_contacts.py contacts.csv cleaned-01.csv
$csvExit = $LASTEXITCODE
$csvExit
Get-Content -LiteralPath cleaned-01.csv
$csvBefore -eq (Get-FileHash -LiteralPath contacts.csv -Algorithm SHA256).Hash
cp contacts.csv contacts-before.csv
python3 clean_contacts.py contacts.csv cleaned-01.csv
csv_exit=$?
echo "$csv_exit"
cat cleaned-01.csv
cmp contacts-before.csv contacts.csv
name,email
Alice,alice@example.test
Bob,bob@example.test
预期退出 0,计数为 kept 2、duplicate 1、invalid 1,输出两笔且顺序保留,PowerShell 比对 True 或 cmp 无差异。接著原指令再执行一次,因 cleaned-01.csv 已存在应退出 1,既有输出内容不变;不要先删掉它来假装通过覆写防护。再把输入与输出都指定 contacts.csv,应拒绝且原件不变。这些失败是验收成功的一部分。
步骤 5:Unicode、引号与坏列
另存下方 contacts-unicode.csv,输出用 cleaned-unicode.csv。预期 kept 1、duplicate 0、invalid 0,姓名中的逗号仍属同一栏,Unicode 不变。若输出重新打开变成乱码,先确认编辑器以 UTF-8 解码,不立刻改写原始输入。再建立 bad.csv,内容为 name,email 换行 Alice,也就是缺少 email 栏;指定全新的 cleaned-bad.csv 执行,应退出 1 且不建立输出。把表头改成 email,name 或多加第三栏也应拒绝。
name,email
"林, Alex",alex@example.test
延伸:保留第一笔有效资料
name,email
 ,first@example.test
First valid,FIRST@example.test
Later duplicate,first@example.test
用这份新增输入与尚不存在的 cleaned-first-valid.csv 执行同一程式,其他参数不变。预期 kept 1、duplicate 1、invalid 1:第一笔姓名空白而无效,不应先占住 email;第二笔才是第一笔有效资料;第三笔才算重复。若输出没有 First valid,检查 seen 是在资料通过验证后才加入,而不是先去重再验证。原 contacts.csv 与 cleaned-01.csv 都保持原样。
name,email
First valid,first@example.test
步骤 6:把验收留成可重跑测试
把下方完整测试存为 test_clean_contacts.py,放在程式与 contacts.csv 旁边。它使用暂存资料夹,会核对输入位元组未变、既有输出拒绝覆写、Unicode、引号与结构错误;不在你的练习目录累积测试产物。Windows 执行 py -3 -m unittest -v test_clean_contacts.py;macOS/Linux 执行 python3 -m unittest -v test_clean_contacts.py。参考版本应有三项测试全部通过;若生成版本的介面不同,先对齐 clean 函式契约,不随意删除失败案例。
import csv
import tempfile
import unittest
from pathlib import Path

from clean_contacts import clean


class CleanupTests(unittest.TestCase):
    def test_contract_and_input_preservation(self):
        original = (Path(__file__).parent / "contacts.csv").read_bytes()
        with tempfile.TemporaryDirectory() as directory:
            source = Path(directory) / "input.csv"
            target = Path(directory) / "output.csv"
            source.write_bytes(original)
            self.assertEqual(clean(source, target), {"kept": 2, "duplicate": 1, "invalid": 1})
            self.assertEqual(source.read_bytes(), original)
            with target.open(encoding="utf-8", newline="") as stream:
                self.assertEqual(list(csv.DictReader(stream)), [{"name": "Alice", "email": "alice@example.test"}, {"name": "Bob", "email": "bob@example.test"}])
            with self.assertRaises(FileExistsError):
                clean(source, target)
            with self.assertRaises(ValueError):
                clean(source, source)

    def test_unicode_and_quoted_comma(self):
        with tempfile.TemporaryDirectory() as directory:
            source, target = Path(directory) / "in.csv", Path(directory) / "out.csv"
            source.write_text('name,email\n"林, Alex",alex@example.test\n', encoding="utf-8")
            self.assertEqual(clean(source, target)["kept"], 1)
            self.assertIn('"林, Alex"', target.read_text(encoding="utf-8"))

    def test_bad_header_and_malformed_rows_create_no_output(self):
        with tempfile.TemporaryDirectory() as directory:
            source, target = Path(directory) / "in.csv", Path(directory) / "out.csv"
            for value in ["email,name\na@b.test,A\n", "name,email\nAlice\n", "name,email\nA,a@b.test,extra\n"]:
                source.write_text(value, encoding="utf-8")
                with self.assertRaises(ValueError):
                    clean(source, target)
                self.assertFalse(target.exists())


if __name__ == "__main__":
    unittest.main()
交付、还原与限制
交付时提供原始虚构 CSV、程式、测试、执行指令、计数及未修改原件的证据。可以下载完整 CSV 练习档比对;压缩档包含参考程式,不需要先完成其他专案。重新整理用新的输出名称,清理时只选自己已确认的产物。若要读真正名单、处理超大档案或汇入试算表,另设计权限、串流及公式文字的处理规则;本篇把资料当文字保存,不自动把外部内容当命令执行。下一篇练习接手既有专案实战:维护既有专案建立现况基准,处理一项真实变更,以回归检查和交接纪录交付可追溯成果。阅读全文,保留这里建立的基准与验证方法。
返回 Codex 教学总目录Codex 学习中心:完整教程目录从安装、第一个任务到 MD 规则与进阶集成,规划 60 篇 Codex 教程、十个单元。按程度、平台、需求或命令搜索下一篇;尚未公开的教程会标示状态,方便安排学习路线。阅读全文
阅读完整文字说明
contacts.csv to Cleanup to clean.csv
同主题延伸阅读
生活分享
Codex 学习中心:完整教程目录
从安装、第一个任务到 MD 规则与进阶集成,规划 60 篇 Codex 教程、十个单元。按程度、平台、需求或命令搜索下一篇;尚未公开的教程会标示状态,方便安排学习路线。
生活分享
Worktree 与多任务隔离
Worktree 让同一个 Git 程式库有不同的工作目录,各自承接不同分支。它适合让两项工作分开改档,但资料库、连接埠与外部服务仍可能共用,不能把档案隔离当成所有资源隔离。
生活分享
实战:制作小网站
从 brief.md 规划并制作 Small Steps 待办网站,完成新增、完成、删除、筛选与本机资料保存。将 HTML、CSS、资料函式、画面事件与测试分开,以 Node 测试和浏览器操作验收,并留下可重新启动与还原的交接纪录。
生活分享
用量与效率:减少重工
记录任务条件、模型选项、时间与成果,找出能减少无效重试和过多上下文的调整。
最新旅游情报攻略

攻略东京
东京住哪一区:新宿、上野、东京站、涩谷、浅草、池袋、银座七区比较,机场交通、住宿税、行李寄送一次看
东京住哪一区?用同一套标准比较新宿、上野、东京站、涩谷、浅草、池袋、银座七个区域:从成田、羽田机场怎么过来、有哪些线路、周边有什么、街区氛围、适合谁。附比较表与山手线示意图,以及 2026 年 9 月核实的东京都住宿税(2027 年 4 月改为 3%)和机场宅急便寄送行李的规则。
- 预算
- 酒店

攻略东京
东京交通票券怎么选:Suica/Welcome Suica、Tokyo Subway Ticket、JR Pass 值不值得买
第一次去东京,每人先用一张 IC 卡按次付费(Welcome Suica 免押金、有效期 28 天)。一天搭四趟以上地铁,再加买 2,000 日元的 Tokyo Subway Ticket 72 小时券;只玩东京、不去关西,买 JR Pass 一定不划算。用决策图比较 TOURIST PASMO、iPhone 里的 Suica、东京 Metro 一日券能搭什么、不能搭什么;价格于 2026 年 9 月核实。
- 交通
- 预算

攻略东京
东京迪士尼乐园、海洋攻略:票价、梦幻泉乡 Fantasy Springs、尊享卡 DPA 与预约等候卡怎么用,第一次去选哪个园区
东京迪士尼一日护照采用浮动票价,2026 年 9 月平日大多为 9,900 日元、周末为 10,900 日元,官网每天 14:00 开售两个月后同一天的门票;免费的优先通行卡已不在官网服务清单,缩短排队时间只剩付费的迪士尼尊享卡(每人每次 1,000 至 3,500 日元)。另有运营时间与 25 周年活动、预约等候卡与报名体验、梦幻泉乡如何进入,以及第一次去选乐园还是海洋;2026 年 9 月通过东京迪士尼度假区官网核实。
- 行程范例
- 亲子
资料来源
- Codex prompting · 查证日期:
- Python csv module · 查证日期: