生活分享
与旅行无关的分享:AI 工具与教程、软件、3C 设备与日常心得。
按主题浏览
全部文章
生活分享
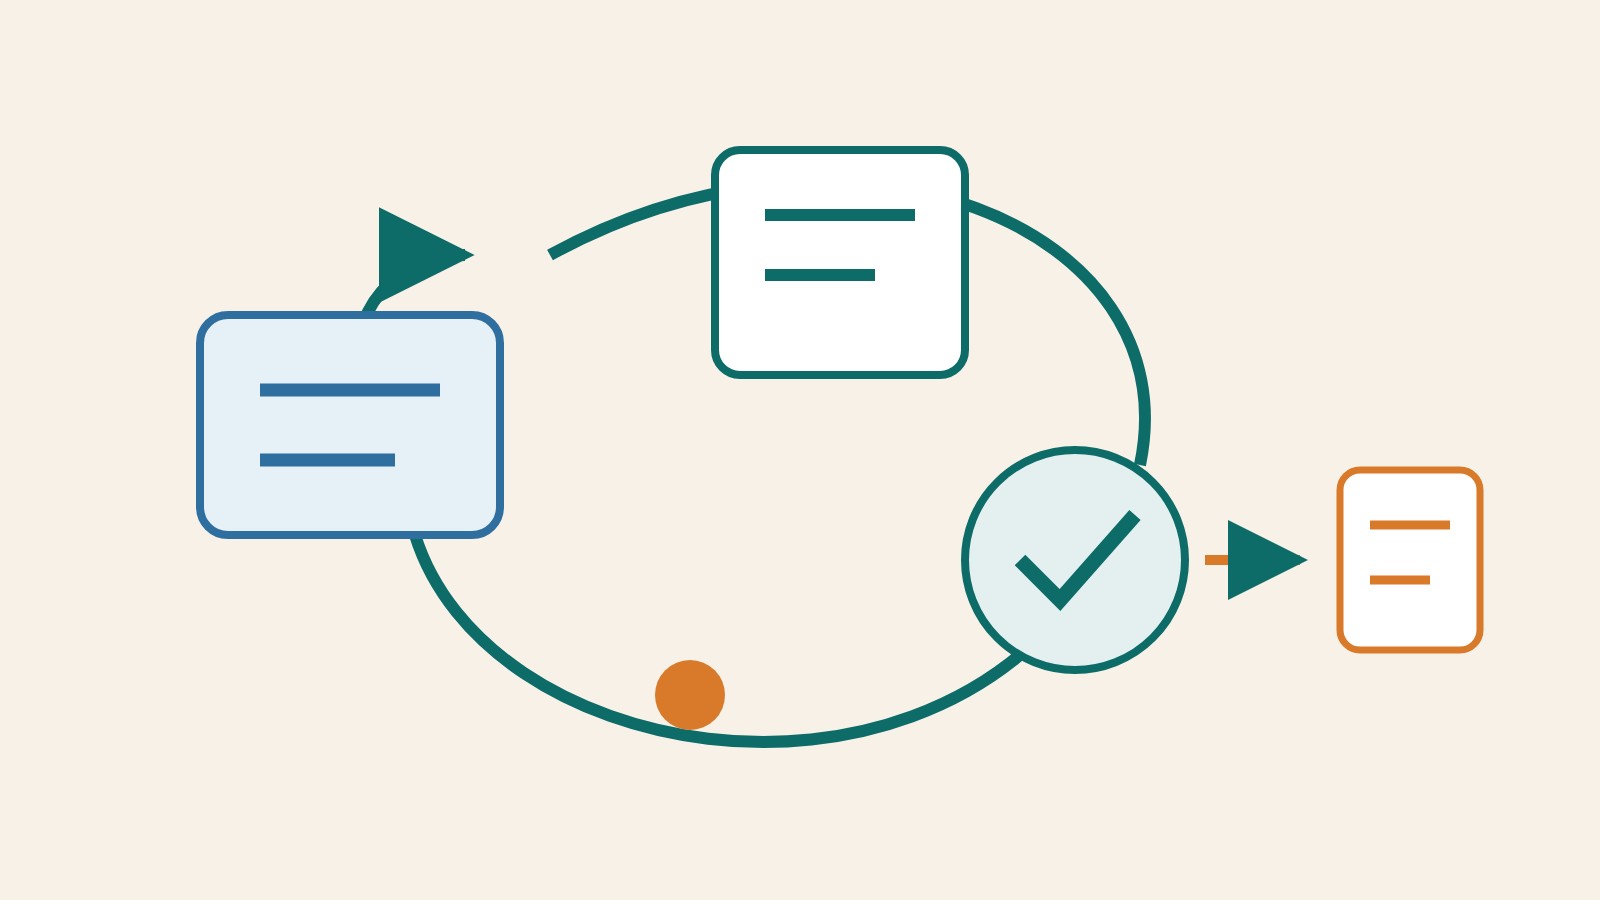
代理式检索增强生成(Agentic RAG):何时需要再查一次
代理式检索增强生成让模型参与检索决策,根据问题与已找到的证据选择数据来源、改写查询或继续补查。本文采用 LangGraph 文档中的具体流程,以比较场地借用条件示范它和固定式 RAG 的差别,并说明停止条件、权限、查询记录及成本控制。读完能判断任务需要动态探索,还是用可预测的固定流程就足够。
- AI 工具
- 教程
- AI 名词解释
生活分享
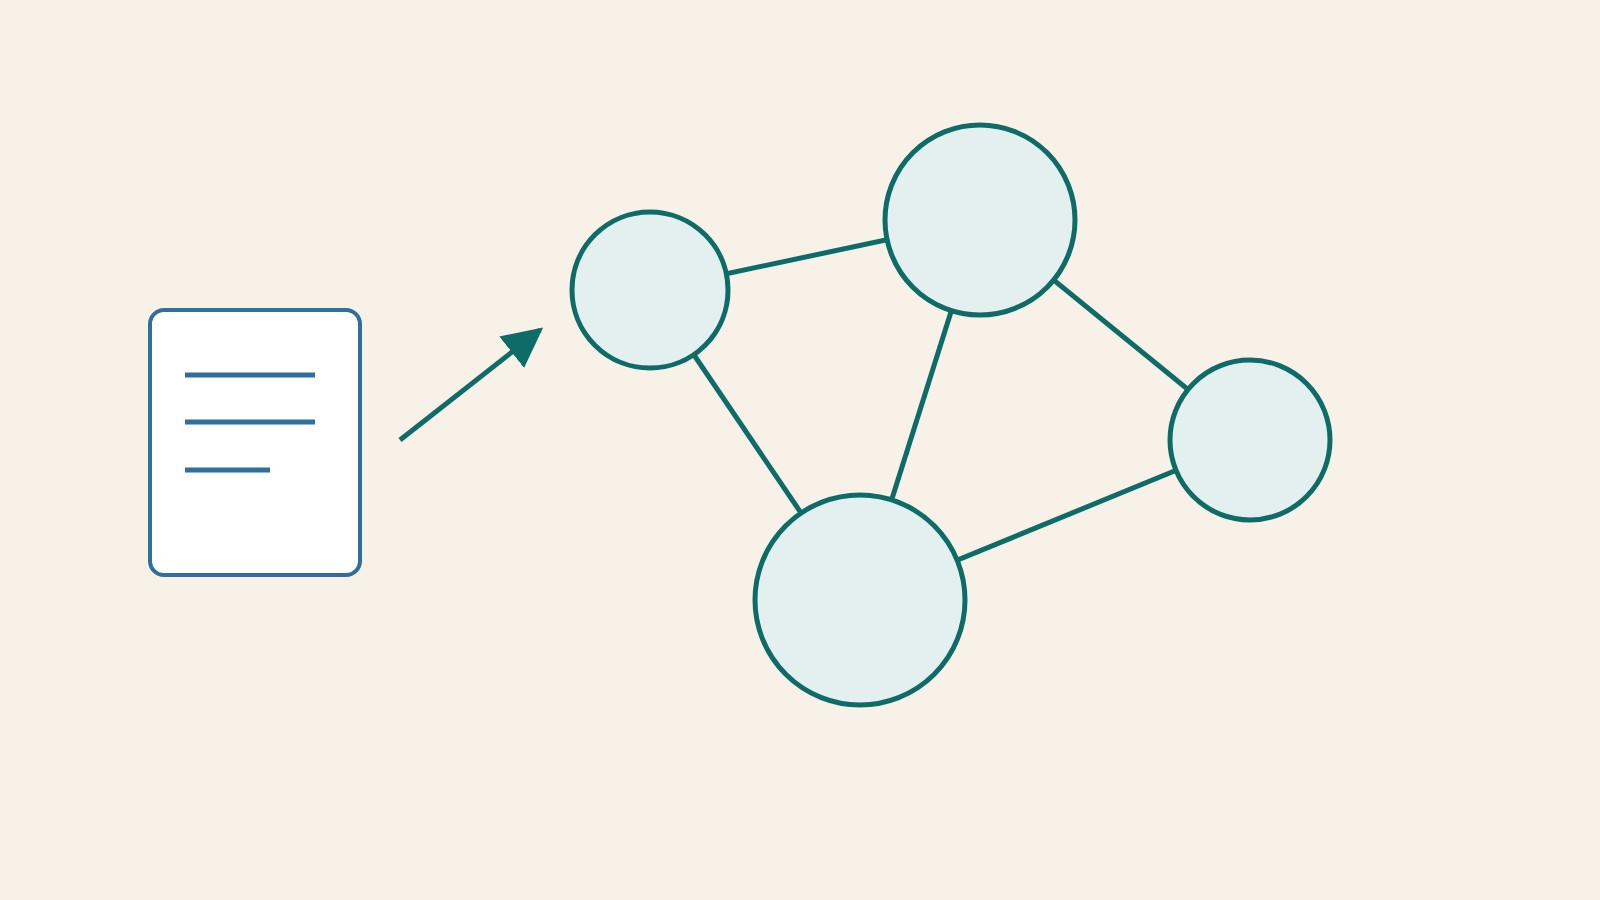
图谱检索增强生成(GraphRAG):从关系看懂整批文档
GraphRAG 把实体及其关系纳入检索,帮助回答跨文档的关联与整体主题。本文以 Microsoft 原始论文及官方文档为范围,拆解实体抽取、社区摘要、局部搜索和全局搜索,以地方活动记录示范不同问题需要不同路径。也说明图谱漏连、名称误合并与摘要失真如何影响答案,避免把一张漂亮的关系图误认为已验证的事实。
- AI 工具
- 教程
- AI 名词解释
生活分享
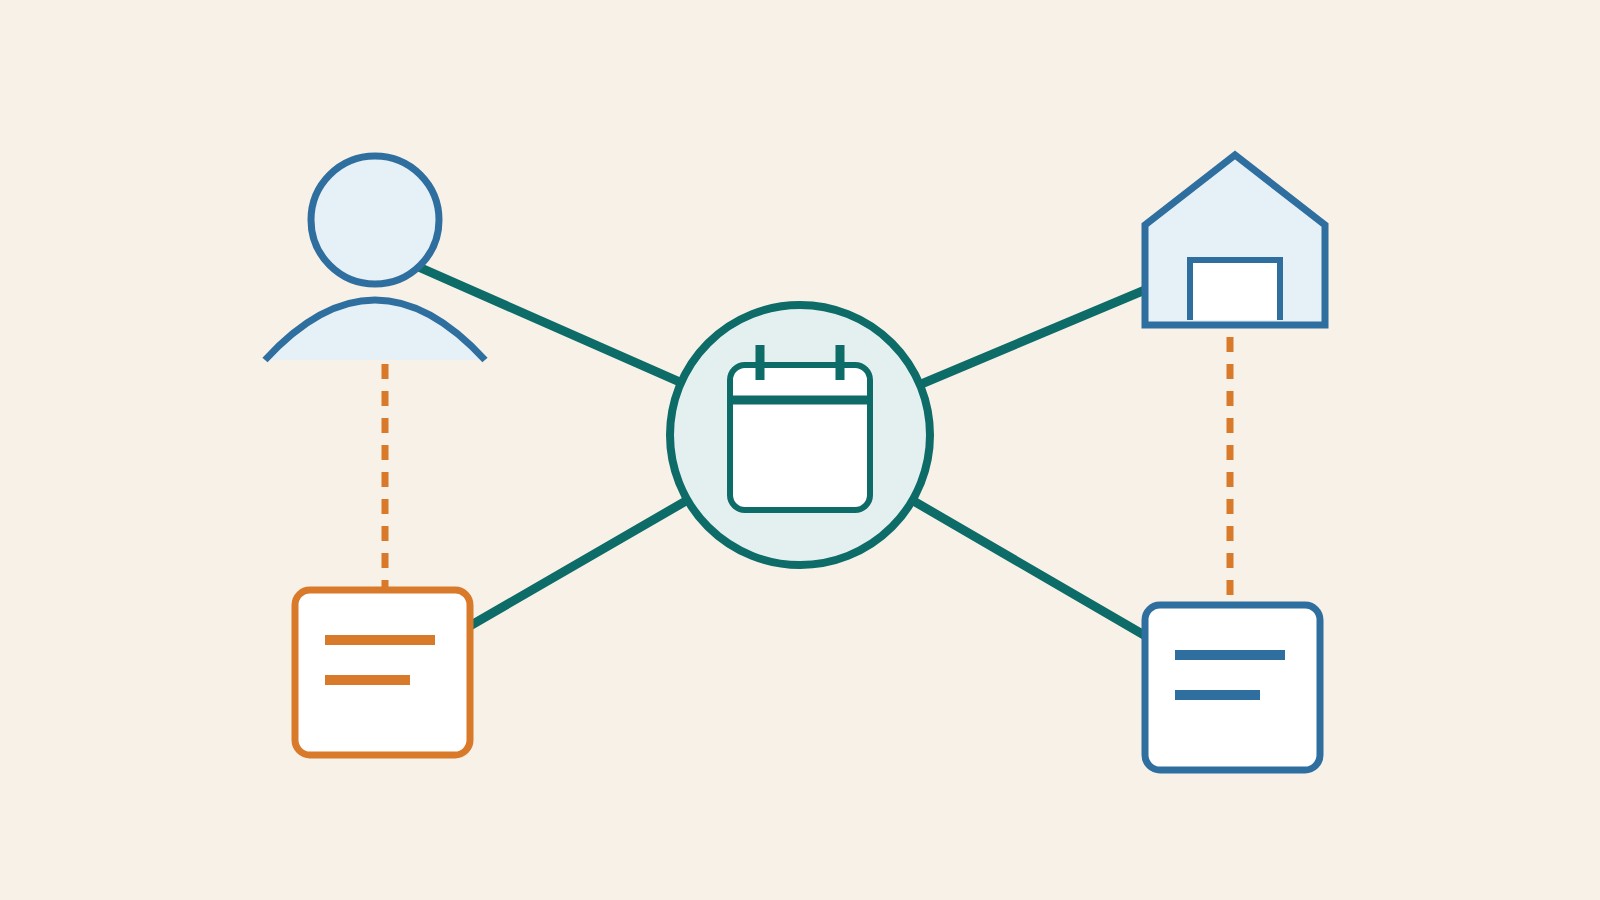
知识图谱(Knowledge Graph):把事物与关系说清楚
知识图谱用实体及关系组织数据,让“谁参与什么、在哪里、何时发生”能沿链接查询。本文以社群活动数据演示实体识别、关系方向、来源与时间,介绍资源描述框架(RDF)和属性图的表示差异,也说明图谱不等于可视化或可信事实。读完能判断数据适不适合建图,并理解它如何与数据表、向量搜索及图谱检索增强生成(GraphRAG)搭配。
- AI 工具
- 教程
- AI 名词解释
生活分享
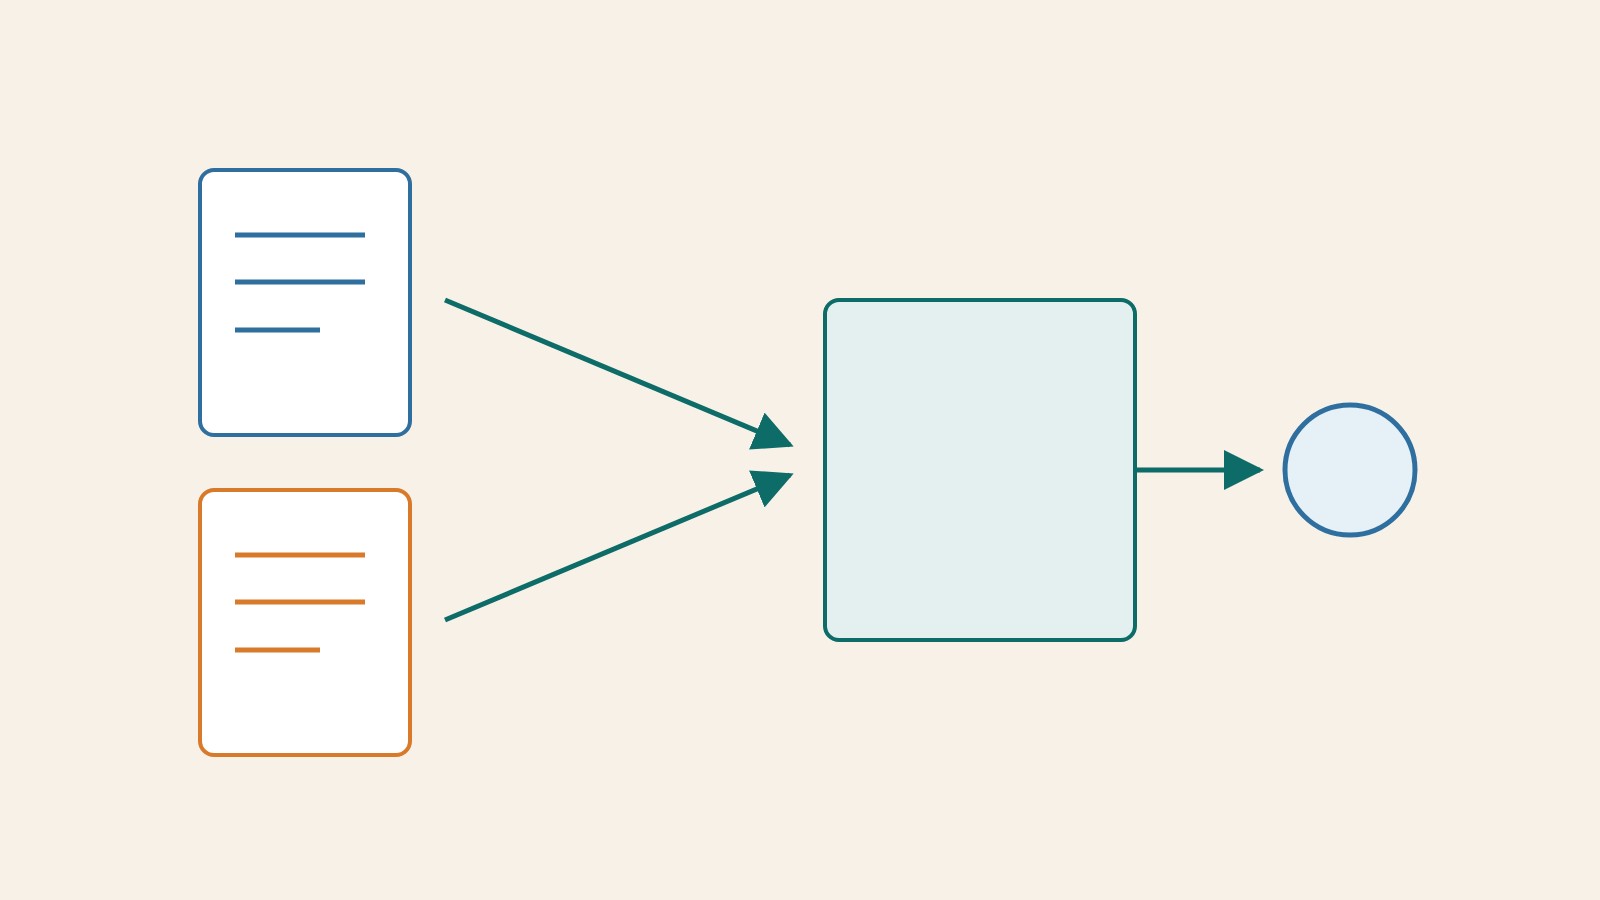
混合搜索(Hybrid Search):兼顾精确字词与语义
混合搜索将全文搜索与向量等不同检索结果合并,兼顾精确代码和自然语言需求。本文用设备说明书查询拆解候选获取、去重、排名融合和重新排序,介绍倒数排名融合(RRF)如何用名次融合不同搜索结果,也提醒混合不保证全面更准。读完能用代码题、改写题和无答案题检查质量,并辨认权限、筛选与重复内容造成的偏差。
- AI 工具
- 教程
- AI 名词解释
生活分享
检索增强生成(RAG)是什么:让回答附上可查的依据
检索增强生成会先从外部资料中找出相关内容,再交给语言模型组织回答。本文以活动报名规章的问答为例,拆解建立索引、检索、生成与来源核对,说明它和搜索、微调的区别,也解释为什么有引用仍可能答错。读完能判断问题出在资料未更新、文档没找齐,还是模型对证据过度解读,并知道什么情况应保留“不知道”的答案。
- AI 工具
- 教程
- AI 名词解释
生活分享
重新排序(Reranking):从找到内容到把好答案排在前面
重新排序会对第一轮搜索找到的候选再次进行相关性判断,常用于改善搜索列表与 RAG 的上下文质量。本文用图书馆借阅规则演示检索器和交叉编码器如何分工,说明候选缺漏、输入截断、相关性分数与真假判断的差异。读完能辨别该扩大检索、修正文本块,还是增加重新排序,并用合适的测试避免为了改善排名付出不必要的等待。
- AI 工具
- 教程
- AI 名词解释
生活分享
语义搜索(Semantic Search):用不同说法找到相关内容
语义搜索尝试根据查询和内容的意思查找资料,不只匹配相同字词。本文以常见客服问题说明查询编码、文档表示与候选排序,区分语义相似和真正符合需求,也介绍否定句、专有代码、跨语言与无答案问题的限制。读完能判断搜索问题该从嵌入模型、数据整理、混合搜索或重新排序入手改善,而不把自然语言答案误当成搜索本身。
- AI 工具
- 教程
- AI 名词解释
生活分享
嵌入向量(Embedding)是什么:把内容放进可比较的空间
嵌入向量是模型把文字等内容转换成一组数值的表示方式,常用于语义搜索、分类与聚类。本文用“下雨可以去哪里”的查询拆解编码、相似度与候选结果,说明向量距离不等于真假、每一维也未必能直接命名,并介绍模型版本、语言能力与长文截断的影响。读完能分清嵌入向量、向量数据库与生成答案各自负责什么。
- AI 工具
- 教程
- AI 名词解释
生活分享
零样本提示(Zero-shot Prompting)是什么:先把任务说清楚
零样本提示是不提供已解答的示例,直接用规则与新数据请模型完成工作;零样本不表示模型从未训练,也不表示提示词不能附带资料。本文用整理家用电器说明的例子,说明如何写清输出字段、信息缺漏与判断范围,并比较少样本提示与检索资料的不同用途。附对照表及测试流程,让你知道什么时候直接提问就够,什么时候需要加例子。
- AI 工具
- 教程
- AI 名词解释
生活分享
多模态 AI(Multimodal AI)是什么:把图像、声音与文字一起理解
多模态 AI 能处理不止一种信息形式,例如文字、图像、声音或视频,但支持多种输入不代表也能生成所有输出。本文用组装收纳架的情境,说明图像与文字如何互相补充、原生集成与串联流程的区别,以及看到图片为何仍可能漏读细节。附输入设计和交叉核对方法,帮你判断模型是依据画面回答,还是把合理猜测当成看到的事实。
- AI 工具
- 教程
- AI 名词解释
生活分享
少样本提示(Few-shot Prompting)是什么:用例子讲清楚格式
少样本提示是在同一次输入里放入少量示范,让模型按照示例处理新数据;它不等于给模型重新训练。本文用失物招领分类的情境,教你挑选普通案例、边界案例与数据不足案例,避免模型只模仿表面用词。附测试方法、比较表与原创图解,说明何时应增加例子、何时先改分类规则,以及为什么示范数据必须和验证数据分开。
- AI 工具
- 教程
- AI 名词解释
生活分享
微调(Fine-tuning):让现有模型更适合你的任务
微调是在现有模型上继续训练,让它更适合特定任务或领域。本文以客服邮件分类说明数据整理、参数更新、保留测试集与版本部署,区分全量微调、LoRA、监督微调和 RAG,也解释训练成绩变好却实际退步的原因。读完能判断问题是否值得微调,以及如何检查格式一致性、未知类型、数据泄漏和原有能力退化。
- AI 工具
- 教程
- AI 名词解释
生活分享
分词(Tokenization)是什么:文本进入模型前的切分
分词是把原始文本转成 token 与编号的处理步骤,不等于为中文句子找出语法上的词。本文从早餐店整理餐品的例子出发,解释词汇表、子词、空白与规范化如何影响结果,分清 BPE、Unigram 与分词工具的角色,并提供检查繁体中文、混合语言及罕见符号的方法。读完能判断问题出在文本切分、模型理解,还是文件读取阶段。
- AI 工具
- 教程
- AI 名词解释
生活分享
基础模型(Foundation Model)是什么
基础模型指在广泛数据上训练、能适配多种下游任务的模型,重点不只是参数很多,也不等于完整的聊天产品。本文从 Stanford CRFM 的用法出发,以社区服务邮箱的分类、摘要与搜索为例,说明共用模型如何成为不同应用的起点,整理它与大型语言模型、生成式 AI 和开放权重的区别。读完能辨认模型能力、应用适配与实际部署之间的界限。
- AI 工具
- 教程
- AI 名词解释
生活分享
监督式微调(SFT):用好示范教模型完成任务
监督式微调以输入和期望输出作为训练示范,让现有模型学习更稳定的任务行为。本文用会议待办整理说明数据配对、对话角色、损失计算与保留测试集,区分 SFT、少样本提示、LoRA 和偏好优化,也解释示范中的猜测与格式错误如何被学进去。读完能检查训练数据是否真的教会模型保留未知信息,而不是只学会看起来完整。
- AI 工具
- 教程
- AI 名词解释
生活分享
过度拟合(过拟合,Overfitting)是什么:历年真题全对,新题却答错
过度拟合是模型连训练数据里的噪声与特例都学进去:训练时几乎全对,遇到没见过的数据就失准。用示例误差曲线说明训练集、验证集、测试集的分工,对照低度拟合,整理更多数据、正则化、dropout、提前停止等对策,并解读深度网络能记住随机标签的研究,以及基准测试题目泄露造成的“看起来会”。
- AI 工具
- 教程
- AI 名词解释
生活分享
模型参数(Model Parameters)是什么
模型参数是训练时调整、用来把输入转成输出的数值,例如权重与偏置。本文用简单算式示例说明参数如何影响预测,区分模型参数、训练超参数、提示词与生成设置,并解释参数量、数值精度和激活参数为何是不同指标。读完能更准确地阅读模型规格,理解参数增加不等于知识逐条增加,也不代表每次聊天都在重新训练模型。
- AI 工具
- 教程
- AI 名词解释
生活分享
推论(Inference)是什么:模型训练完成后,每次回答都在做的计算
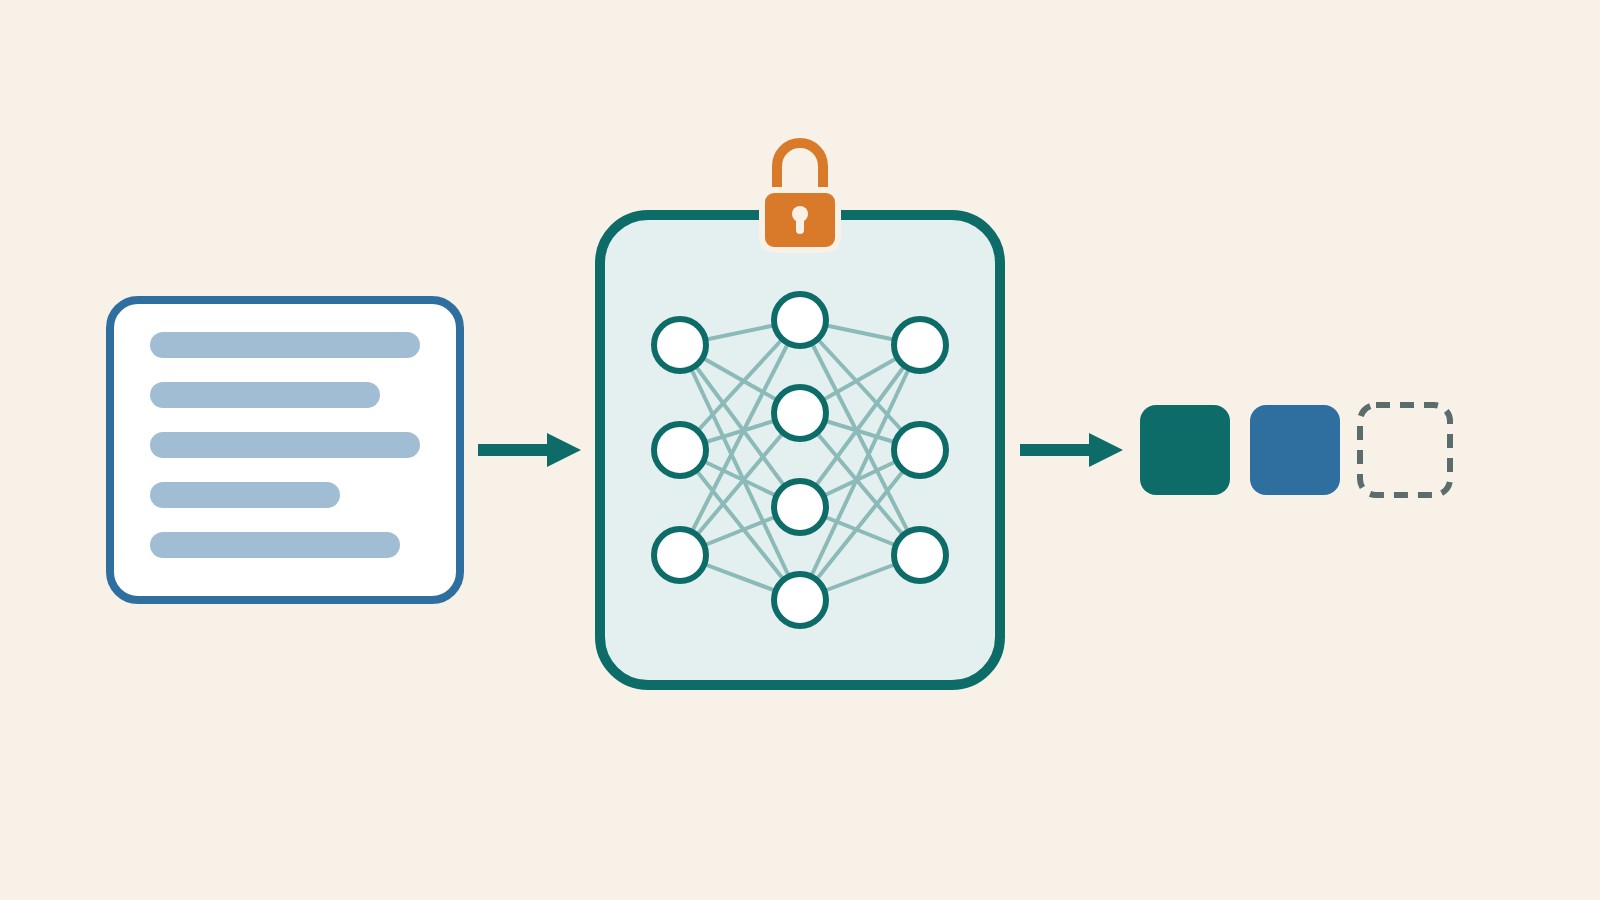
推论是用已训练好的模型处理新输入、生成输出的过程,权重在这个阶段固定不变。内容拆解语言模型推论的两个阶段:读入提示(prefill)与逐个生成(decode),说明首个 token 时间、完整回答时间与吞吐量的区别,区分推论(inference)与推理(reasoning)、云端与本地,并看懂批处理、量化与缓存各自节省在哪里。
- AI 工具
- 教程
- AI 名词解释
生活分享
预训练(Pretraining):模型的基础能力从哪里来
预训练是在针对特定任务调整之前,让模型从大量数据中学到可复用表示与规律的阶段。本文用下一个 token 预测和遮住内容再还原的例子说明数据、目标与参数更新,区分预训练、微调和使用时提供上下文,也解释为什么学过文字不等于记得来源或保证事实正确。读完能理解基础模型的能力来源,以及训练数据质量和评估污染的影响。
- AI 工具
- 教程
- AI 名词解释
生活分享
注意力机制(Attention)是什么:模型怎么决定要参考哪些 token
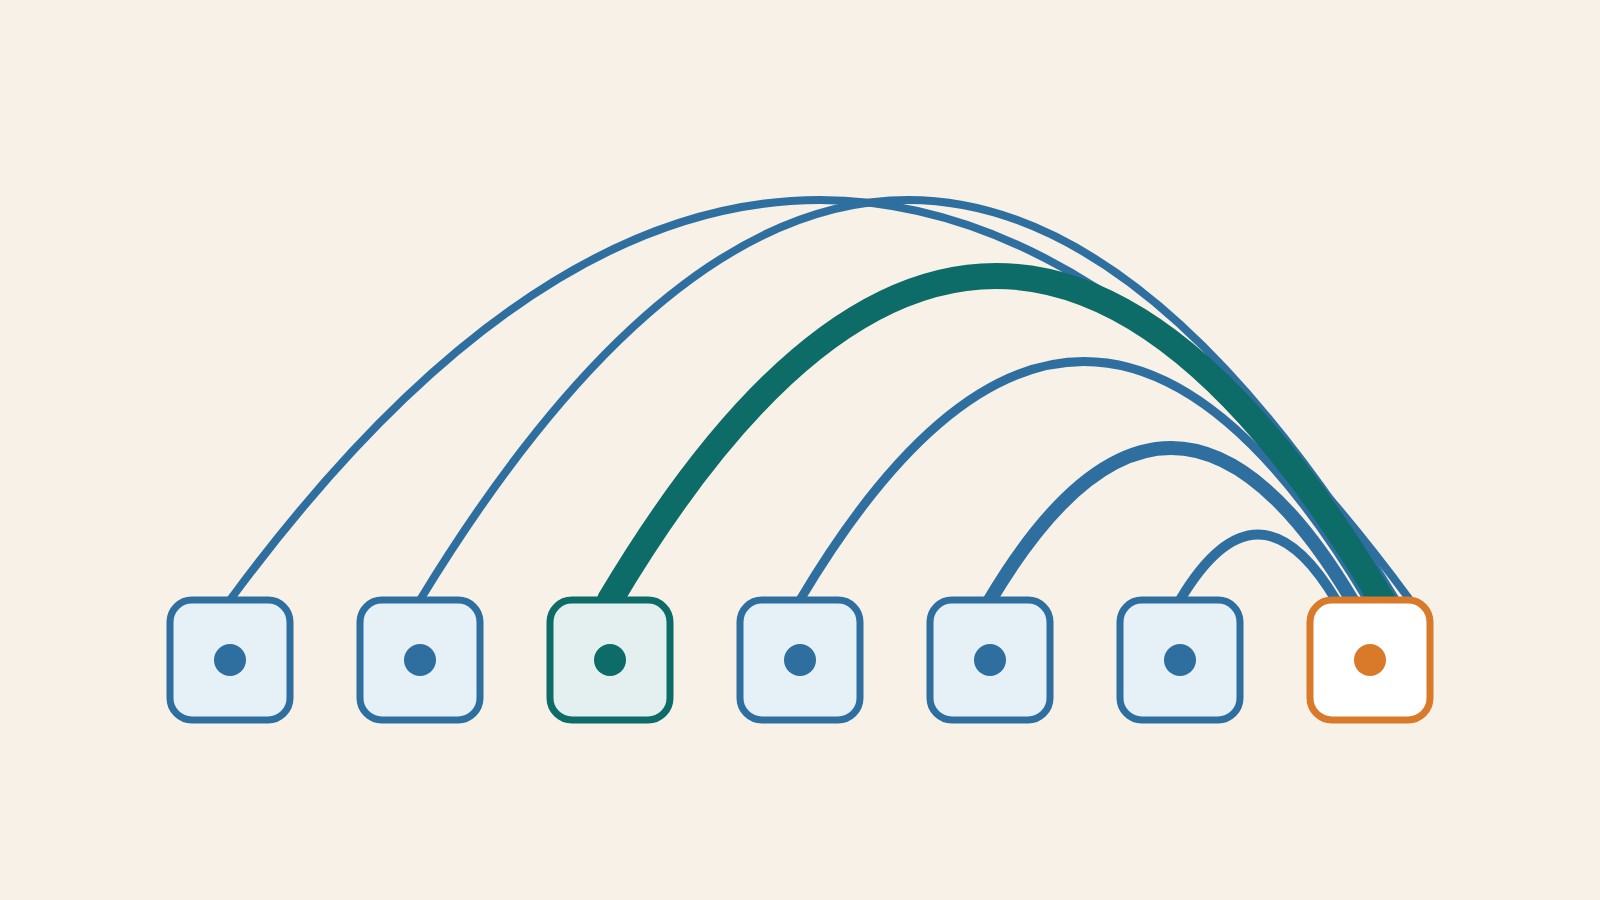
注意力机制让序列中的每个位置,根据 query 与 key 的比对算出权重,再把各位置的 value 加权平均成新的表示。内容从 2014 年的翻译对齐讲到 2017 年的 Transformer,用示例说明 Q、K、V、自注意力、交叉注意力与多头注意力,也讨论标准做法的计算量随长度平方增长,以及注意力权重不能直接当成模型的理由。
- AI 工具
- 教程
- AI 名词解释
生活分享
Transformer 架构(Transformer)是什么
Transformer 是以注意力机制处理序列关系的神经网络架构,也是许多语言与多模态模型的重要基础。本文用活动公告中的代词与语序例子,说明自注意力、位置信息、前馈网络和掩码如何协作,区分原始编码器解码器设计与后来的变体。读完能理解模型如何利用上下文,也知道注意力权重不是人类注意力或完整的决策解释,长序列仍有计算与验证成本。
- AI 工具
- 教程
- AI 名词解释
生活分享
生成式 AI(Generative AI)是什么
生成式 AI 从数据中学到模式,根据输入条件生成文字、图像、声音等内容。本文以社区二手集市宣传素材为例,说明生成与分类、搜索的区别,介绍语言模型、扩散与对抗生成等不同途径,并解析内容看起来合理却可能不忠于事实的原因。读完能把创意需求、必须保留的信息与人工验收分开安排,判断哪些产物仍只是待确认的草稿。
- AI 工具
- 教程
- AI 名词解释
生活分享
神经网络(Neural Network)是什么:由层与权重组成、能从数据学习的函数
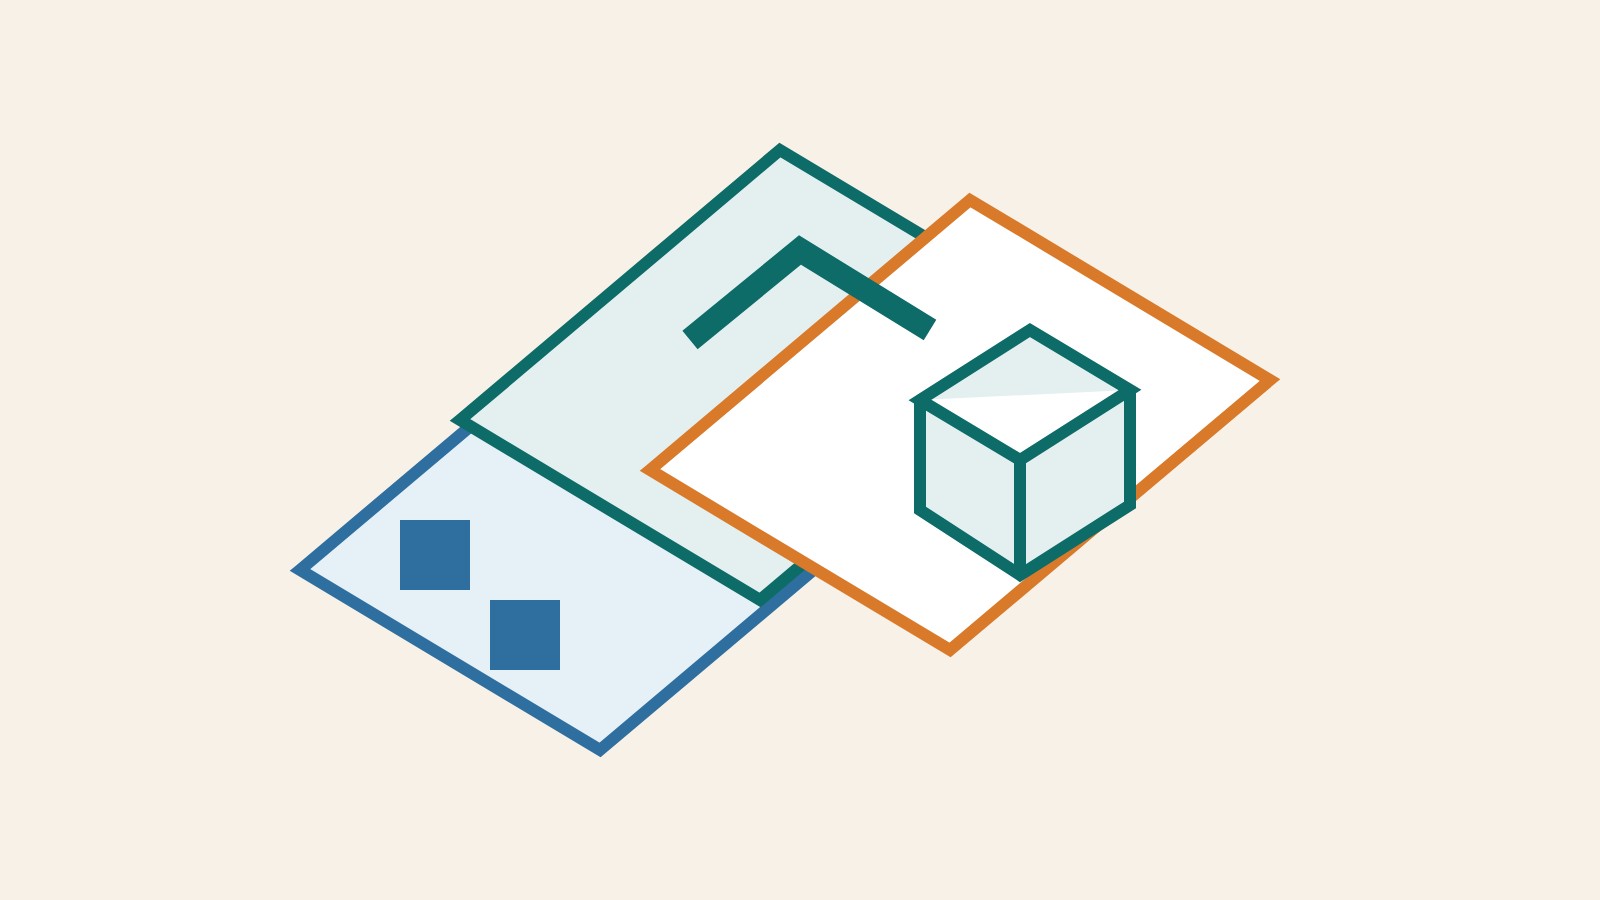
神经网络是由多层简单单元组成的函数:单元做加权求和,多半再经过非线性变换,权重由数据调整。用双开关走廊灯的手算示例,说明前向计算、损失、反向传播与梯度下降,区分训练与推理,并厘清参数数量、神经元数量与能力的差别,以及它与深度学习、Transformer 的关系。
- AI 工具
- 教程
- AI 名词解释
生活分享
深度学习(Deep Learning)是什么
深度学习利用多层神经网络,从数据中学习不同层次的表示,常用于图像、语音与文本任务。本文以回收物照片分类为例,说明隐藏层、非线性、训练和推理的作用,解释模型可能记住背景而非物品,以及数据、算力与可解释性的取舍。读完能分辨深度学习和一般机器学习的关系,也能用新的拍摄条件检查一个模型是否真的学到了有用模式。
- AI 工具
- 教程
- AI 名词解释