生活分享
注意力机制(Attention)是什么:模型怎么决定要参考哪些 token
注意力机制让序列中的每个位置,根据 query 与 key 的比对算出权重,再把各位置的 value 加权平均成新的表示。内容从 2014 年的翻译对齐讲到 2017 年的 Transformer,用示例说明 Q、K、V、自注意力、交叉注意力与多头注意力,也讨论标准做法的计算量随长度平方增长,以及注意力权重不能直接当成模型的理由。
阅读时间约 8 分钟
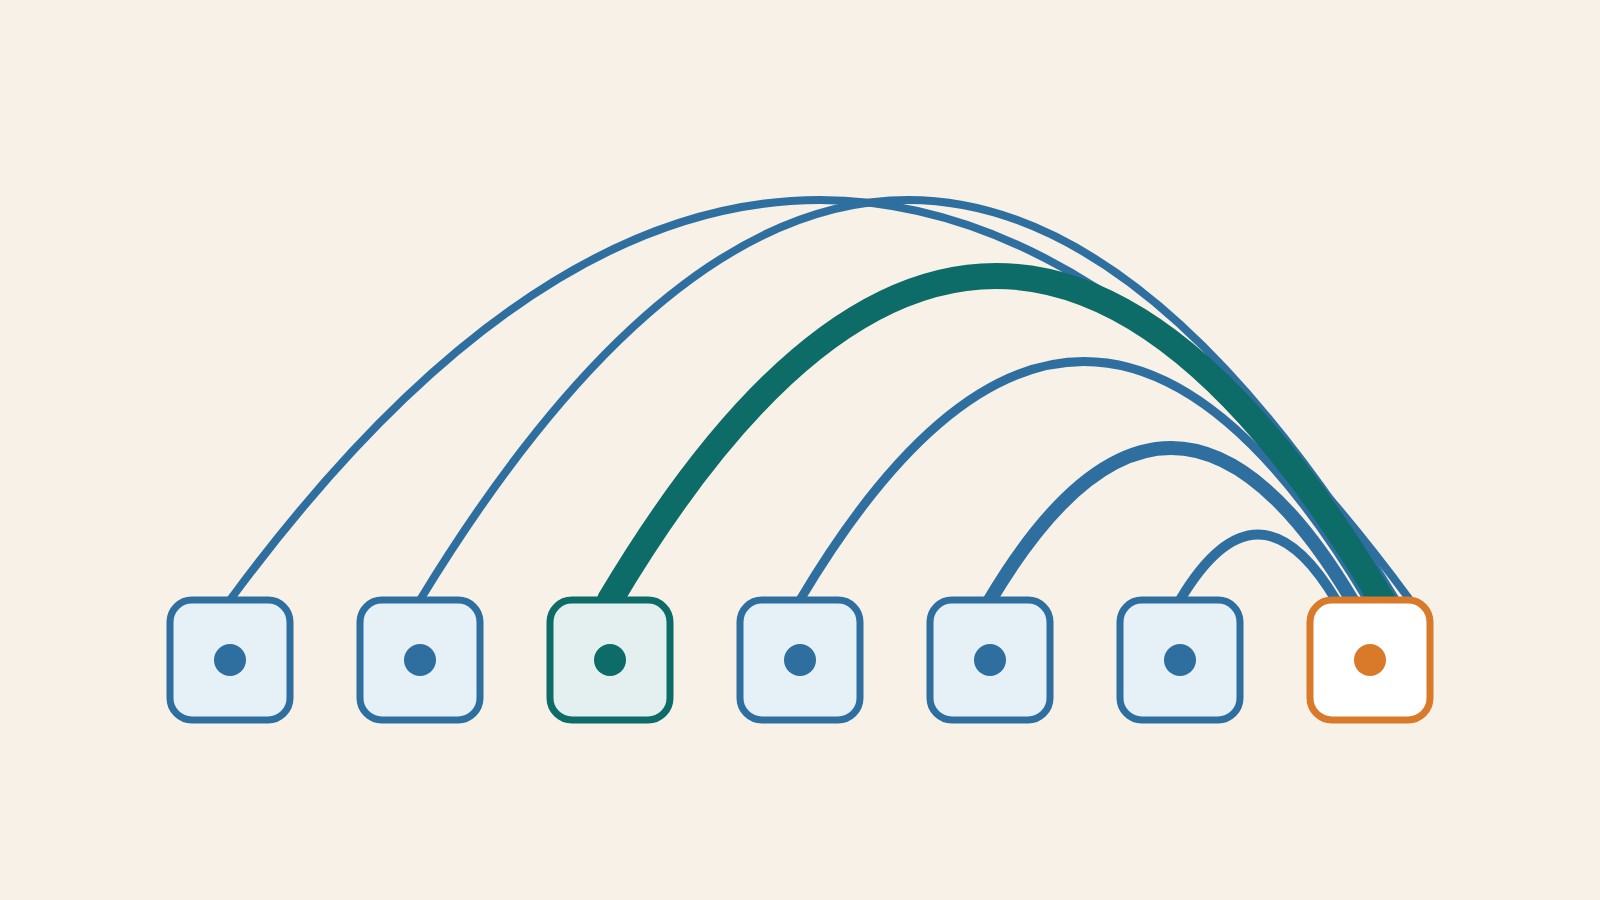
注意力机制(Attention)是一种计算:处理序列中的某个位置时,给它可参考的每个位置(自注意力时也包括它自己)打相关分数,转成总和为 1 的权重,再把各位置的内容加权平均成新的表示。“注意力”是译名,指数学上的加权,不是人类有意识的专注。它让相隔很远的两个词在同一层就能直接比对,代价是标准做法的计算量大约随序列长度的平方增长。
本文从翻译对齐问题讲到 Q、K、V、自注意力与多头注意力,并说明权重为何不能直接理解为“模型的理由”,以及长度与成本的关系。资料截至 2026 年 10 月;标“示例”的内容是为教学编写的,未经实测。
从翻译对齐走到只靠注意力
2014 年 Bahdanau 等人研究机器翻译。当时常见的编码器—解码器架构先把整句原文压成一个固定长度的向量,再生成译文;他们推测这是瓶颈,改为让解码器每生成一个目标词,就对原文各位置的表示打分、转成权重,加权平均得到这一步专用的上下文向量。打分用的是与翻译模型一起训练的小型前馈神经网络神经网络(Neural Network)是什么:由层与权重组成、能从数据学习的函数神经网络是由多层简单单元组成的函数:单元做加权求和,多半再经过非线性变换,权重由数据调整。用双开关走廊灯的手算示例,说明前向计算、损失、反向传播与梯度下降,区分训练与推理,并厘清参数数量、神经元数量与能力的差别,以及它与深度学习、Transformer 的关系。阅读全文。在该论文的英法翻译实验中,基本架构的表现随句长明显下滑,以最长 50 个词的句子训练的对齐版本,在 50 个词以上的句子上也没有下滑,这是该论文设置下的结果。
2017 年 Vaswani 等人指出,当时的注意力大多与循环网络并用,于是提出完全依赖注意力、不用循环与卷积的 Transformer 架构Transformer 架构(Transformer)是什么Transformer 是以注意力机制处理序列关系的神经网络架构,也是许多语言与多模态模型的重要基础。本文用活动公告中的代词与语序例子,说明自注意力、位置信息、前馈网络和掩码如何协作,区分原始编码器解码器设计与后来的变体。读完能理解模型如何利用上下文,也知道注意力权重不是人类注意力或完整的决策解释,长序列仍有计算与验证成本。阅读全文。论文的定义是:把一个 query 和一组“key-value 配对”映射成一个输出;输出是各 value 的加权总和,权重由 query 与各 key 的相容性函数(衡量两者多相符)算出。
Q、K、V:比对、加权、混合
每个位置(语言模型里通常是一个 token)用三组学到的矩阵,分别转换出一个 query、key 和 value 向量。粗略理解:query 是“我要找什么”,key 是“我能被怎样比对”,value 是“被选中时交出的内容”。三者都是学出来的数值,没有人事先给词标好主语或代词。
- query 与每个位置的 key 做内积,得到分数。
- 分数除以 key 维度的平方根;原论文推测,这能避免维度大时内积过大、softmax 的梯度过小。
- 用 softmax 转成非负、总和为 1 的权重。
- 以权重对各位置的 value 加权平均,得到新表示。
示例(教学用,分词仅为示意,未对真实模型测量):“小雅把行李箱放进后备厢,因为它太重了。”处理“它”时,假设权重为行李箱 0.55、后备厢 0.25、小雅 0.10,其余词合计 0.10,总和为 1。“它”的新表示是各 value 的混合,行李箱占最多。
若行李箱与后备厢的权重对调,新表示就偏向后备厢,后面的层可能把“太重”连错对象。真实模型的权重需要提取出来才知道,且它只是混合比例,不是最后答案。
阅读完整文字说明
以“它”为 query,与小雅、行李箱、后备厢和其余词的 key 比对,经 softmax 转成权重,示例权重依次为 0.10、0.55、0.25、0.10,总和为 1;再依权重混合各位置的 value,得到“它”的新表示,其中行李箱的内容占最多。权重是教学示例,不是实测。
自注意力与交叉注意力
两者差在 query、key、value 的来源,计算方式相同。自注意力(self-attention)的三者来自同一个序列。交叉注意力(cross-attention,原论文称 encoder-decoder attention)的 query 来自解码器,key 与 value 来自编码器输出;Bahdanau 等人的机制也是解码器去查原文,只是用小型网络而非内积打分。解码器的自注意力另加掩码,只让位置看到自己与之前的位置。
多头注意力在做什么
多头注意力(multi-head attention)以各自学到的投影,把 query、key、value 转成 h 组较小的向量,每组并行做注意力,再拼接并投影回原维度。原论文基本设置是 8 个头、每头 64 维、模型维度 512,总计算量与单头全维度相近;作者的理由是多头让模型能同时从不同表示子空间、不同位置取用信息,只用单头时,加权平均会妨碍这一点。
但这不表示每个头固定负责一种语义。该论文的英德翻译消融实验(总计算量固定)显示,单头比最佳设置差,头数过多质量也会下降。附录图画出编码器第 5 层(共 6 层)两个头处理英文代词 its 的权重,作者说它们“似乎”与代词指代有关,但这是对特定模型、层与句子的观察,不保证换个模型会重现。
注意力权重不等于模型的理由
权重常被画成热力图,像在说“模型因为这几个词才这样答”。Jain 与 Wallace(NAACL 2019)检验过这个直觉:他们用带注意力的双向 LSTM,做英文的文本分类、问答与自然语言推理。结果是循环编码器的注意力权重,和另外两种衡量“哪个词重要”的指标(梯度、移除单词后的输出变化)相关性偏弱且不一致;固定其他参数,常能另外构造出重心不同、预测却几乎不变的权重。他们主张标准注意力不该被当成有意义的解释。
Wiegreffe 与 Pinter(EMNLP 2019)以双重否定的标题回应。他们认为相关性那部分的实验有说服力,争议在后半:结论取决于“解释”的定义,要求忠实反映模型的运算,和只要求让人看得懂、说得通,是两种标准;构造反例时也不能只动权重而不顾模型其余部分。他们改为连同整个模型一起训练,找出重心不同的“对抗”权重,再把它当成固定权重,交给看不到上下文的简单诊断模型使用:四个英文二元分类数据集中,有三个的成绩明显不如用原本学到的权重;剩下一个两者相当,作者认为与该数据集的数据特性有关。他们据此主张,先前工作并未证明注意力无助于解释;不过他们也确认,某些分类任务上的确找得到这种对抗权重,只是不像先前做法找到的那么极端。
两篇主要研究带注意力的循环模型与英文任务,没有直接检验如今的大型 Transformer 语言模型,结论都不能直接外推。稳妥的说法是:权重描述某层某个头混合内容的比例,后面还有许多层,单张权重图不足以当成答案的因果来源。
序列变长时的成本与上下文窗口
标准自注意力让每个位置和每个位置配对,n 个 token 有 n 乘 n 个分数,长度加倍,配对数约变四倍。原论文的表 1(见下表,n 为序列长度,d 为表示维度)比较了几种层:自注意力的运算量随 n 平方增长,但任意两个位置的最长路径是常数级,再远的两个词,一层就能直接比对;循环层的路径则随 n 增长。
| 层类型 | 每层运算量 | 任意两位置的最长路径 |
|---|---|---|
| 自注意力 | O(n²·d) | O(1) |
| 循环层 | O(n·d²) | O(n) |
| 只看邻近 r 个位置的自注意力 | O(r·n·d) | O(n/r) |
这是输入变长时,运算与内存需求跟着升高的原因之一,但实现各有不同:FlashAttention 论文同样指出自注意力的时间与内存复杂度对长度是平方,并提出一种“精确”(exact)算法:数学上算的仍是同一个注意力,只是靠减少 GPU 内存的读写来加快,所以实际速度不能只用平方公式推算。窗口放得下,也不等于用得好:Liu 等人(TACL 2024)在多文档问答与键值查找的实验中观察到,相关信息位于长输入的中段时,表现往往明显不如放在开头或结尾。另见上下文窗口。
逐个 token 生成时,Hugging Face 官方文档说明可用 KV 缓存:存下先前 token 的 key 与 value,每步只算新 token 的,代价是内存随序列长度线性增加。
想继续阅读相关名词,可从 AI 名词总索引 开始。
觉得这篇整理实用吗?分享给需要的朋友
同主题延伸阅读
生活分享
代理式检索增强生成(Agentic RAG):何时需要再查一次
代理式检索增强生成让模型参与检索决策,根据问题与已找到的证据选择数据来源、改写查询或继续补查。本文采用 LangGraph 文档中的具体流程,以比较场地借用条件示范它和固定式 RAG 的差别,并说明停止条件、权限、查询记录及成本控制。读完能判断任务需要动态探索,还是用可预测的固定流程就足够。
生活分享
图谱检索增强生成(GraphRAG):从关系看懂整批文档
GraphRAG 把实体及其关系纳入检索,帮助回答跨文档的关联与整体主题。本文以 Microsoft 原始论文及官方文档为范围,拆解实体抽取、社区摘要、局部搜索和全局搜索,以地方活动记录示范不同问题需要不同路径。也说明图谱漏连、名称误合并与摘要失真如何影响答案,避免把一张漂亮的关系图误认为已验证的事实。
生活分享
知识图谱(Knowledge Graph):把事物与关系说清楚
知识图谱用实体及关系组织数据,让“谁参与什么、在哪里、何时发生”能沿链接查询。本文以社群活动数据演示实体识别、关系方向、来源与时间,介绍资源描述框架(RDF)和属性图的表示差异,也说明图谱不等于可视化或可信事实。读完能判断数据适不适合建图,并理解它如何与数据表、向量搜索及图谱检索增强生成(GraphRAG)搭配。
生活分享
混合搜索(Hybrid Search):兼顾精确字词与语义
混合搜索将全文搜索与向量等不同检索结果合并,兼顾精确代码和自然语言需求。本文用设备说明书查询拆解候选获取、去重、排名融合和重新排序,介绍倒数排名融合(RRF)如何用名次融合不同搜索结果,也提醒混合不保证全面更准。读完能用代码题、改写题和无答案题检查质量,并辨认权限、筛选与重复内容造成的偏差。
资料来源
- Bahdanau、Cho、Bengio:通过联合学习对齐与翻译实现神经机器翻译(arXiv:1409.0473,ICLR 2015)查证日期:
- Vaswani 等:注意力就是你所需要的一切(arXiv:1706.03762)查证日期:
- Jain、Wallace:注意力不是解释(arXiv:1902.10186)查证日期:
- ACL Anthology:注意力不是解释(NAACL 2019,N19-1357)查证日期:
- Wiegreffe、Pinter:注意力并非不是解释(arXiv:1908.04626)查证日期:
- ACL Anthology:注意力并非不是解释(EMNLP 2019,D19-1002)查证日期:
- Dao 等:FlashAttention:具备 IO 感知能力、快速且节省内存的精确注意力(arXiv:2205.14135)查证日期:
- Liu 等:迷失在中间:语言模型如何使用长上下文(arXiv:2307.03172,TACL 2024)查证日期:
- Hugging Face Transformers 官方文档:缓存的工作原理(KV 缓存)查证日期:
本文依据上方所列参考来源与标示之核实日期整理;票价、时刻、功能规格或服务条款可能变动,出发、预订或购买前请至相关官方网站确认最新信息。